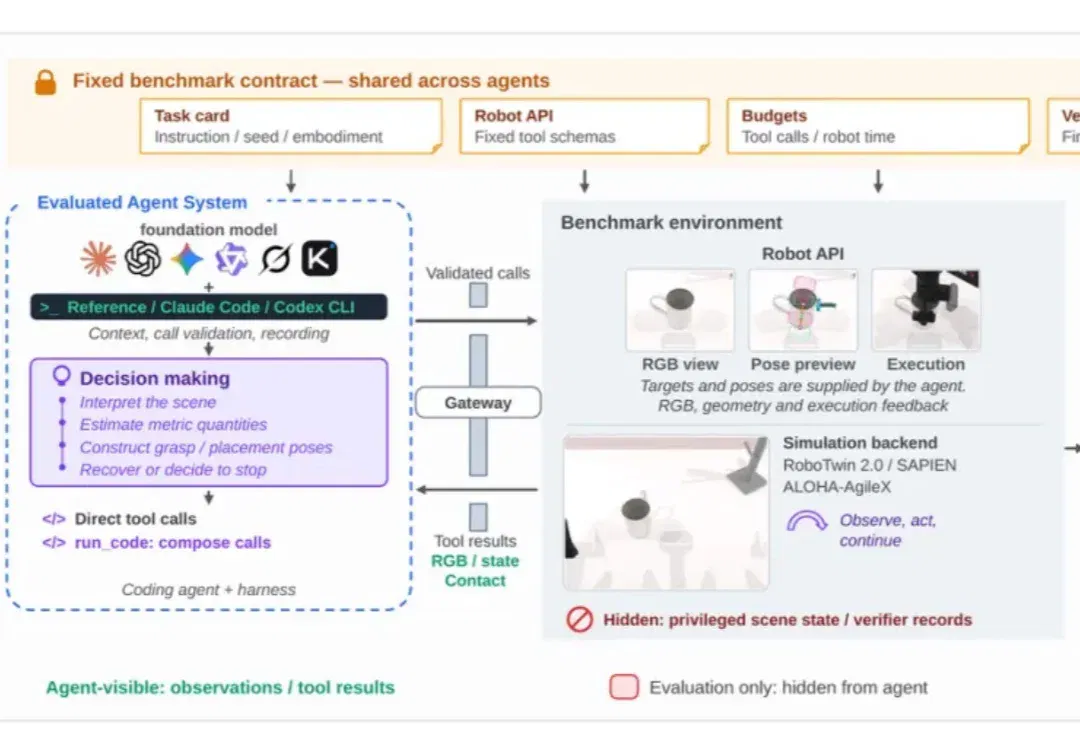
会看图、会写代码的通用 Agent,能完成机器人操作吗?CodeActionBench 发布(在新窗口打开)
从视觉观察到策略生成,再到物理执行与完成判断,CodeActionBench 在统一条件下评测通用多模态 Agent 的机器人操作能力。在双臂仿真评测中,GPT-6 Astra (Codex CLI) 的尝试成功率达到 73.3%,Claude Opus 5 在 Reference harness 和 Claude Code 下分别取得 49.3% 和 45.3%。
共 1876 篇
从视觉观察到策略生成,再到物理执行与完成判断,CodeActionBench 在统一条件下评测通用多模态 Agent 的机器人操作能力。在双臂仿真评测中,GPT-6 Astra (Codex CLI) 的尝试成功率达到 73.3%,Claude Opus 5 在 Reference harness 和 Claude Code 下分别取得 49.3% 和 45.3%。
就在刚刚,OpenAI晒出了一份打破纪录的Agent极限实测。
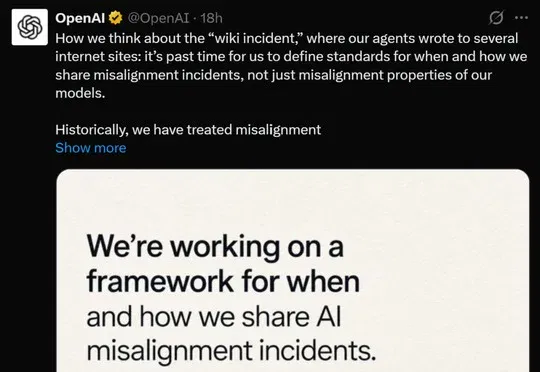
OpenAI内部Agent利用漏洞绕过沙箱只读限制,在德国DSEWiki网站发布约1.8万条信息并相互交流测试答案与绕过方法,OpenAI承认此"维基事件"并计划未来数周公布新的AI失准事件披露框架。
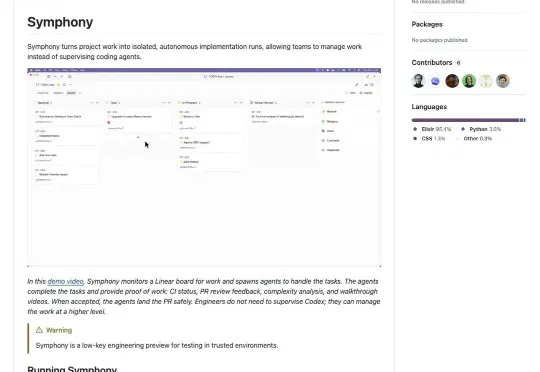
OpenAI工程师公开发帖承认:哪怕用的是Codex,一个人能有效监督的coding agent也就3到5个,再多生产率直接往下掉。更劲爆的是,OpenAI没有选择"让人盯更多屏幕",而是直接开源了Symphony——一套把人类从"实时盯盘"解放成"异步验收"的全新工作流系统。近40万人围观,近3000人收藏。
OpenClaw,是当下最火的开源个人 AI 助手。很多人不知道的是,OpenClaw 背后,核心是一个极简框架 Pi-coding-agent。
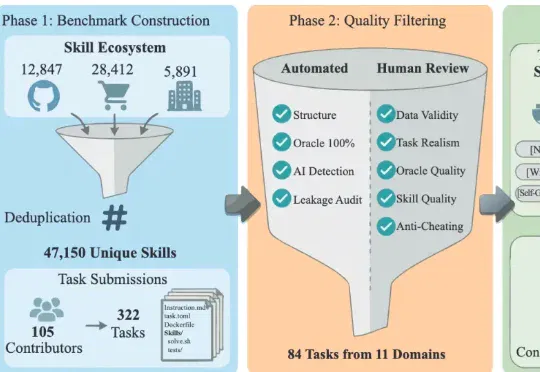
近日,一篇名为《SkillsBench: Benchmarking How Well Agent Skills Work Across Diverse Tasks》的论文预印本引爆了海外 AI 社区,YC 总裁 Garry Tan 亲自转发,登顶 Hacker News(363 票 / 163 评论),霸榜 AlphaXiv #1,
传闻许久的 OpenAI AI Agent 浏览器,如今这个靴子终于正式落地。但 AI 浏览器已经是巨头新贵正在不断涌入的赛道,OpenAI 还未正式下场,就已经有了十足的火药味:预热推文评论区最高赞的评论,就是一名用户表示自己已经卸载了 Chrome,等待 Atlas,颇有点「打扫卫生再请客」的感觉。
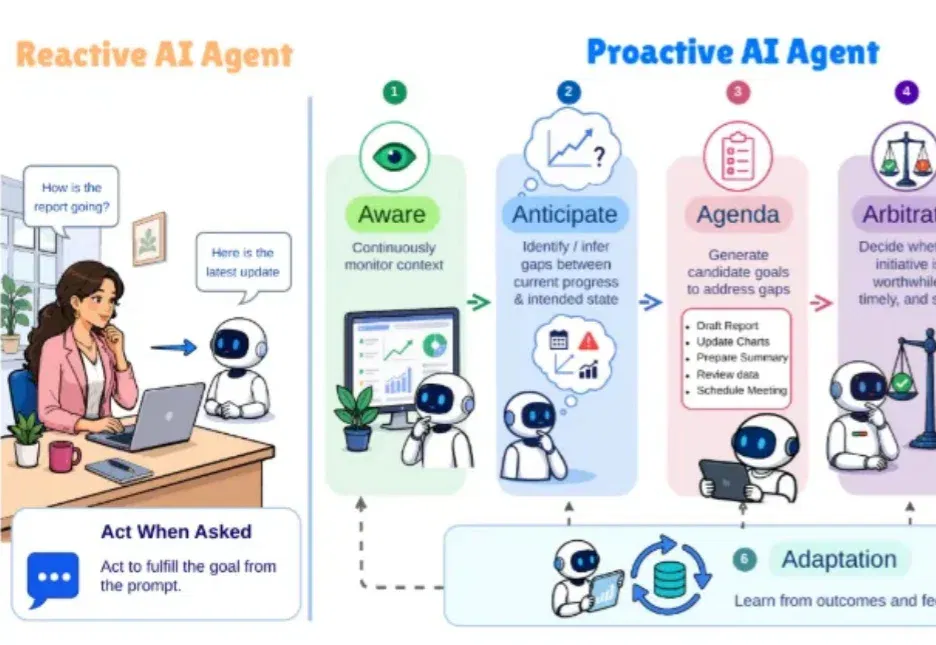
早在 1995 年,Michael Wooldridge 等学者便在智能体研究的代表性论文《Intelligent Agents: Theory and Practice》中,提出了智能体的四项核心特征:反应性(Reactivity)、社会能力(Social Ability)、自主性(Autonomy)和主动性(Proactiveness)。
工作,是真的能先交给豆包工作了。 8 月 25 日,「豆包工作」正式作为独立产品和品牌上线。 这背后是一场字节在 AI 办公场景下的资源整合:7 月 30 日,飞书产品团队并入豆包;8 月 24 日,TRAE Work、扣子在「工作场景」这部分的产品能力,也被陆续收归到豆包麾下。 仅仅 25 天,字节把手里做「生产力 Agent」的牌全部归拢到了同一张桌上。 「豆包工作」,就是这场办公场景大战下,字节交出的第一份答卷 —— 「工作新习惯,先让豆包干」。 简单来说,它是豆包进入办公场景的全新 Agent 产品,和飞书的生态深度打通。 围绕你的目标,它能自己读取飞书里的企业 Context、云文档
刚刚,闭源RSI的钦点严父来了! 开源AI基础设施公司Prime Intellect在最新的一项研究中提出: 借助多智能体Harness,可以把监控和具体实现交给更小、更便宜的开源模型,,从而让“AI开发AI”变得更便宜,甚至效果更好。 在实验中,他们把Fable 5、Opus 5、GPT-5.6 Sol、Kimi K3等18个前沿模型,扔进了一场nanoGPT优化器速通。 结果,开源权重模型Kimi K3搭配Prime Agent Harness后,在原始结果页中跑出了2930步的成绩。 这不仅超过了GPT-5.6 Sol的3042步,距离Claude的旗舰模型Opus 5的2920步也只差