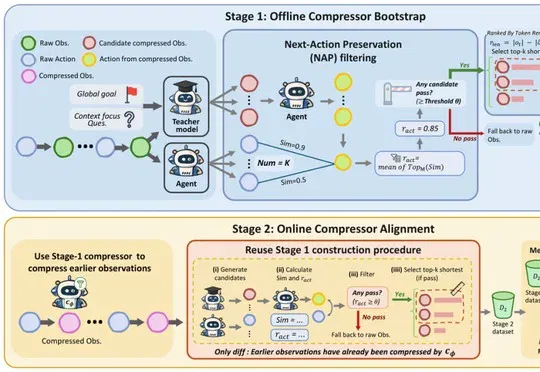
CoACT 按下一步动作压缩工具输出,测试减少智能体 Token 消耗(在新窗口打开)
清华团队在SWE-bench Verified的200个实例和三款模型上评估压缩,平均总Token消耗减少33%,任务成功率总体相近。
共 917 篇
清华团队在SWE-bench Verified的200个实例和三款模型上评估压缩,平均总Token消耗减少33%,任务成功率总体相近。
极客公园梳理手表、录音卡和随身设备,讨论系统入口、记忆筛选与接口整合;半年窗口是作者对竞争节奏的预测。
作者整理多家企业的判断模型案例,比较延迟、成本及失误,并指出有限选项、阈值校准和人工复核的适用边界。
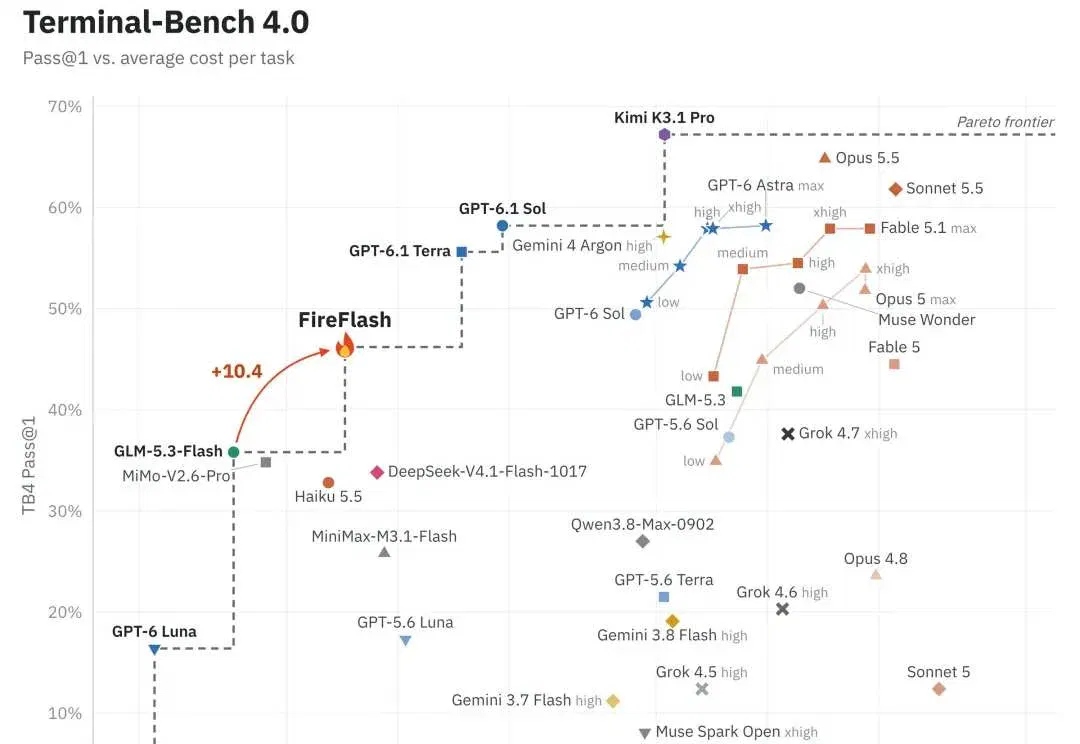
团队从 GLM-5.3-Flash 进行后训练,结合任务筛选、异步采样和统一运行框架,在终端及软件工程基准报告成绩与估算成本。
赛博禅心以互联网指标演变为背景,讨论个人智能体的委托量、完成率和收入关系,并指出托管口径仍需明确。
据公司与投资方披露,本轮包括员工股份出售安排,资金将投入模型评估、后训练基础设施及智能体工作环境。
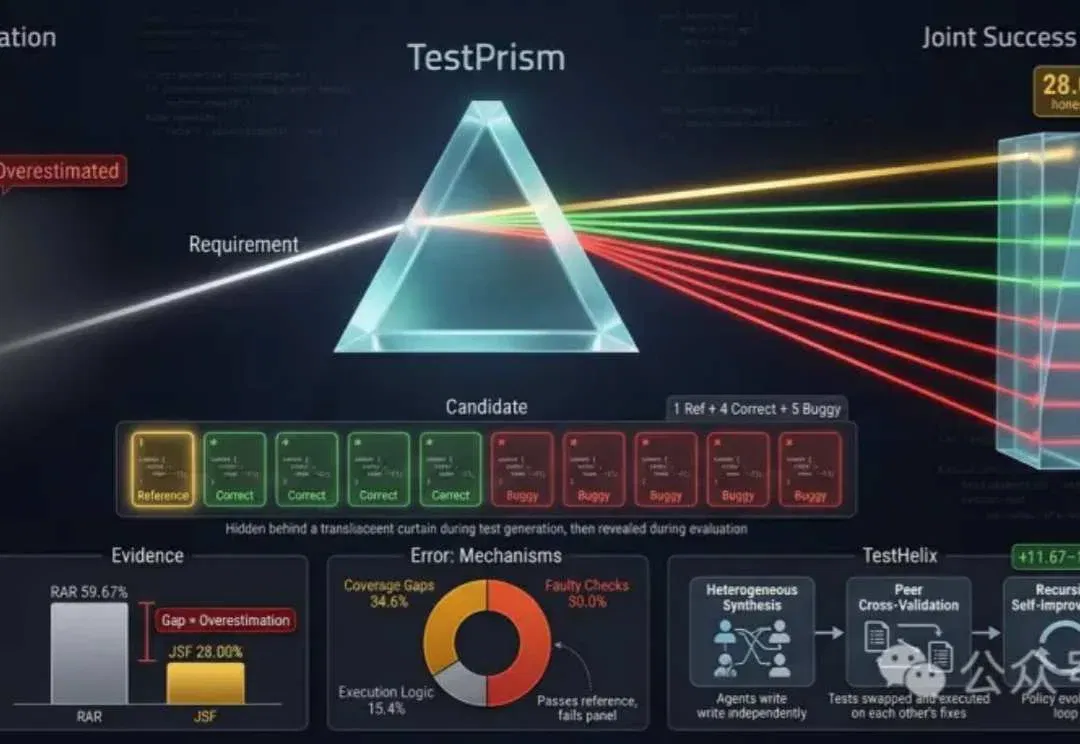
研究用正确替代实现和错误实现共同检验测试,最强受测配置的联合成功率为28%;TestHelix 通过交叉验证改进结果。
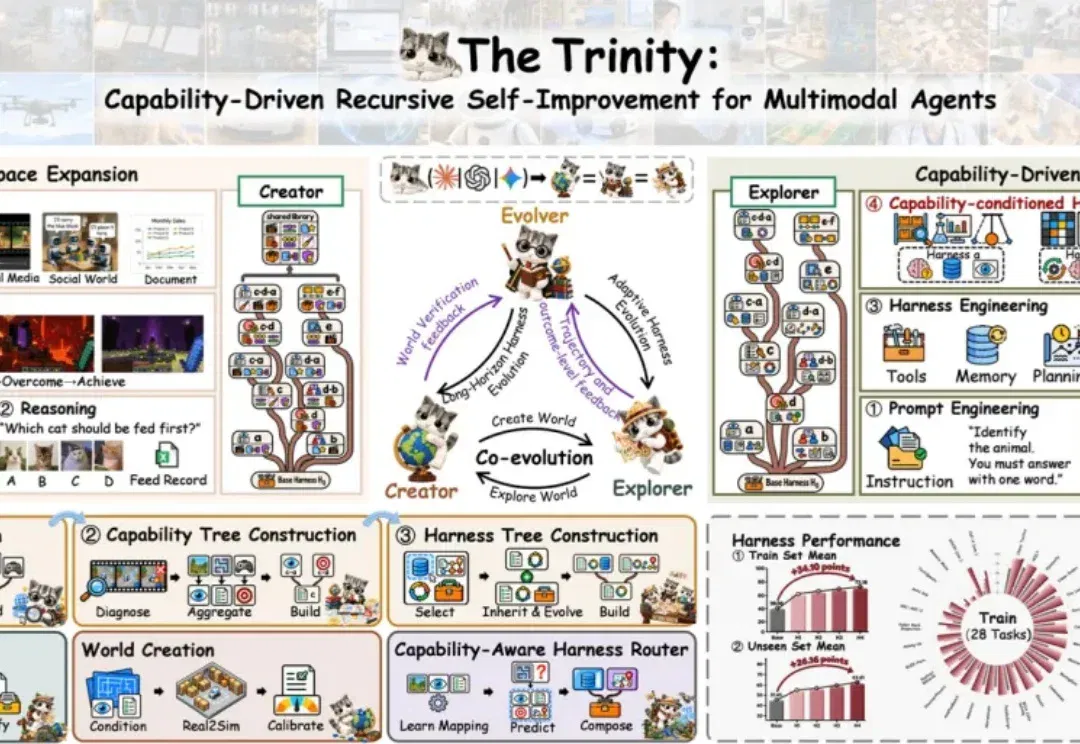
团队让环境生成、探索和框架改进三个角色协作,在固定基座模型下迭代运行框架。论文报告四轮实验和两个真机任务的迁移结果。
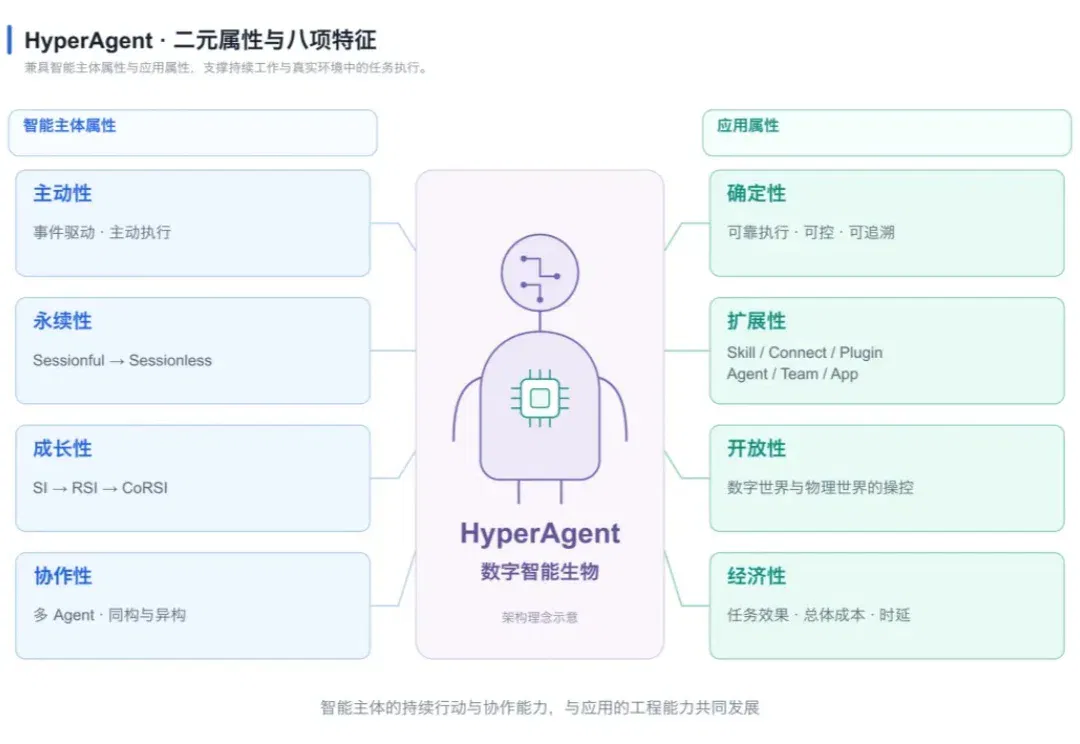
openJiuwen 解读 HyperAgent 的八项特征与 AgentOS 分层,介绍持久状态、多智能体协作和分布式运行,并区分已实现能力与后续架构方向。
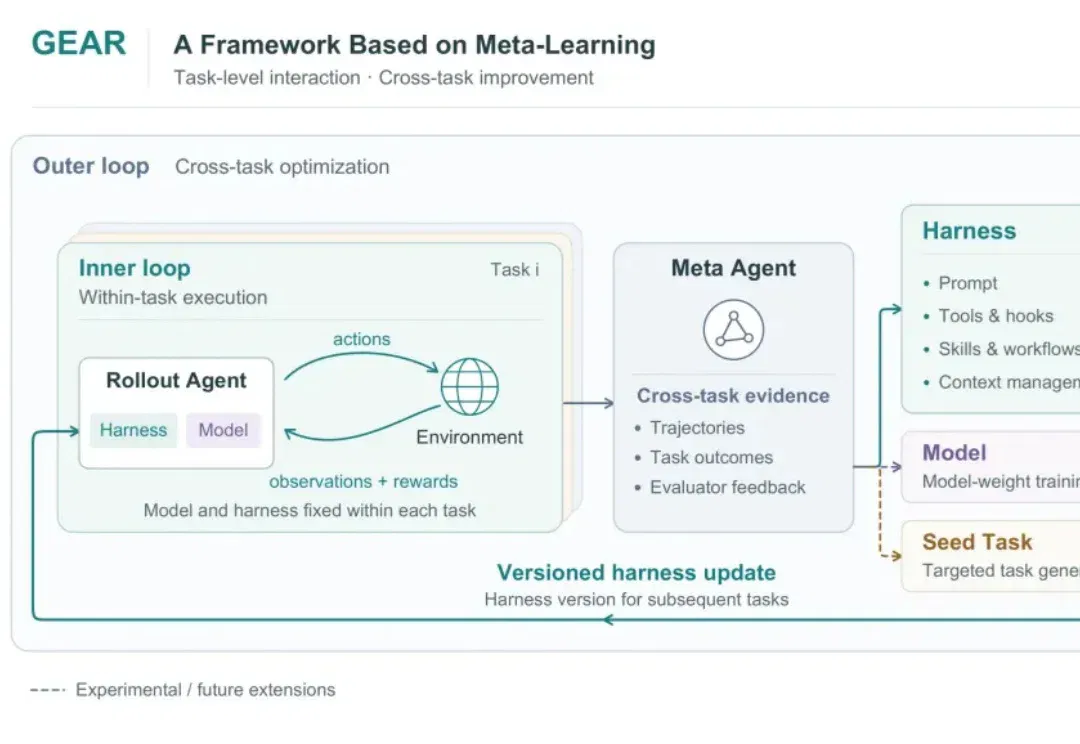
GEAR 将采样、候选评测和多样性管理组织为模块。在固定模型和推理档位的对照中,改进后的运行框架在营销、客服和代码任务上提高了通过率。