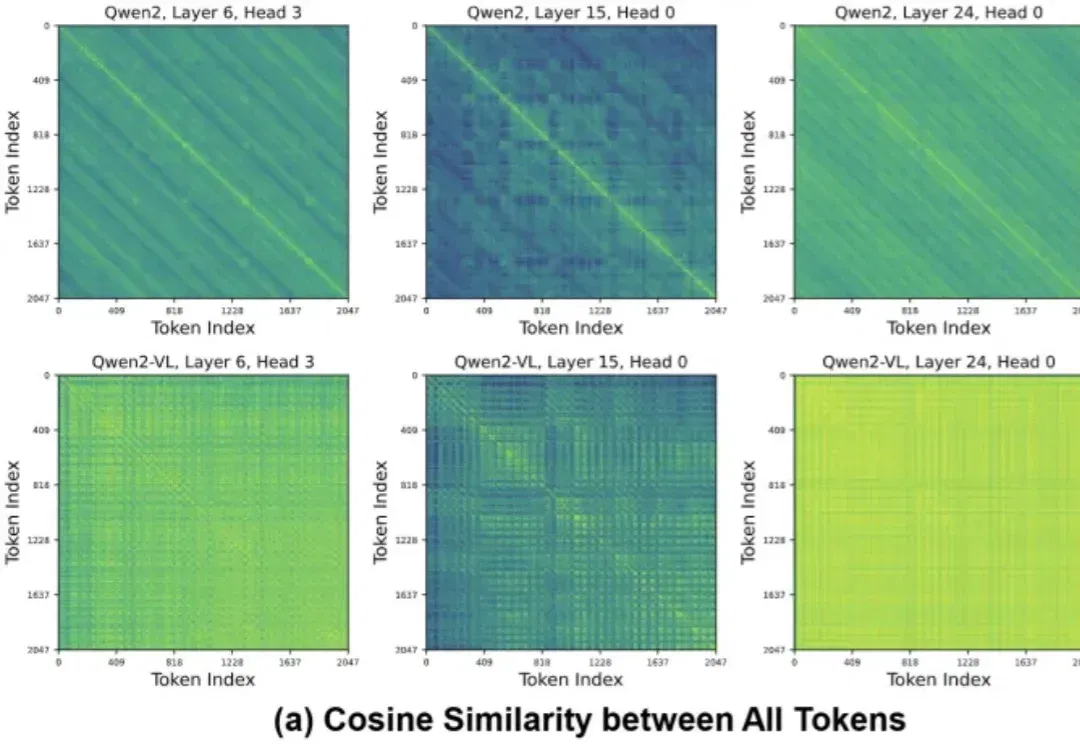
2倍提速!KV缓存压缩不只看重要性,上交大团队让模型推理「又快又稳」 | ICLR'26(在新窗口打开)
长上下文推理已经成了VLM/LLM的默认形态。
共 68 篇
长上下文推理已经成了VLM/LLM的默认形态。
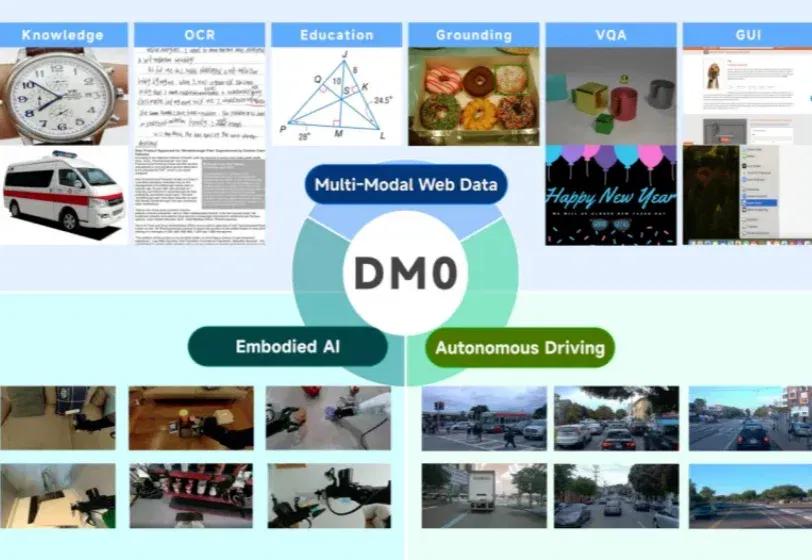
当前,大语言模型(LLMs)和视觉语言模型(VLMs)在语义领域的成功未能直接迁移至物理机器人,归根结底在于其互联网原生的基因。
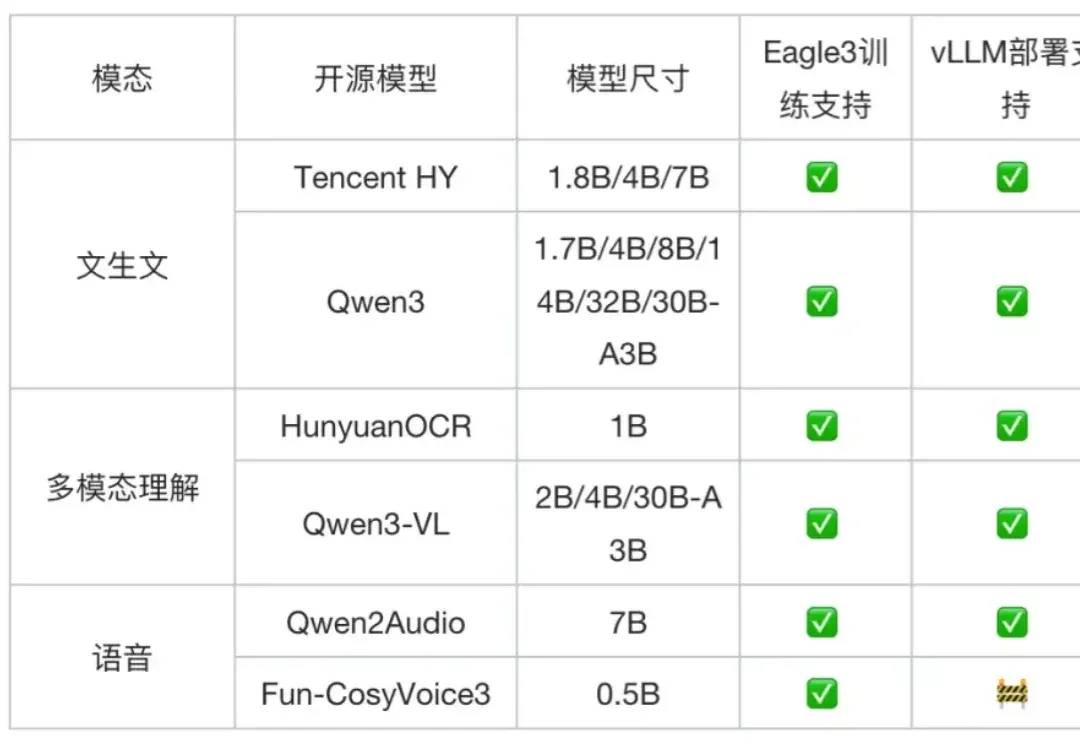
随着大模型步入规模化应用深水区,日益高昂的推理成本与延迟已成为掣肘产业落地的核心瓶颈。在 “降本增效” 的行业共识下,从量化、剪枝到模型蒸馏,各类压缩技术竞相涌现,但往往难以兼顾性能损耗与通用性。
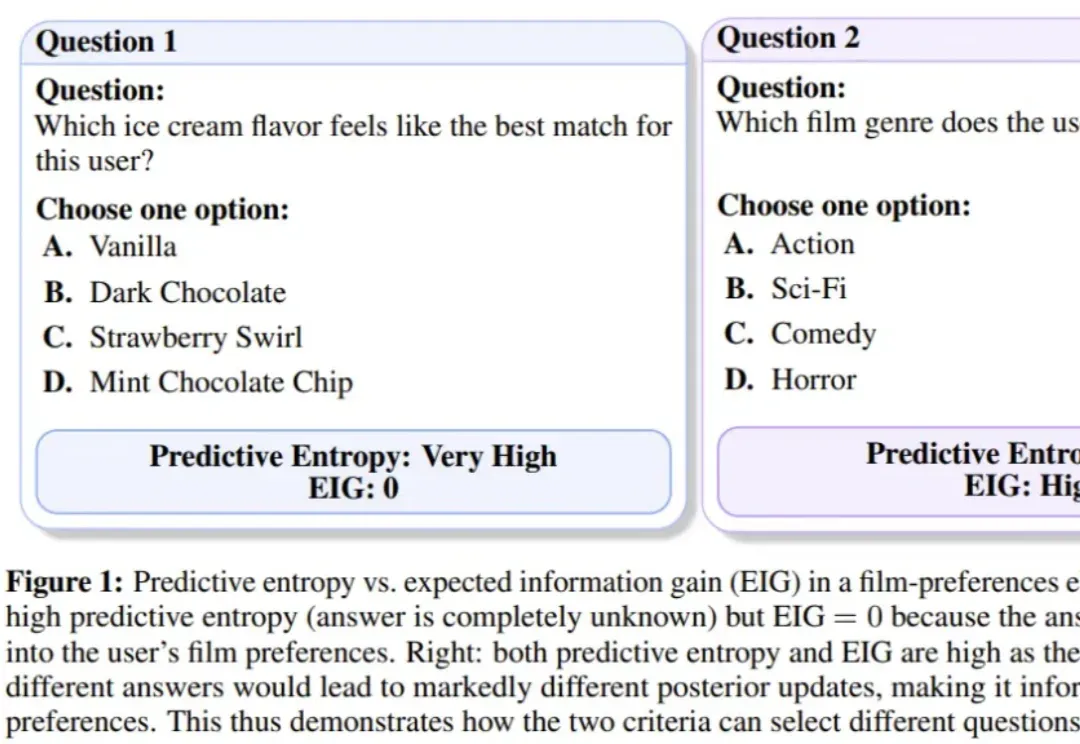
在这场以大型语言模型(LLM)为核心的 AI 浪潮中,苹果似乎一直保持着低调,很少出现在技术报道的前沿。尽管如此,时不时地,该公司也能拿出一些非常亮眼的研究成果,比如能在 iPhone 上直接运行的高效视觉语言模型 FastVLM。
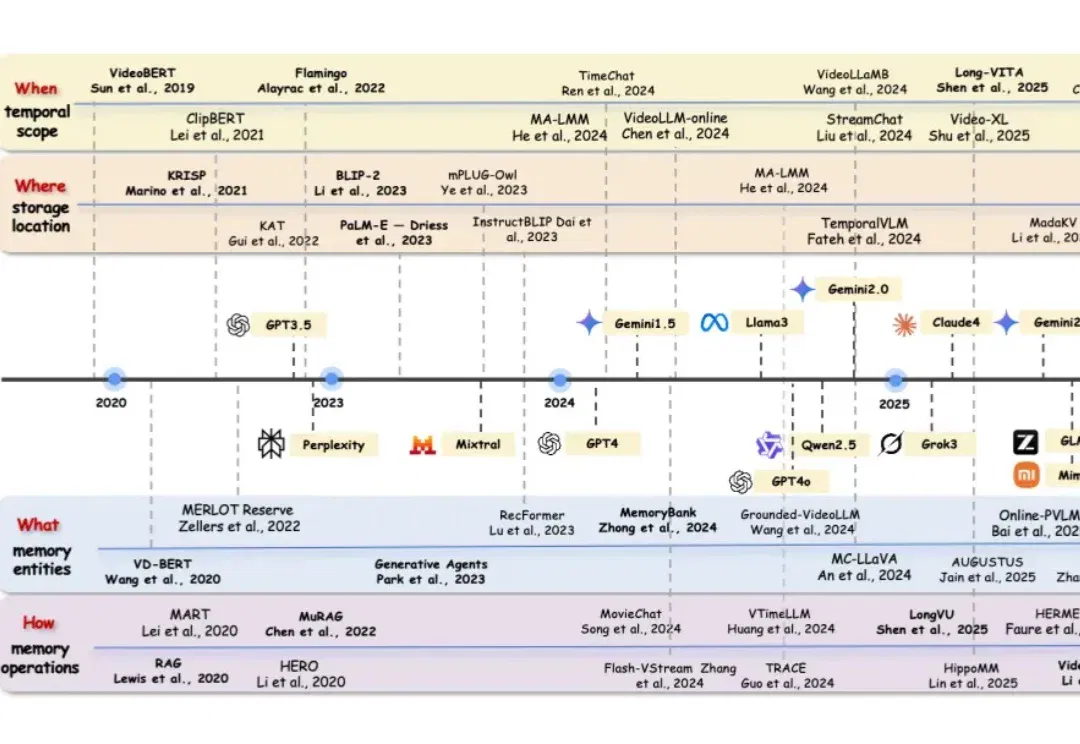
团队整理300余篇工作与近70项基准,覆盖视频、具身、多模态检索和个人助手,讨论压缩、证据追溯与过时信息风险。
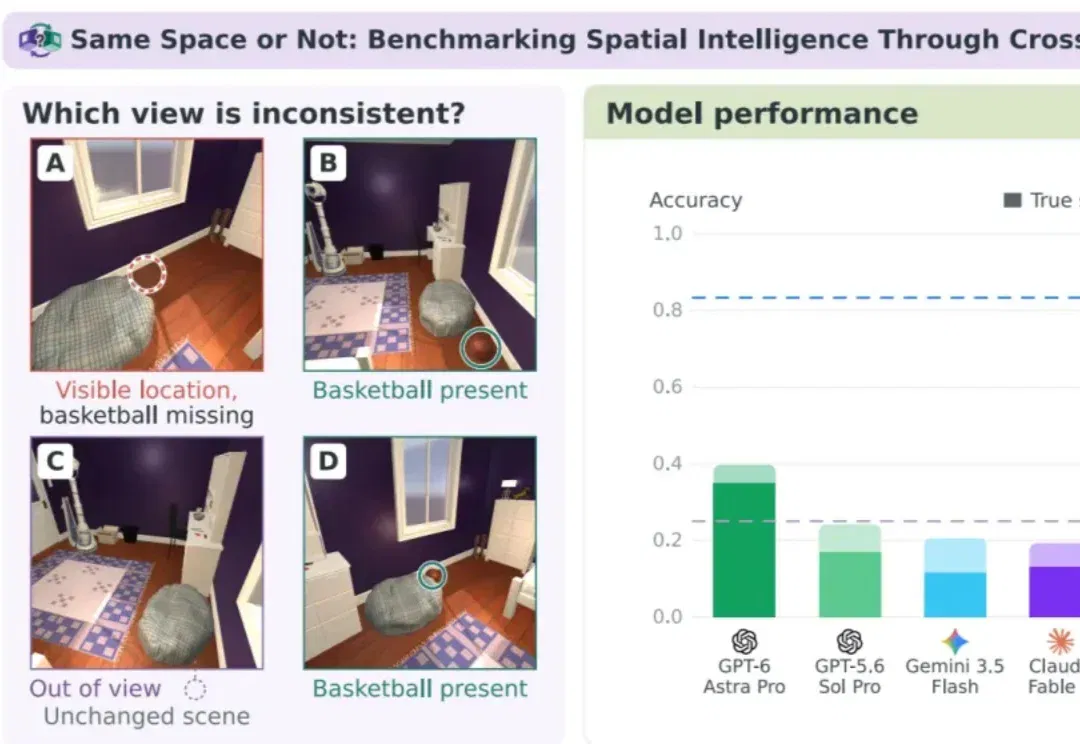
普林斯顿AI Lab等团队提出SSoN:用四张室内图像判断哪张违反同一场景的空间一致性。1000题上,人类准确率83.3%,六个受测VLM最高39.7%;解释核验、相机信息干预和定向微调进一步揭示跨视角推理的短板。
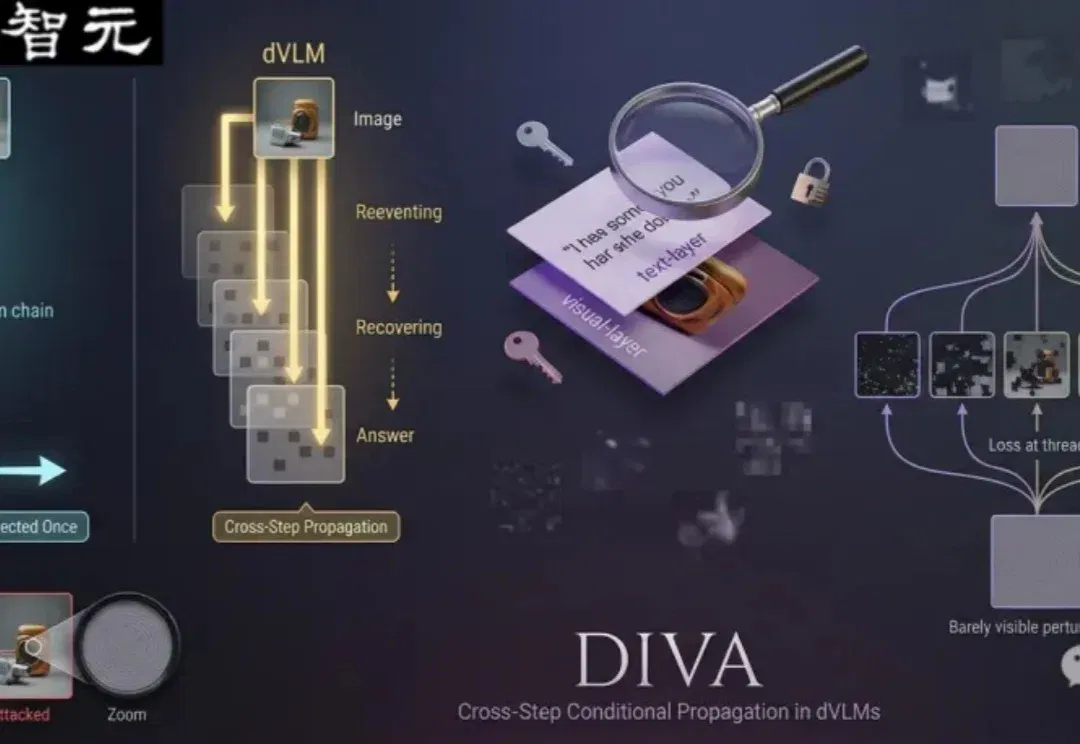
视觉语言模型已经进入办公助手、内容审核、机器人和智能终端等场景。
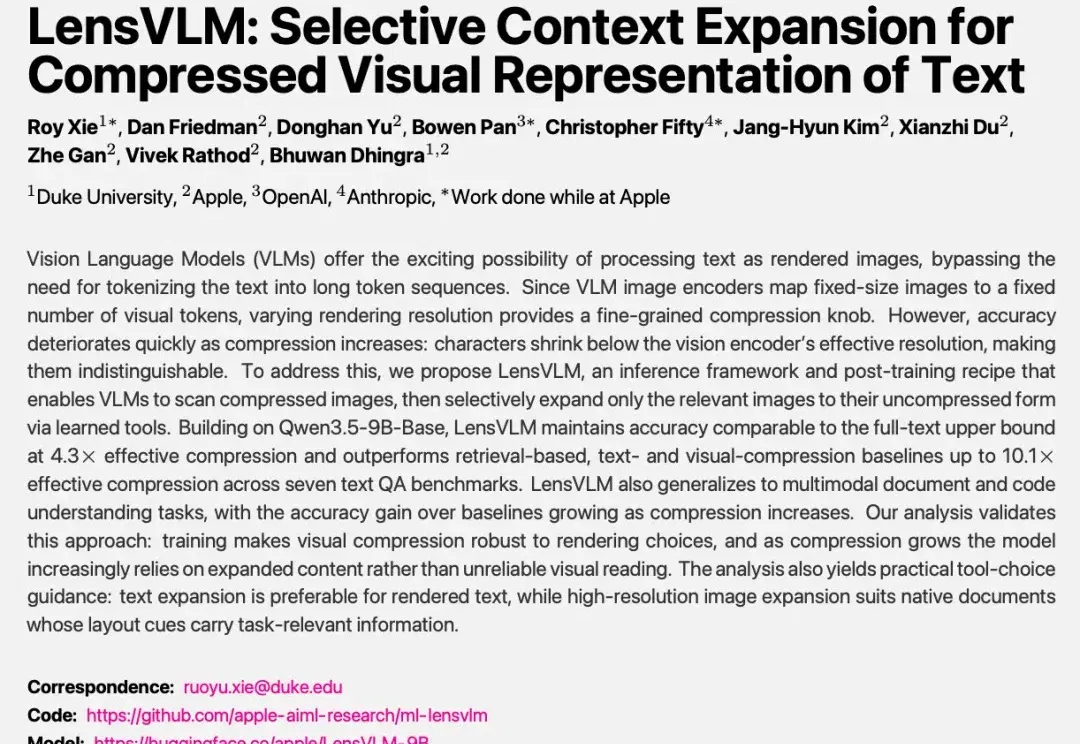
Agent 执行长程任务时,代码、工具输出和交互记录不断累积,上下文也跟着变长。
字节Seed团队推出Seed-Evolving第五版更新,通过统一Model ID实现周级自动迭代,在Coding Agent长程任务完成度和VLM视觉理解能力上均有显著提升,用户一次接入即可享受模型持续进化。
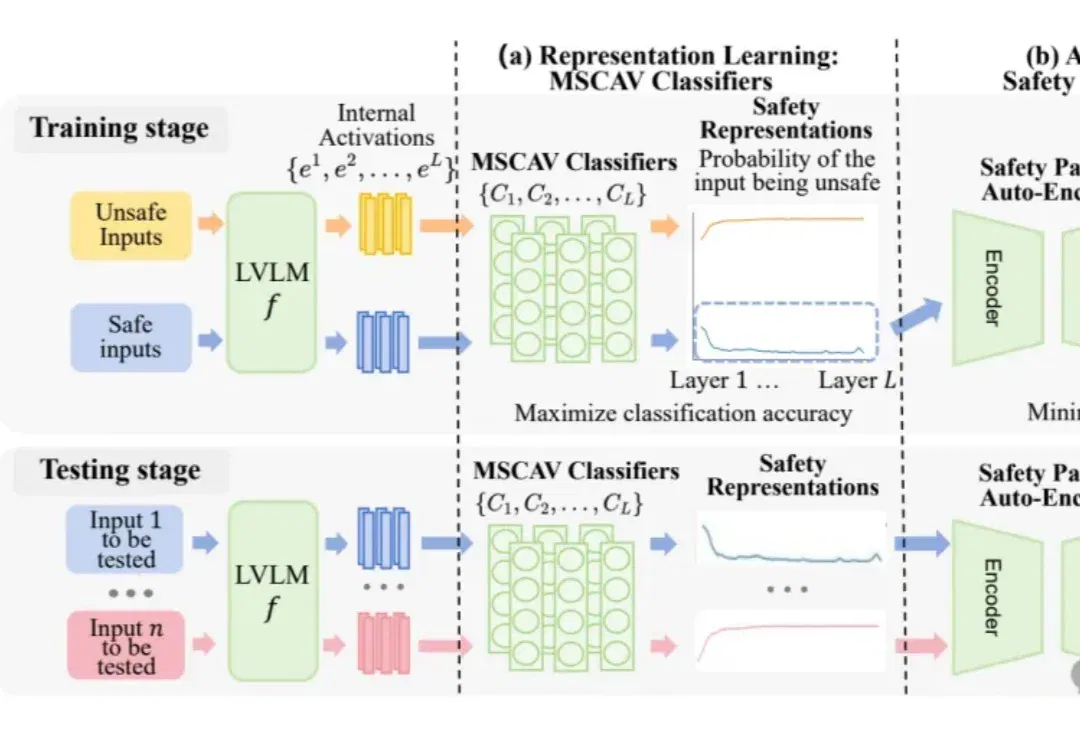
大视觉语言模型(LVLM)把语言理解扩展到了图像等多模态输入,同时,也带来了更隐蔽的攻击面。