六位顶尖学者、三大挑战赛道——IROS 2026 Physical World Models Workshop征稿(在新窗口打开)
2026年10月1日,IROS 2026 Workshop——Physical World Models for Scaling Embodied AI将在美国匹兹堡举行。论文征集现已开放,8月10日截止;WorldArena 2.0 Challenge三大赛道已于7月10日开赛,总奖金$7500。
共 111 篇
2026年10月1日,IROS 2026 Workshop——Physical World Models for Scaling Embodied AI将在美国匹兹堡举行。论文征集现已开放,8月10日截止;WorldArena 2.0 Challenge三大赛道已于7月10日开赛,总奖金$7500。
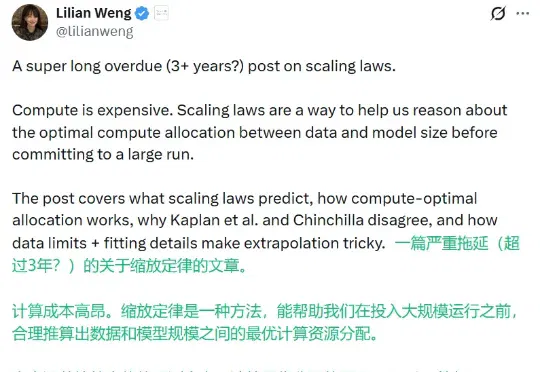
刚刚,翁荔(Lilian Weng)的博客 Lil'Log 终于更新了!要知道,自从她联合创立了 Thinking Machines Lab 之后,她那让许多人受益良多的博客就鲜少更新了——距离她上一次更新,已经过去了 13 个月。
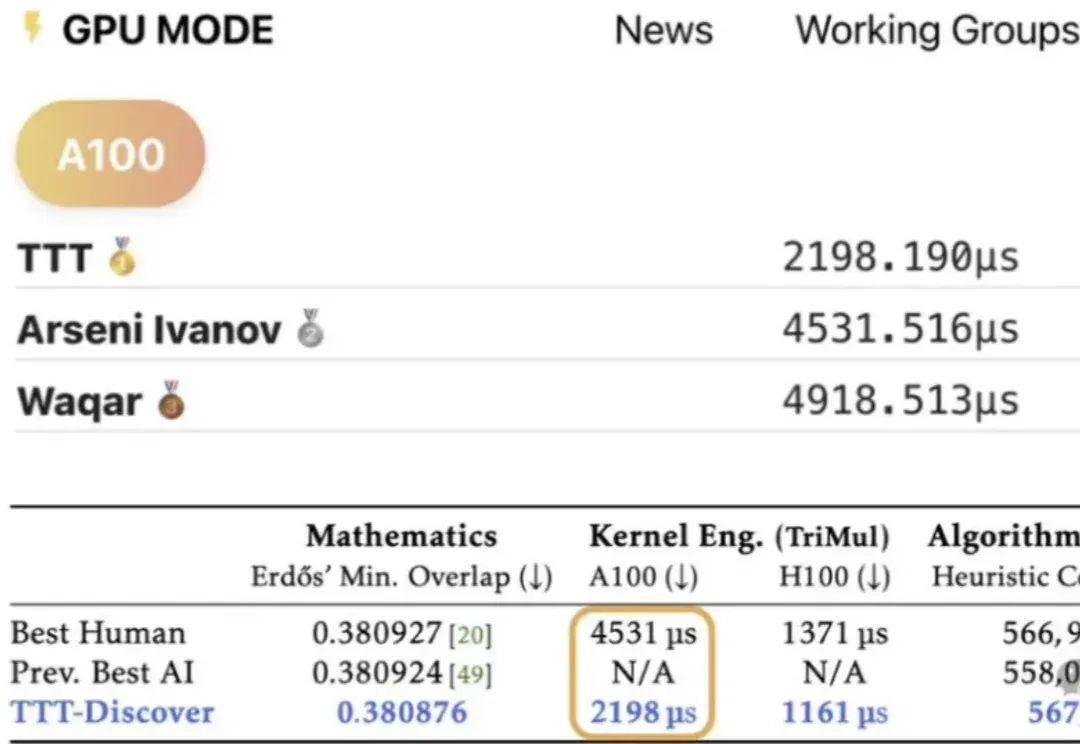
大模型持续学习,又有新进展! 来自斯坦福、英伟达等研究机构的最新研究,针对解决开放的科学问题,提出全新思路—— Test-Time Training to Discover (TTT-Discover)。 其基于开源模型gpt-oss-120b,在多个领域达到SOTA,优于人类专家与闭源前沿模型。 该方法不再沿用“测试时缩放”(Test-time Scaling)只通过Prompt调度冻结模型的做法。 而是在测试阶段,针对单个具体问题,引入强化学习(RL)对模型权重进行更新。 这种“测试时训练”使模型能够从该问题的失败尝试中实时获取经验,更新参数,实现模型能力的定向进化。 数学:给出了Erdő
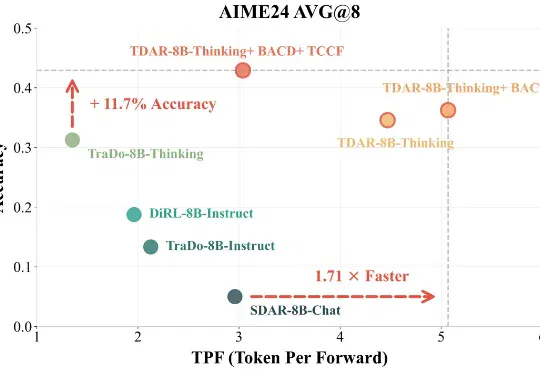
近期,复旦大学 NLP 实验室(FDU NLP)、北京大学知识计算实验室(KCL)联合美团 LongCat Team 提出了一种 Block Diffusion 推理模型 Test-Time Scaling 新框架 TDAR,通过引入 “粗思考,细求证” (Think Coarse Critic Fine, TCCF) 范式与有界自适应置信度解码
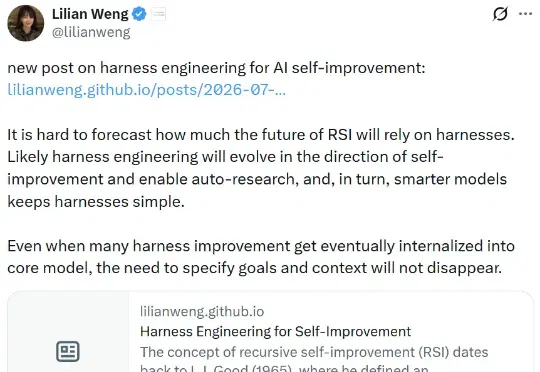
刚刚,翁荔(Lilian Weng)又更新博客了!距离她上一次更新《谨慎对待 Scaling Law》还不到 10 天。这一次,她书写的主题是当前大热的 Harness Engineering,聚焦的正是当下 AI 研究最前沿一个环节:当模型本身的智能已经足够强大时,真正决定它能走多远的,或许是包裹在模型外面的那层「Harness」也就是负责编排模型思考、调用工具、管理上下文、评估结果的那套系统。
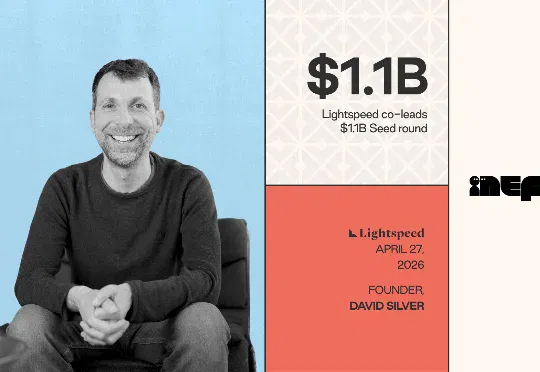
AlphaGo 之父 David Silver 创办的 Ineffable Intelligence 获 11 亿美元种子轮,创欧洲融资纪录,估值达 51 亿美元。这家公司押注强化学习和自我经验学习,试图挑战依赖 Scaling Law 的大模型主线。
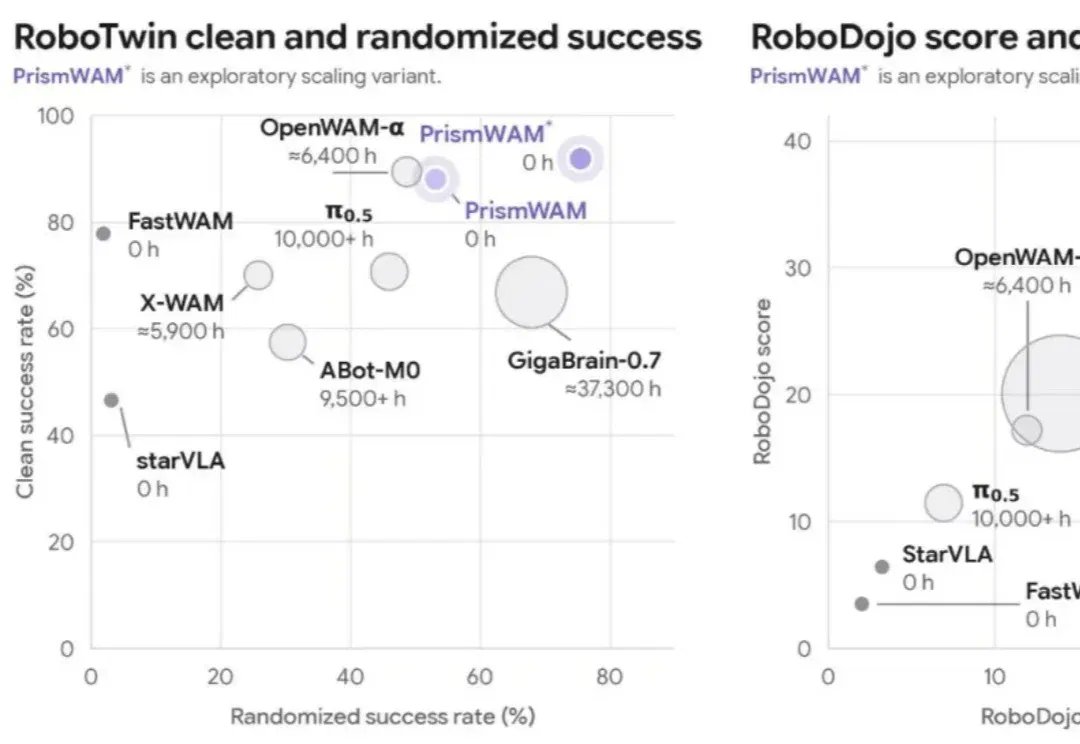
近日,厘清智能创始人、清华大学人工智能学院李一鸣教授团队发布了两项 Physical AI 研究成果:世界动作模型 PrismWAM,以及面向机器人执行诊断与持续改进的 Agentic 框架 RoboDoctor。
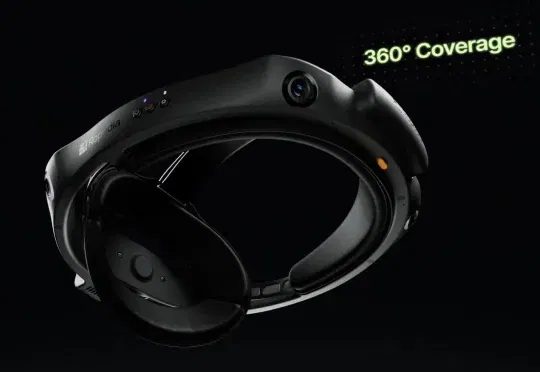
新加坡Physical AI公司Ropedia正式发布新一代多模态采集系统HOMIE Gen2,以4目全景360°、十余种模态同步采集与开箱即用的高精度训练级数据,将人类经验规模化为机器人可直接学习的训练数据,推动Physical AI的经验规模化落地。
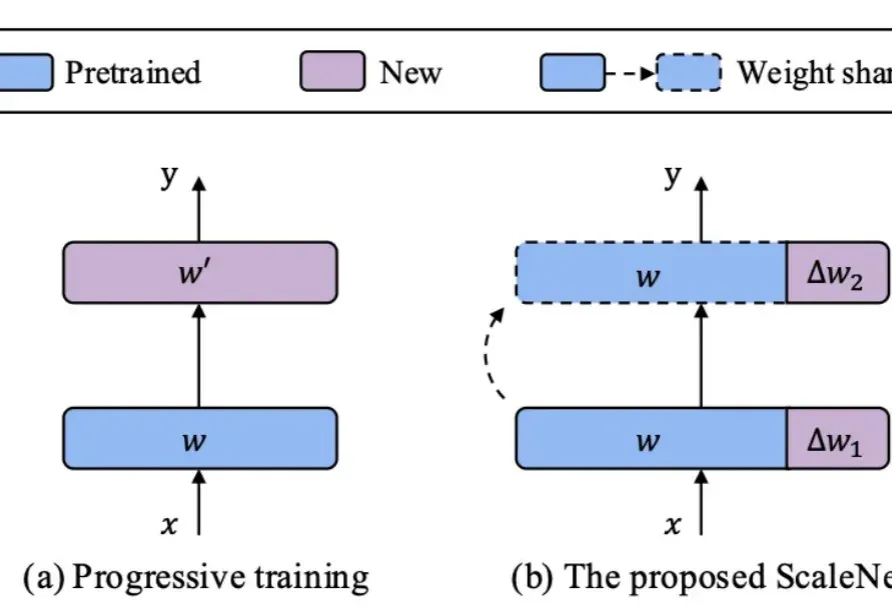
在基础模型领域,模型规模与性能之间的缩放定律(Scaling Law)已被广泛验证,但模型增大也伴随着训练成本、存储需求和能耗的急剧上升。如何在控制参数量的前提下高效扩展模型,成为当前研究的关键挑战。
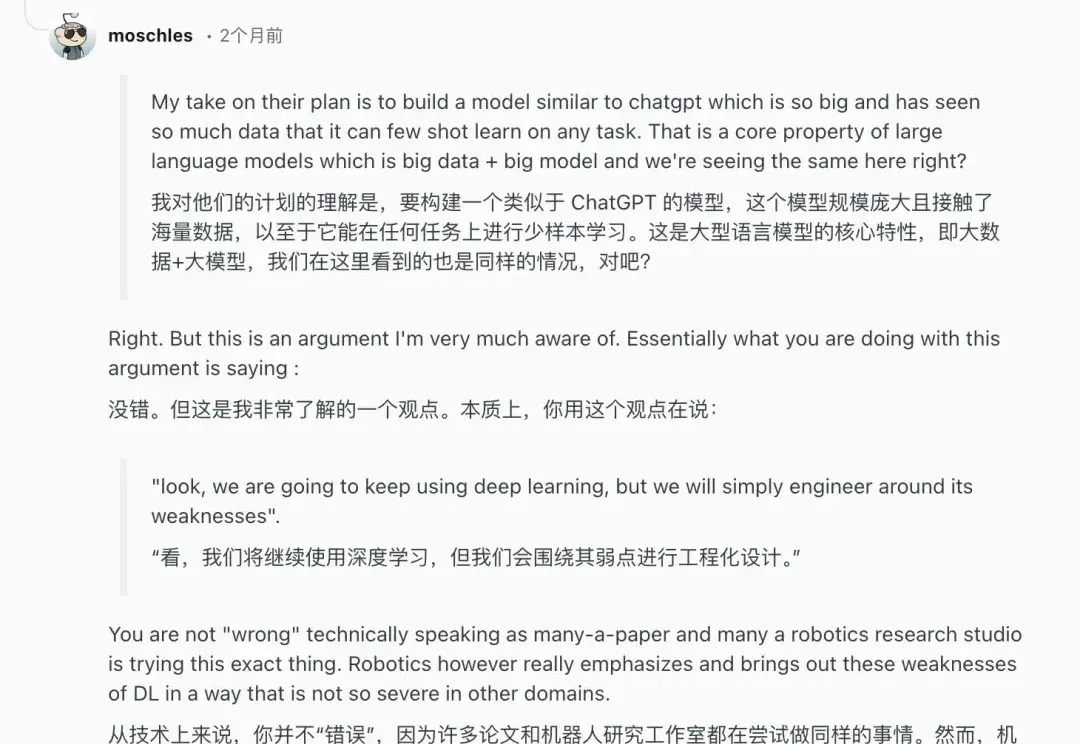
机器人领域是我们长期关注的赛道,而 Generalist 是当前机器人领域中极少数具备长期竞争潜力的公司,核心优势集中在数据规模、团队能力与清晰的 scaling 路径上。