闷声赚钱的 RL 生意:每个任务,200-20000 美元(在新窗口打开)
2025 年 9 月,The Information 报道 Anthropic 曾讨论在接下来一年内投入超过 10 亿美元用于 RL 环境建设。Epoch AI 最近发了一篇报告,采访了 18 位来自 RL 环境初创公司、neolab(Cursor 这类应用型 AI 公司)和前沿实验室的从业者
共 362 篇
2025 年 9 月,The Information 报道 Anthropic 曾讨论在接下来一年内投入超过 10 亿美元用于 RL 环境建设。Epoch AI 最近发了一篇报告,采访了 18 位来自 RL 环境初创公司、neolab(Cursor 这类应用型 AI 公司)和前沿实验室的从业者
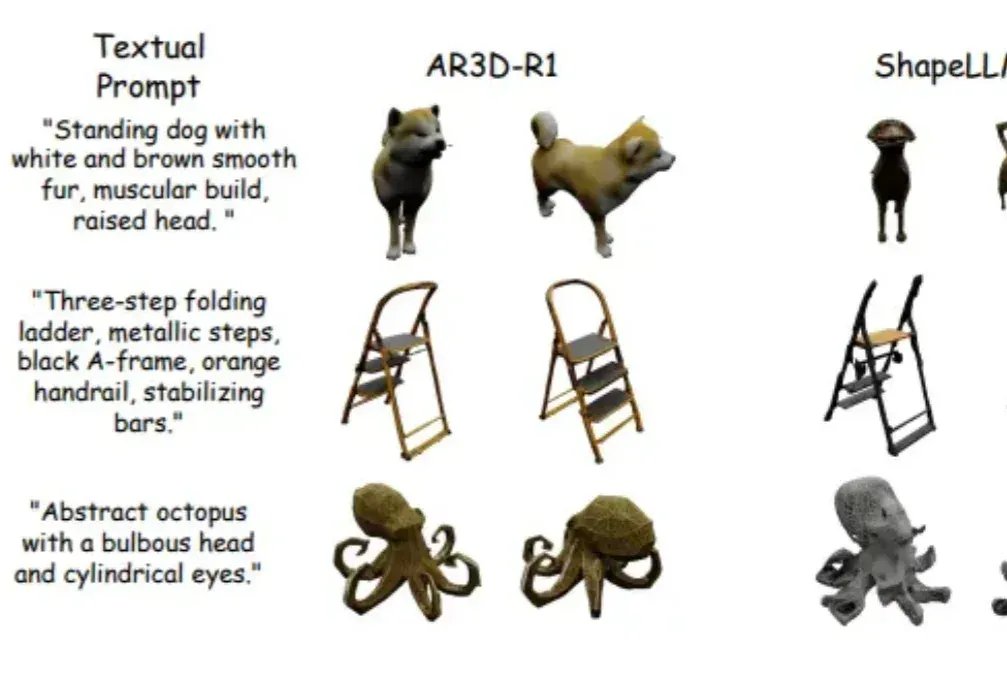
强化学习(RL)在大语言模型和 2D 图像生成中大获成功后,首次被系统性拓展到文本到 3D 生成领域!面对 3D 物体更高的空间复杂性、全局几何一致性和局部纹理精细化的双重挑战,研究者们首次系统研究了 RL 在 3D 自回归生成中的应用!
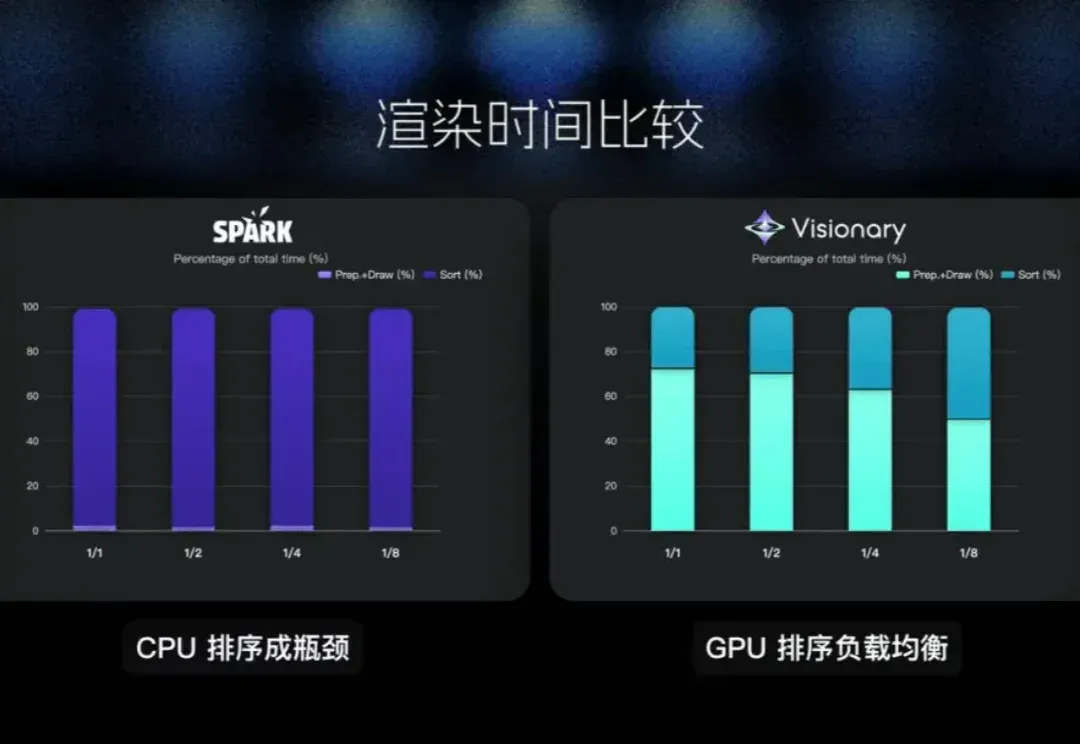
在李飞飞团队 WorldLabs 推出 Marble、引爆「世界模型(World Model)」热潮之后,一个现实问题逐渐浮出水面:世界模型的可视化与交互,依然严重受限于底层 Web 端渲染能力。
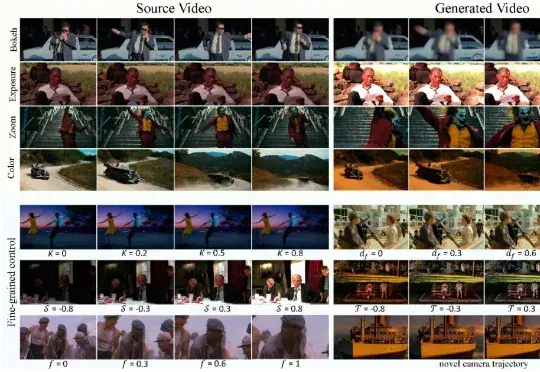
现有视频生成模型往往难以兼顾「运镜」与「摄影美学」的精确控制。为此,华中科技大学、南洋理工大学、商汤科技和上海人工智能实验室团队推出了 CineCtrl。作为首个统一的视频摄影控制 V2V 框架,CineCtrl 通过解耦交叉注意力机制,摆脱了多控制信号共同控制的效果耦合问题,实现了对视频相机外参轨迹与摄影效果的独立、精细、协调控制。
昨天,苹果一篇新论文在 arXiv 上公开然后又匆匆撤稿。原因不明。论文中,苹果揭示了他们开发的一个基于 TPU 的可扩展 RL 框架 RLAX。是的,你没有看错,不是 GPU,也不是苹果自家的 M 系列芯片,而是谷歌的 TPU!还不止如此,这篇论文的研究中还用到了亚马逊的云和中国的 Qwen 模型。
靠AI将占星做成了长期生意。 6 月底,我们曾在《抓住人们对“Soulmate”的渴望,20 天入账 200 万美金?》选题中观察空降美国下载总榜 Top10 的两款 AI 占星产品,「Starla-Call the Universe」和「Astra-Life Advice」,两款产品不仅持续在榜超一周时间,而且,Starla 巅峰时期月流水达到 240 万美元,Astra 也拿下了 80 万+美元,妥妥的吸量又赚钱。 Starla-Call the Universe 5月-11月 全球双端月流水|图片来源:点点数据 两款产品当时最强有力的发酵手段就是“Soulmate 形象预测”引起的社媒病
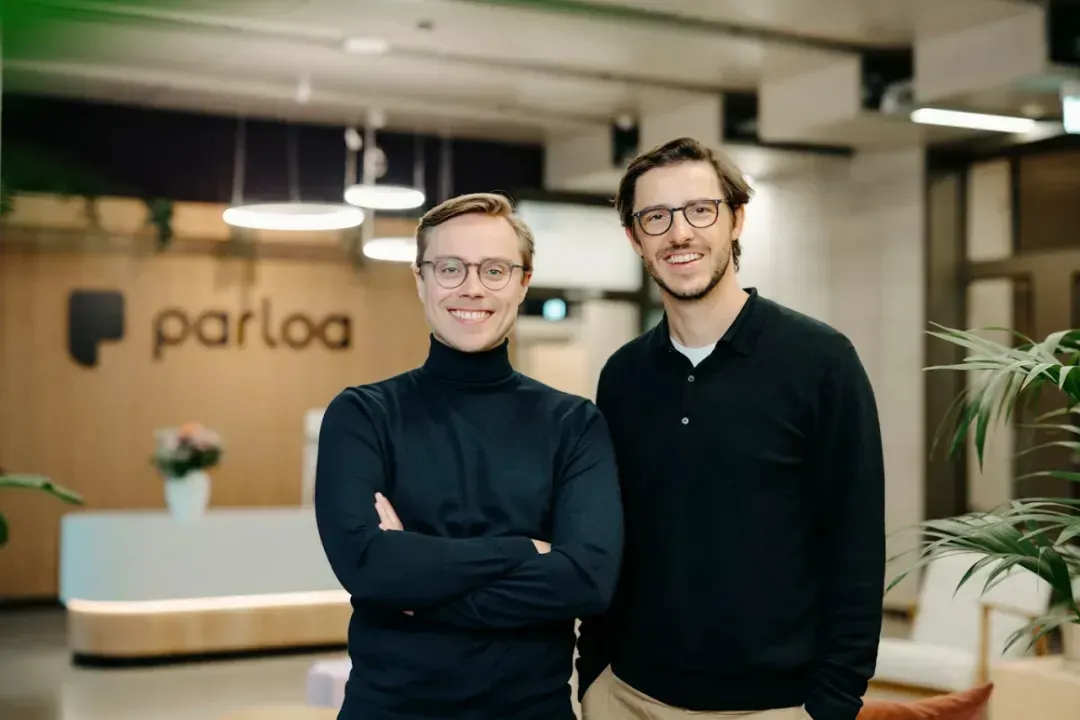
据知情人士透露,开发客户服务人工智能的德国初创公司Parloa正在寻求新一轮融资,估值将较今年5月大幅提升。这家在德国和纽约设有办公室的公司,已与包括General Catalyst在内的投资者进行了洽谈,寻求筹集约2亿美元的新资金。知情人士称,Parloa正在讨论的潜在估值区间约为20亿至30亿美元。
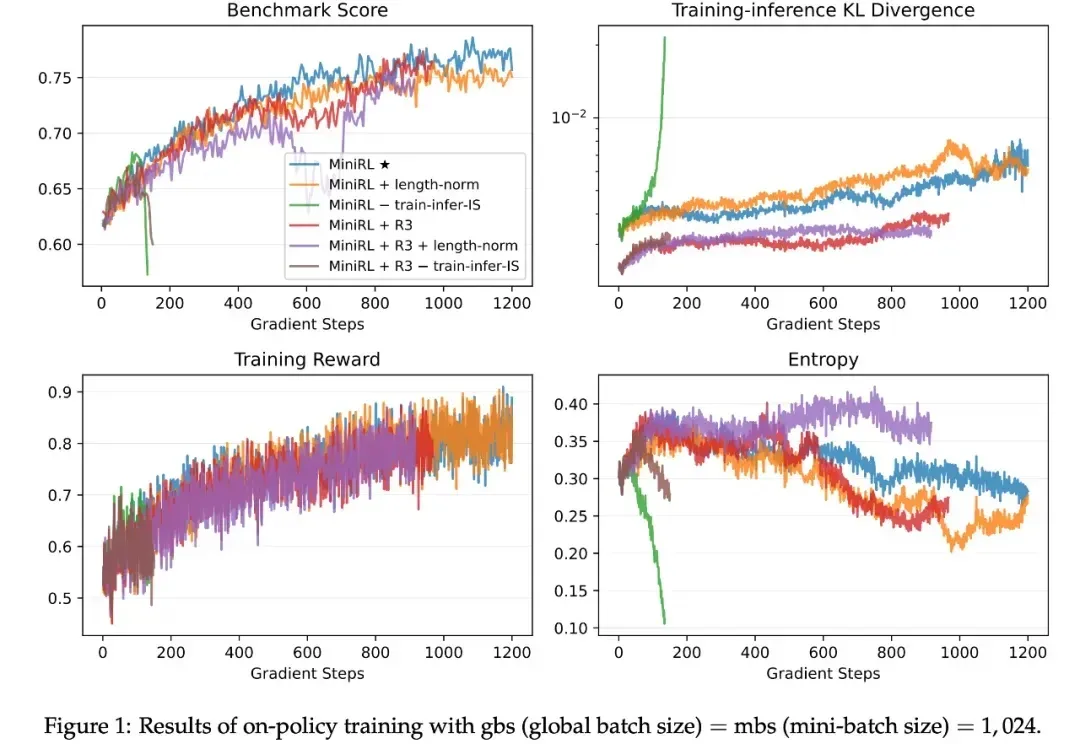
如今,强化学习(RL)已成为提升大语言模型(LLM)复杂推理与解题能力的关键技术范式,而稳定的训练过程对于成功扩展 RL 至关重要。由于语言具有强烈的上下文属性,LLM 的 RL 通常依赖序列级奖励 —— 即根据完整生成序列给一个标量分数。
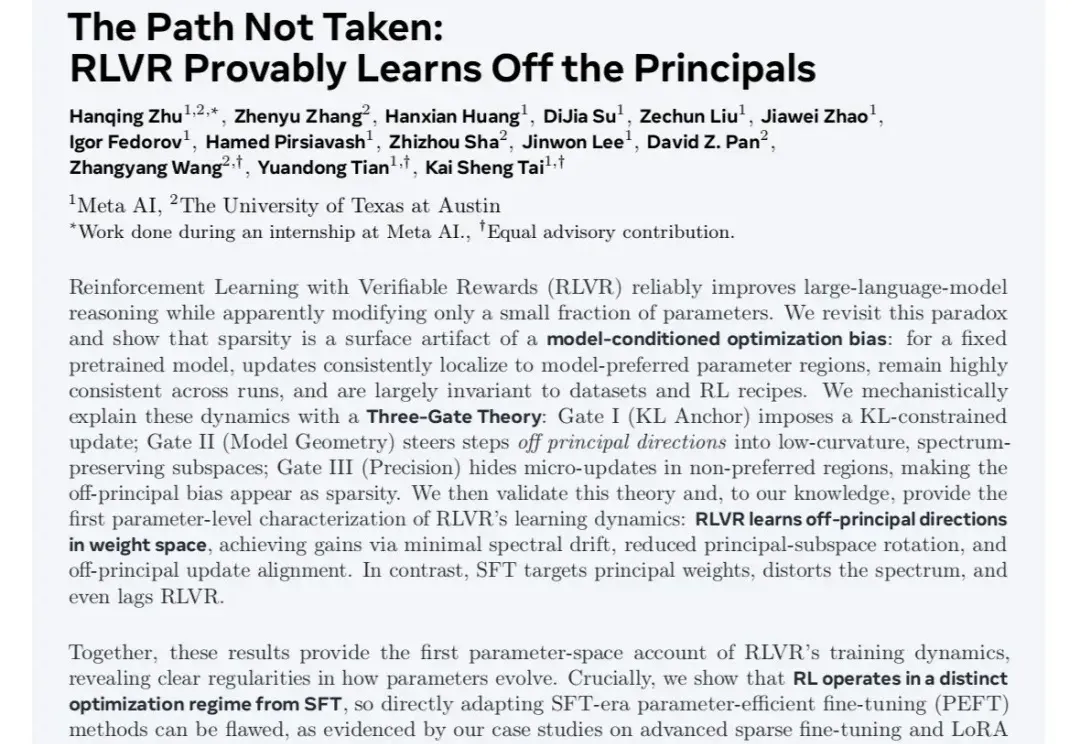
最近不论是在学术圈还是产业实践中,对于RLVR和传统SFT之间的区别与联系,以及RL本身基于奖励建模反馈机制并结合不同的策略优化算法过程中对模型显性知识的学习和隐参数空间的变化的讨论热度一直很高。
UC Berkeley、UW、AI2 等机构联合团队最新工作提出:在恰当的训练范式下,强化学习(RL)不仅能「打磨」已有能力,更能逼出「全新算法」级的推理模式。他们构建了一个专门验证这一命题的测试框架 DELTA,并观察到从「零奖励」到接近100%突破式跃迁的「RL grokking」现象。