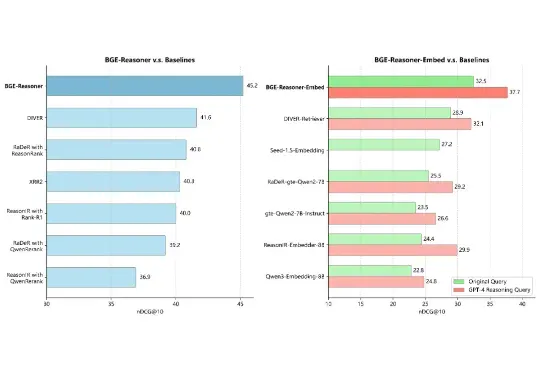
打破瓶颈,让RAG学会思考:中科大、智源等发布推理检索框架BGE-Reasoner(在新窗口打开)
人工智能的浪潮正将我们推向一个由 RAG 和 AI Agent 定义的新时代。然而,要让这些智能体真正「智能」,而非仅仅是信息的搬运工,就必须攻克一个横亘在所有顶尖团队面前的核心难题。这个难题,就是推理密集型信息检索(Reasoning-Intensive IR)。
共 85 篇
人工智能的浪潮正将我们推向一个由 RAG 和 AI Agent 定义的新时代。然而,要让这些智能体真正「智能」,而非仅仅是信息的搬运工,就必须攻克一个横亘在所有顶尖团队面前的核心难题。这个难题,就是推理密集型信息检索(Reasoning-Intensive IR)。
今天,Qwen 家族新成员+2,我们正式发布 Qwen3-VL-Embedding 和 Qwen3-VL-Reranker 模型系列,这两个模型基于 Qwen3-VL 构建,专为多模态信息检索与跨模态理解设计,为图文、视频等混合内容的理解与检索提供统一、高效的解决方案。
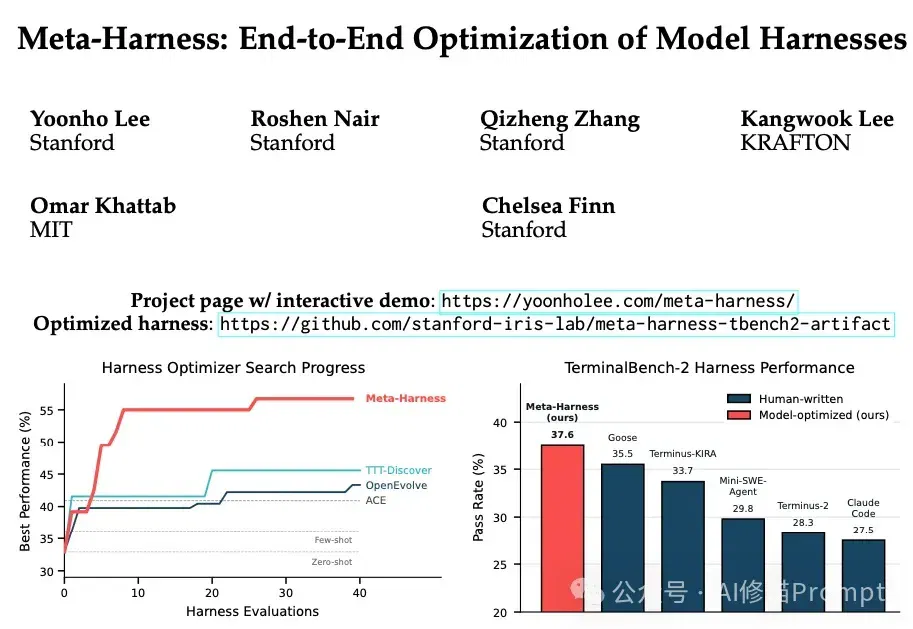
去年讨论Agent落地时,重点往往是Context Engineering。大家都在琢磨怎么放 Few-shot,怎么优化 RAG 检索的文本片段。但随着 Agent 任务复杂度的上升,控制数据流向、工具调度和异常处理的底层脚手架代码,往往比单纯拼接文本对系统性能的影响更大。
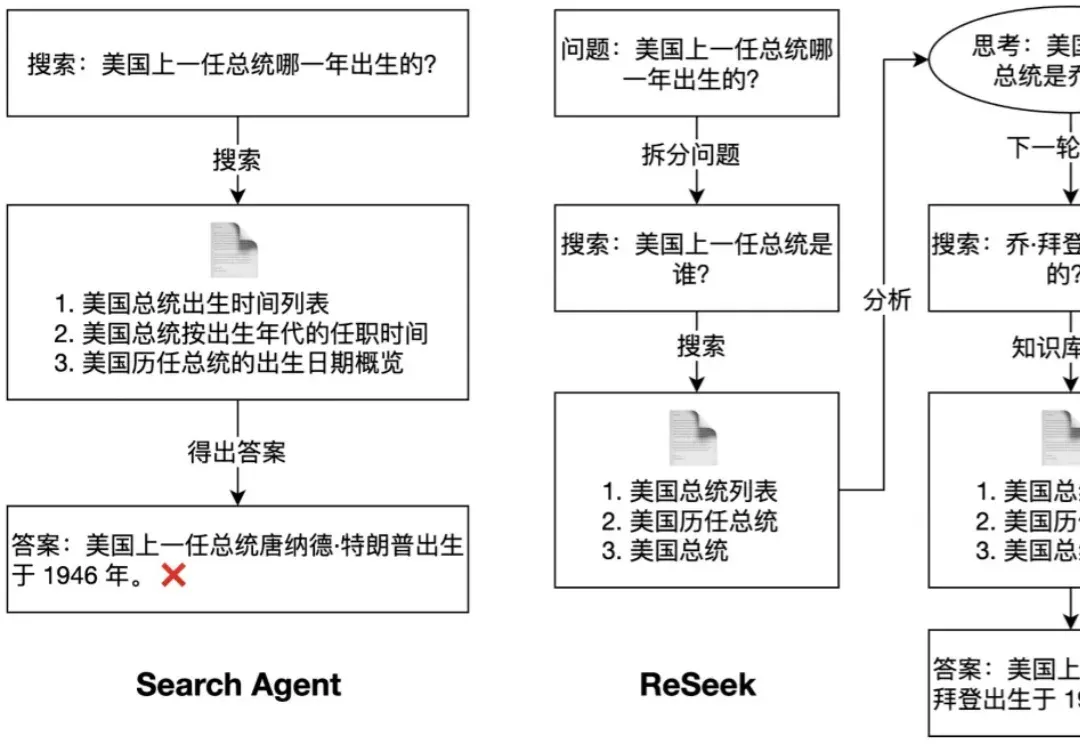
为了同时解决知识的实时性和推理的复杂性这两大挑战,搜索智能体(Search Agent)应运而生。它与 RAG 的核心区别在于,Search Agent 能够通过与实时搜索引擎进行多轮交互来分解并执行复杂任务。这种能力在人物画像构建,偏好搜索等任务中至关重要,因为它能模拟人类专家进行深度、实时的资料挖掘。
AI存储进入全流程竞争。 智东西9月17日报道,9月1日,全球权威AI性能评测组织MLCommons发布MLPerf Storage v3.0基准测试榜单。焱融全闪AI存储F9000X在多项基准测试中拿下第一,充分验证其在极限AI训练负载下对高速网络带宽的高效利用能力。 ▲数据引用:MLPerf Storage Benchmark v3.0 Suite Results 2026 随着AI产业从模型训练走向规模化推理,存储系统需要处理的数据和承担的任务也在增加。训练阶段,存储要持续向GPU供给海量数据,还要快速保存和恢复模型 Checkpoint;推理阶段,系统又要管理不断膨胀的KV Cache
知识第一次,能像代码一样利滚利。前OpenA 创始团队成员、特斯拉前 AI 高级总监 Andrej Karpathy,提出一个狠招:别再用 RAG 检索你的知识库,让大模型把它「编译」成一座持续生长的活 Wiki。两个多月,他在GitHub屠出 5000+ star。
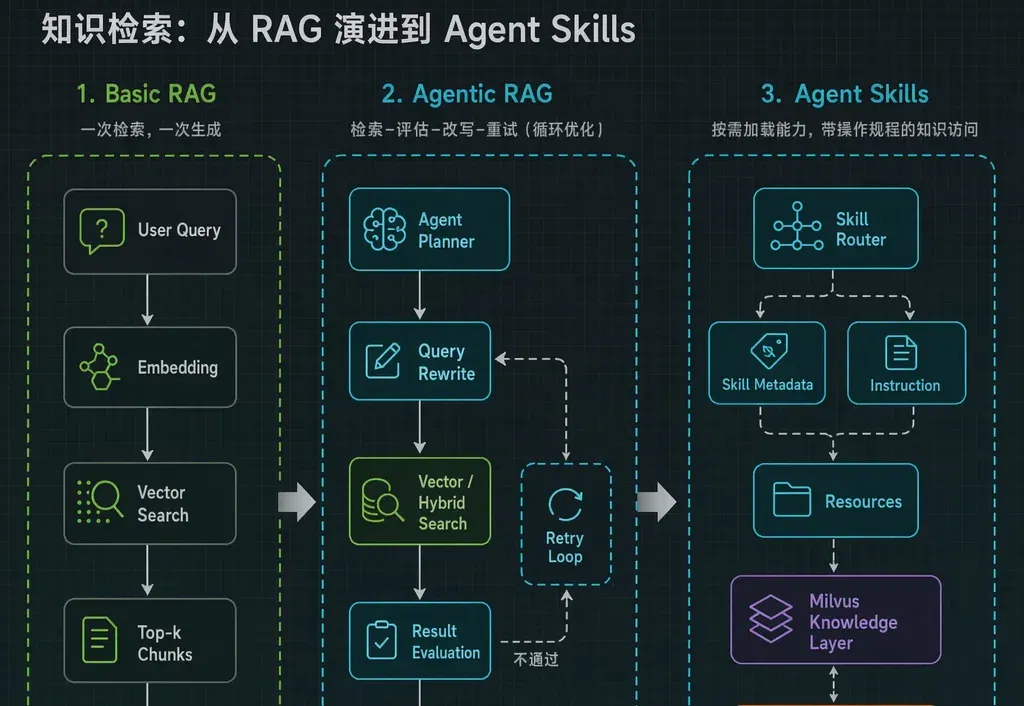
最近一两年,互联网上各种为RAG赛博哭坟的帖子不胜枚举。
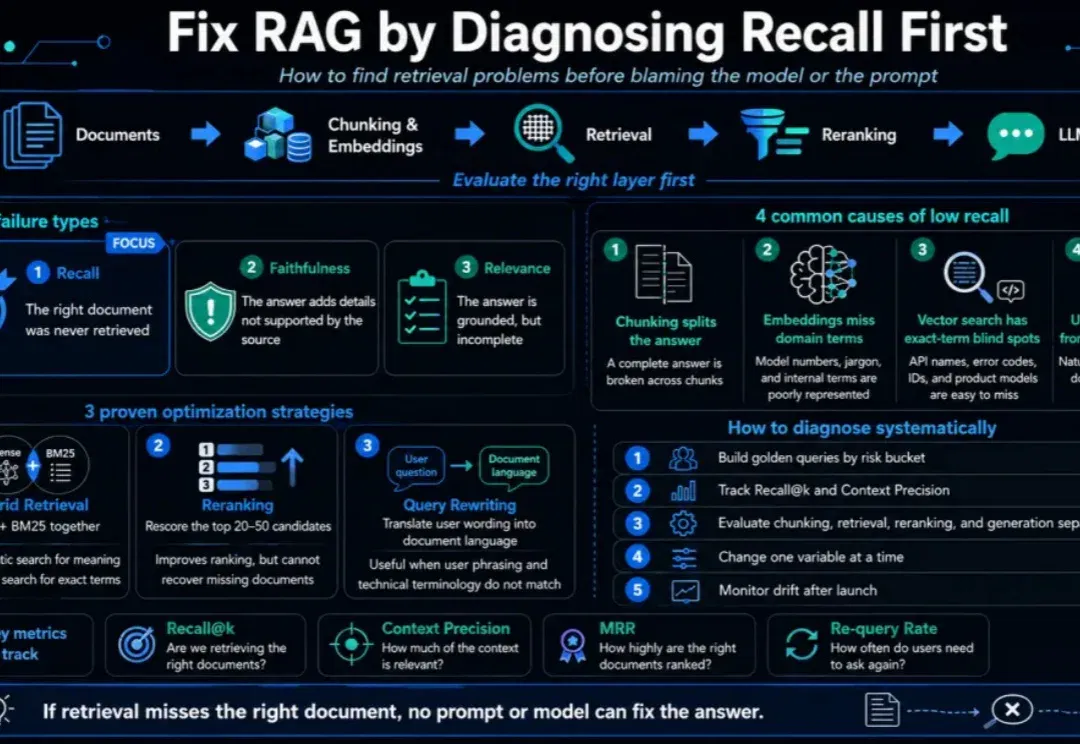
RAG 系统上线后答案出错,绝大多数团队的第一反应都是换更贵的模型、反复调试 prompt。
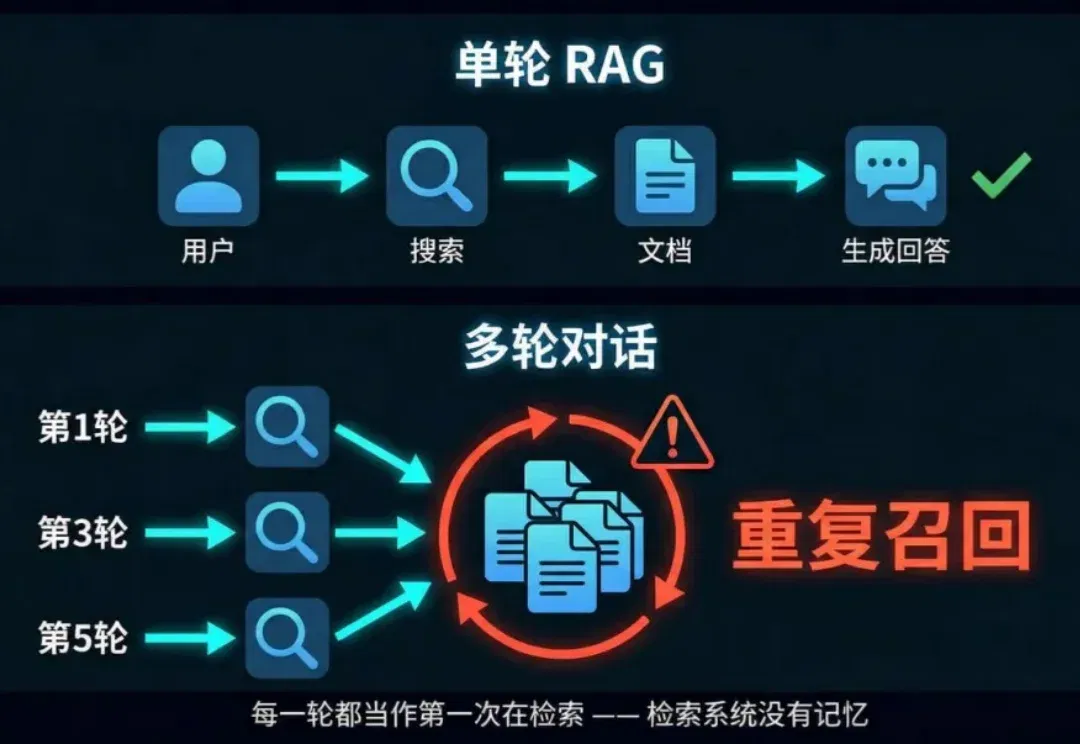
做 RAG 的团队,基本都会在多轮对话上吃过亏。
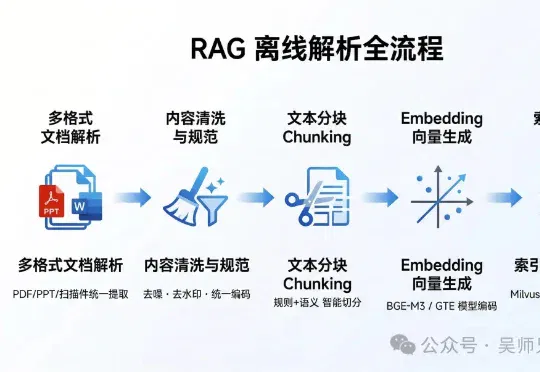
大家好,我是吴师兄。 之前有个学员面阿里的 NLP 岗,简历上写着"搭建了基于 RAG 的企业知识问答系统"。面试官翻着简历问: "你们知识库有多少文档?什么格式?" 他说:"大概 5000 份,PD