刚刚,Qwen3.8-Flash震撼发布,我们看到了Qwen4的骨架(在新窗口打开)
就在刚刚,阿里交出了一份让人满意的答卷:发布了 Qwen3.8-Flash,同步开源 Qwen3.8-Flash-Next(两者为同一模型,前者是 API 版本名称,后者是开源版本的正式名称)。它的成绩相当亮眼。在智能体编程基准 DeepSWE 1.1 上,它拿到 58.7 分,而参数规模是它三倍的前代 Qwen3.7-Plus 只有 16.5 分;
共 61 篇
就在刚刚,阿里交出了一份让人满意的答卷:发布了 Qwen3.8-Flash,同步开源 Qwen3.8-Flash-Next(两者为同一模型,前者是 API 版本名称,后者是开源版本的正式名称)。它的成绩相当亮眼。在智能体编程基准 DeepSWE 1.1 上,它拿到 58.7 分,而参数规模是它三倍的前代 Qwen3.7-Plus 只有 16.5 分;
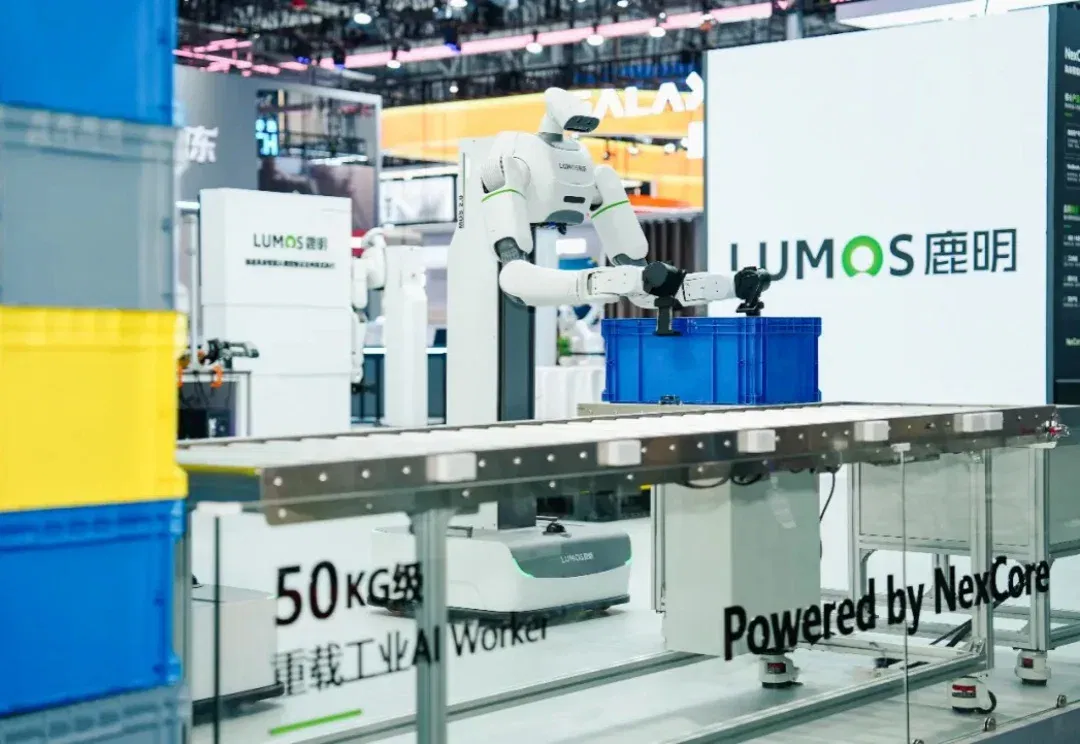
在 Demo 中,我们能看到花样百出的机器人表演,但在工厂里,机械臂换了一个工件型号,工程师们却还要蹲在产线前重新编程三小时。
当下,几乎所有人都在押注更大、更聪明的 AI 模型。但 AI 的下一个核心护城河到底是什么?最近,a16z 发布了一篇深度文章——《下一个 AI 护城河并非更优的模型》(The Next AI Moat Isn’t a Better Model)。
近期,SemiAnalysis 创始人 Dylan Patel 先后做客红杉资本的《Training Data[1]》和 WisdomTree 的《The Next Big Thing[2]》。两期访谈从模型和芯片,一路延伸至内存、能源、数据中心与 AI 商业模式,并指向同一个变化:AI 竞赛的焦点,正从单纯比较模型能力,扩展到谁能以更低成本、更大规模,把模型能力稳定地交付出来。
今年初,ChatGPT 开始小范围测试卖广告。半年过去,我们很好奇:那些真正把预算投进去的人,看到了什么?
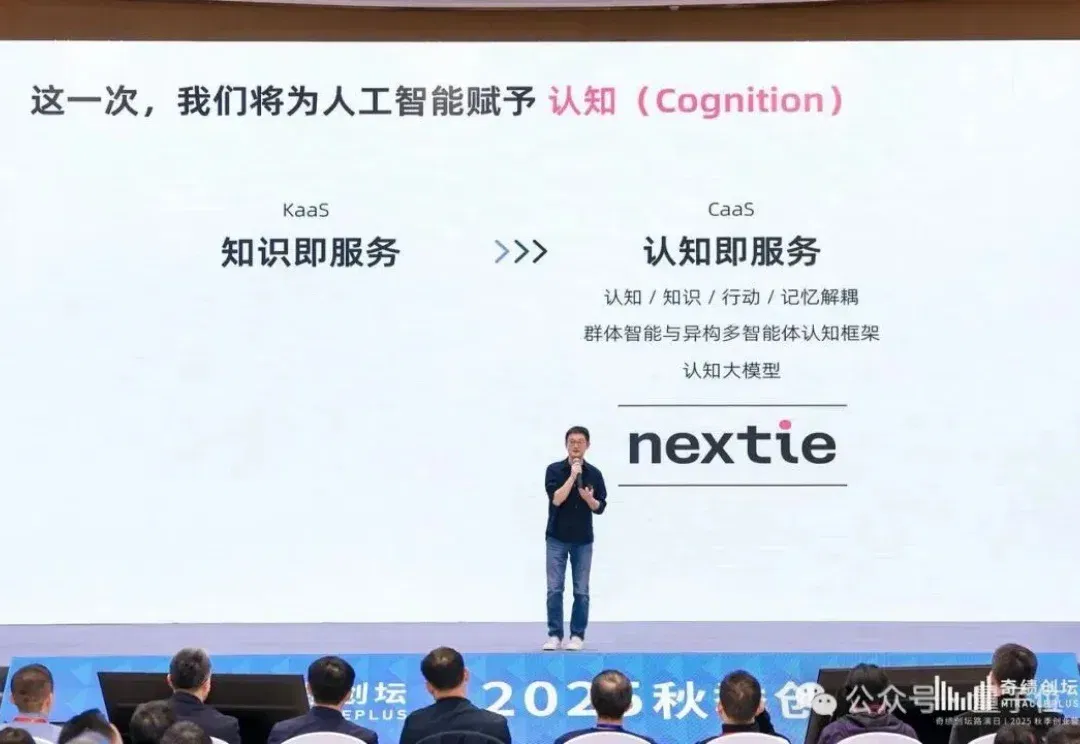
好家伙,卡帕西又说对了! 几个月前,这位OpenAI创始成员在访谈中抛出了一个判断:“推理模型要变天了!” 仅需10亿参数,就能构建起非常优秀的「认知核心」——一个剥离了海量事实记忆、只保留思考算法的智能单元。 结果万万没想到,如今有这样一支中国团队已经率先实践。 小冰之父李笛集结微软小冰原班人马,带着仅成立半年的AI初创公司Nextie(明日新程),刚刚推出了行业首个认知模型「新程Alpha」。 何为首个?事实上,明日新程对认知模型的押注和卡帕西几乎是同一时期给出。 在去年12月的奇绩创坛Demo Day上,明日新程首度公开亮相就明确提出: AI进化终点不是更大的单体大模型,认知模型才是下一
编辑|Panda 数学正在迎来 AI 革命。 最近几个月尤为明显。比如,就在前几天,Google DeepMind 新论文宣布其最新系统 AlphaProof Nexus 在一次自主运行中,解决了 3
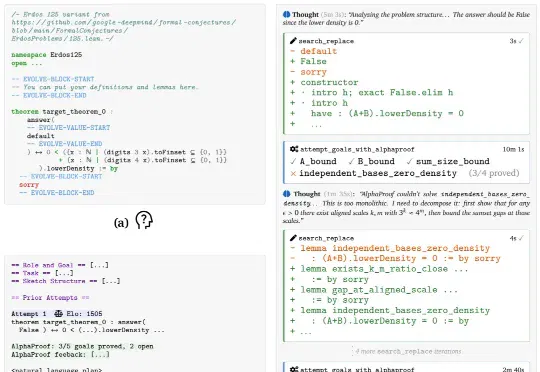
前脚OpenAI刚把Erdős 80年猜想推翻,数学家们的惊呼声还没落地。紧接着,Google DeepMind发布了一个全新AI数学智能体——AlphaProof Nexus。它一出手,就干掉了9道悬而未决几十年的Erdős开放问题。其中最古老的那个,悬了整整56年!
何恺明,也下场做语言模型了。 只不过,这次他带队做的不是大家熟悉的、像ChatGPT背后那套“预测下一个词元”(next token prediction)的自回归范式。 而是另一条过去几年在图像领域大火、如今正被越来越多人搬进文本生成的新路线:扩散语言模型(Diffusion Language Model,DLM)。 在最新的论文中,何恺明团队放出全新连续扩散语言模型:ELF:Embedded Language Flows。 与不少还停留在token层面做扩散的语言模型不同,ELF把整个生成过程都留在了连续的embedding空间里,直到最后一步,才重新离散化,将表示变回token。 靠着这
今天,硅谷一篇长文《The next biggest moat in AI》刷屏了,作者是 Foundation Capital 合伙人、前麦肯锡咨询师 Jaya Gupta。这篇文章在 X 上 12 小时获得了130万阅读,被一群创始人和打工人同时转发,原因是它同时提供了两套视角: