登上NeurIPS,Genesis开创无需OCC引导的多模态生成新范式,在视频与激光雷达指标上达到SOTA水平(在新窗口打开)
由华中科技大学与小米汽车提出了业内首个无需 OCC 引导的多模态的图像 - 点云联合生成框架 Genesis。该算法只需基于场景描述和布局(包括车道线和 3D 框),就可以生成逼真的图像和点云视频。
共 86 篇
由华中科技大学与小米汽车提出了业内首个无需 OCC 引导的多模态的图像 - 点云联合生成框架 Genesis。该算法只需基于场景描述和布局(包括车道线和 3D 框),就可以生成逼真的图像和点云视频。
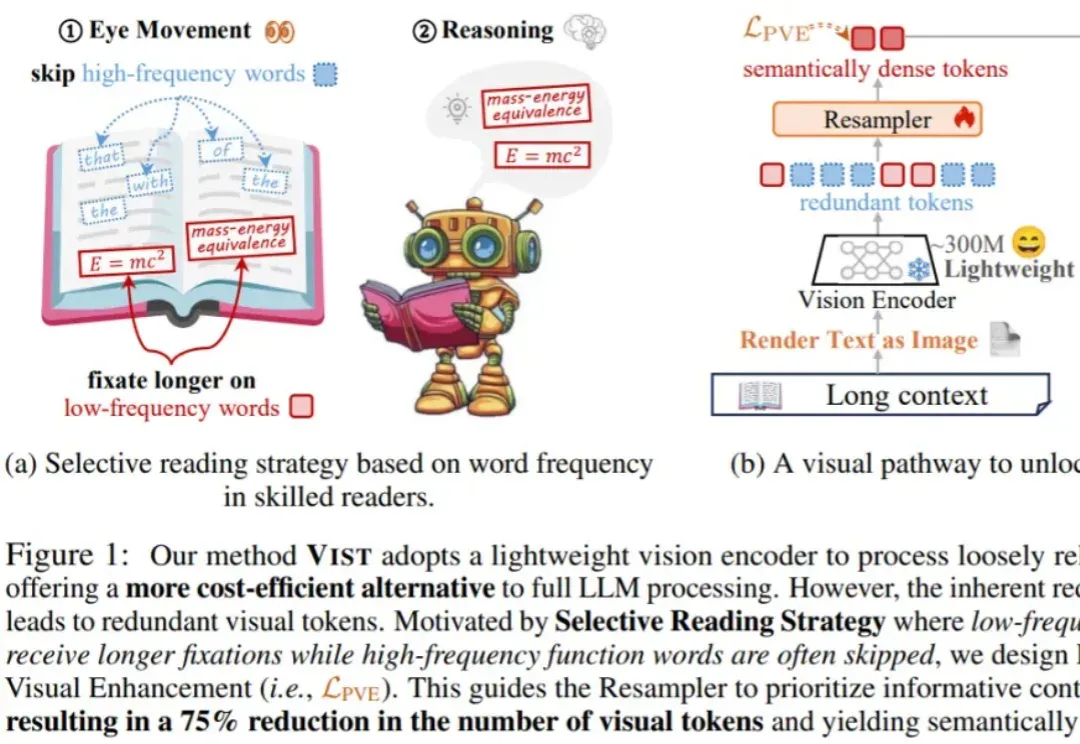
在处理短文本时,大语言模型(LLM)已经表现出惊人的理解和生成能力。但现实世界中的许多任务 —— 如长文档理解、复杂问答、检索增强生成(RAG)等 —— 都需要模型处理成千上万甚至几十万长度的上下文。
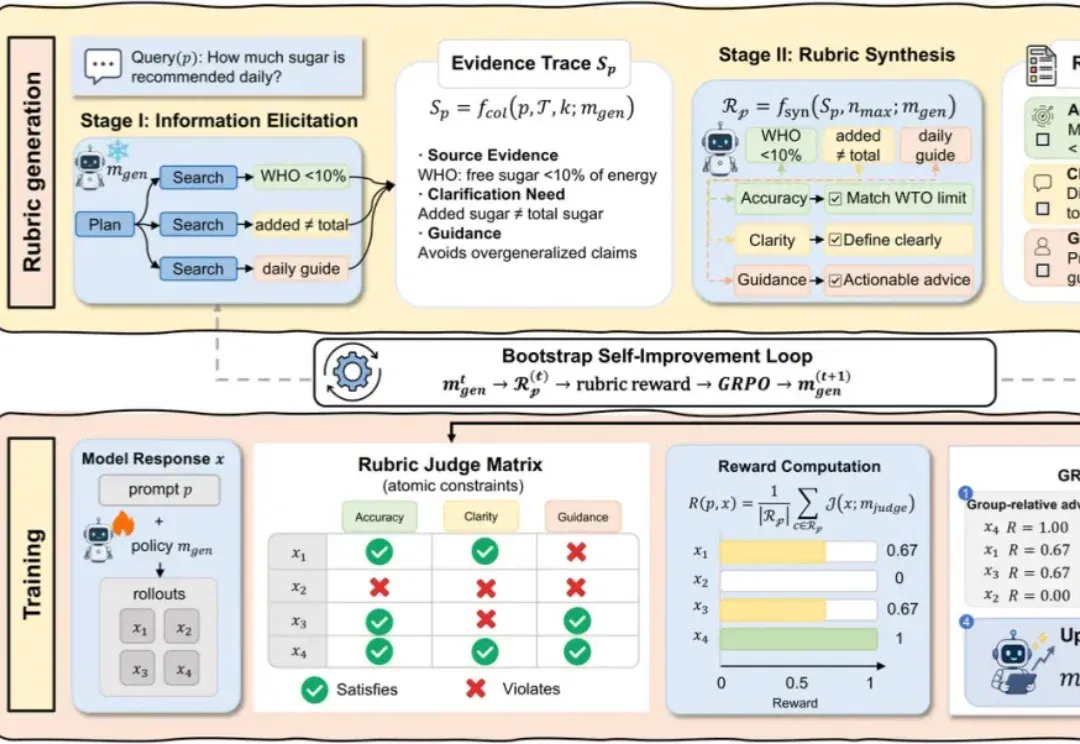
让大模型回答一道数学题,通常还能拿标准答案判断对错。可如果问题换成「梳理一个领域的研究进展」「比较几种技术路线」或者「给出有依据的专业建议」,怎样才算答得好?答案没有唯一版本,遗漏关键事实、混淆概念、论证不充分,都可能藏在一段看起来很流畅的文字里。
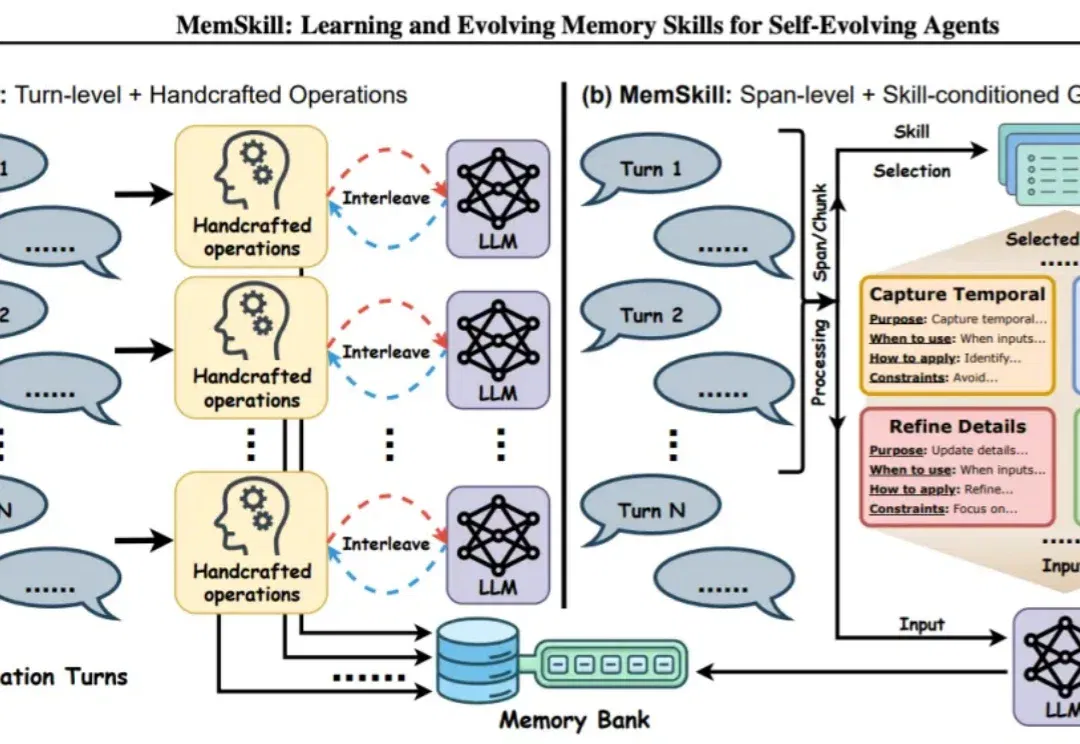
MemSkill 将智能体记忆操作封装为可复用的技能,由 Controller 学习选择,Executor 构建记忆,Designer 根据失败案例改进技能库。论文在长期对话、具身任务和迁移问答中评估表现;持续利用真实用户反馈适配偏好仍是后续研究方向。
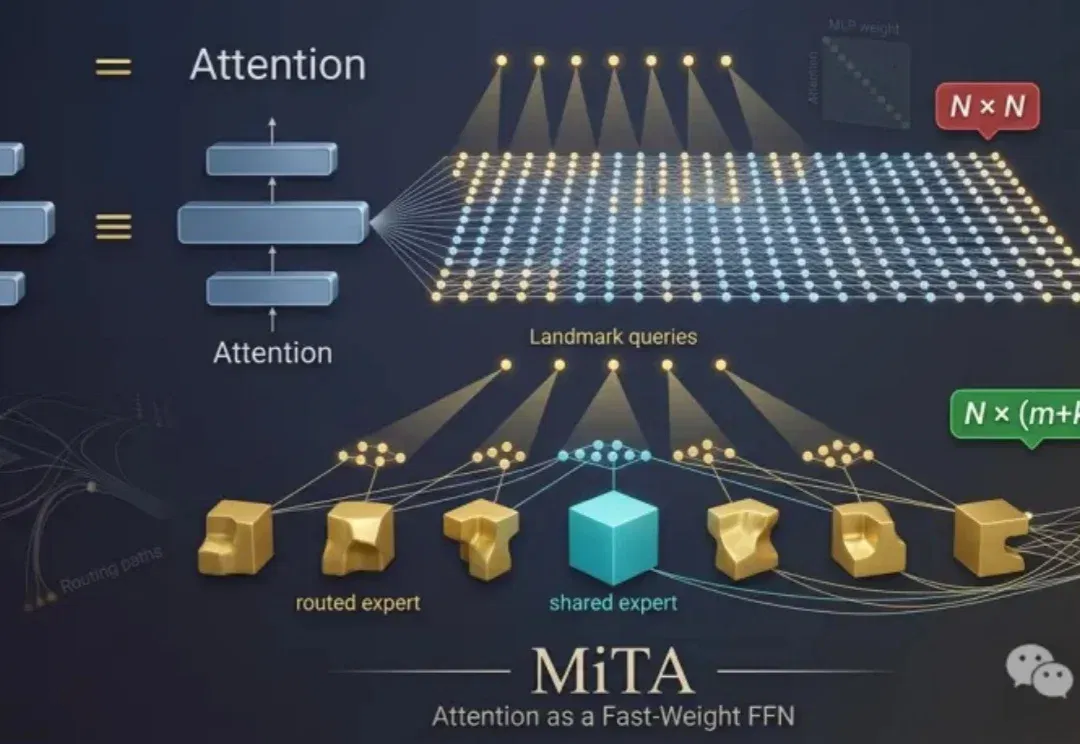
一直以来,在Transformer架构中,注意力(Attention)与前馈网络(Feed-Forward Network,FFN)被认为是两个功能不同且互补的模块: 前者让词元(Token)彼此交互,后者对每个词元进行非线性变换。
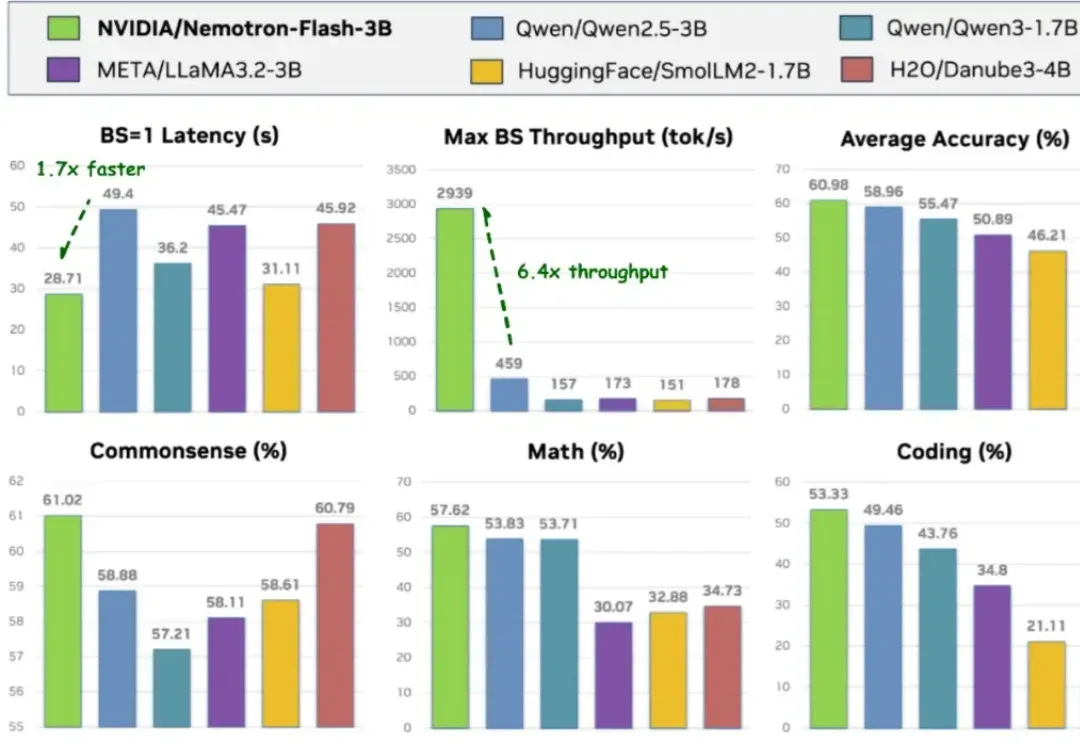
导读 过去两年,小语言模型(SLM)在业界备受关注:参数更少、结构更轻,理应在真实部署中 “更快”。但只要真正把它们跑在 GPU 上,结论往往令人意外 —— 小模型其实没有想象中那么快。
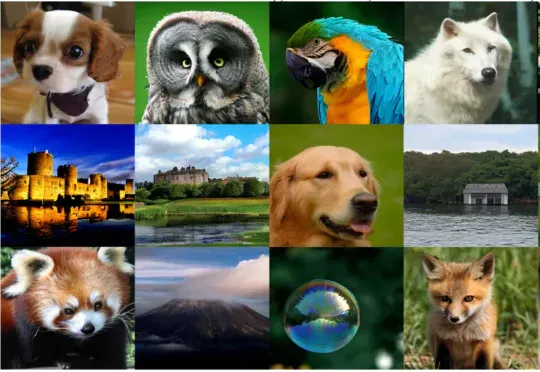
REG 是一种简单而有效的方法,仅通过引入一个 class token 便能大幅加速生成模型的训练收敛。其将基础视觉模型(如 DINOv2)的 class token 与 latent 在空间维度拼接后共同加噪训练,从而显著提升 Diffusion 的收敛速度与性能上限。在 ImageNet 256×256 上,
大模型「灾难性遗忘」问题或将迎来突破。近日,NeurIPS 2025收录了谷歌研究院的一篇论文,其中提出一种全新的「嵌套学习(Nested Learning)」架构。实验中基于该框架的「Hope」模型在语言建模与长上下文记忆任务中超越Transformer模型,这意味着大模型正迈向具备自我改进能力的新阶段。
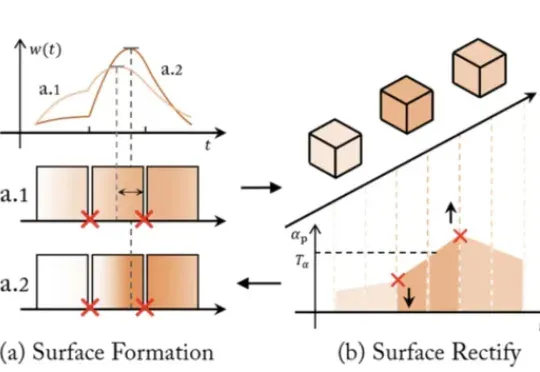
近年来,NeRF、SDF 与 3D Gaussian Splatting 等方法大放异彩,让 AI 能从图像中恢复出三维世界。但随着相关技术路线的发展与完善,瓶颈问题也随之浮现:
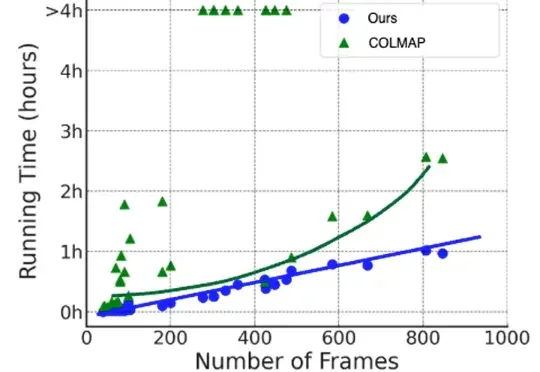
在三维重建、NeRF 训练、视频生成等任务中,相机参数是不可或缺的先验信息。传统的 SfM/SLAM 方法(如 COLMAP)在静态场景下表现优异,但在存在人车运动、物体遮挡的动态场景中往往力不从心,并且依赖额外的运动掩码、深度或点云信息,使用门槛较高,而且效率低下。