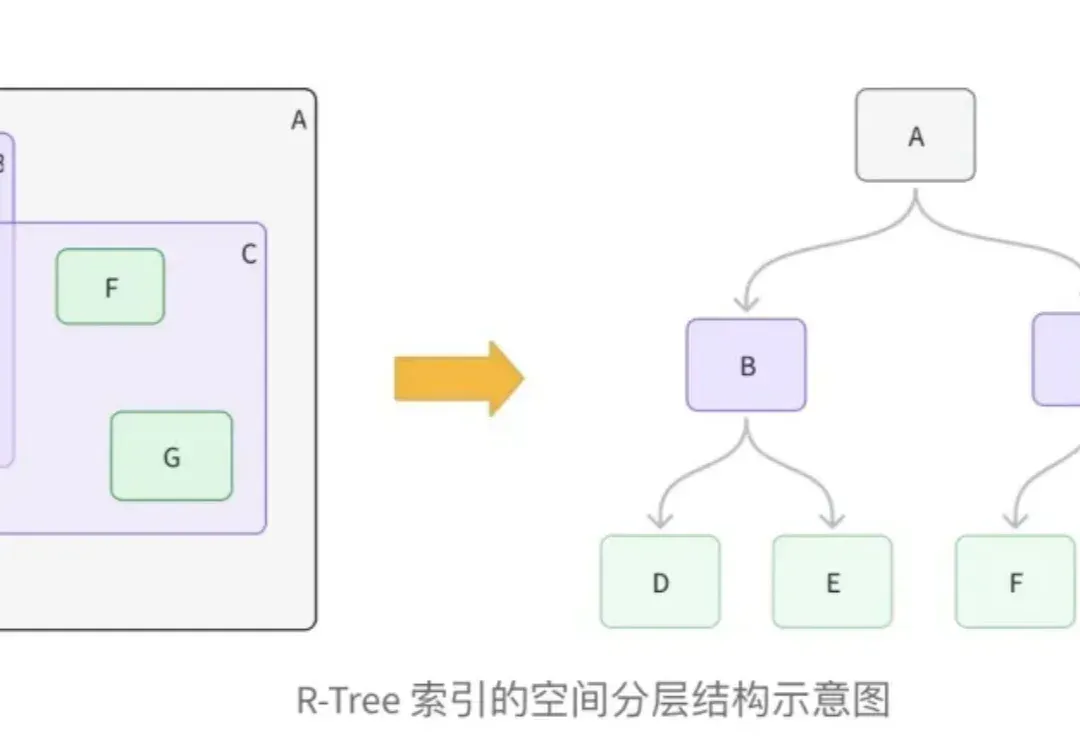
混合检索系列之:Milvus 地理几何字段与 R-Tree 索引技术详解(在新窗口打开)
在向量数据库的工程实践中,处理多模态数据,特别是结合地理位置(LBS)与非结构化语义数据,一直是一个复杂的架构挑战。
共 39 篇
在向量数据库的工程实践中,处理多模态数据,特别是结合地理位置(LBS)与非结构化语义数据,一直是一个复杂的架构挑战。
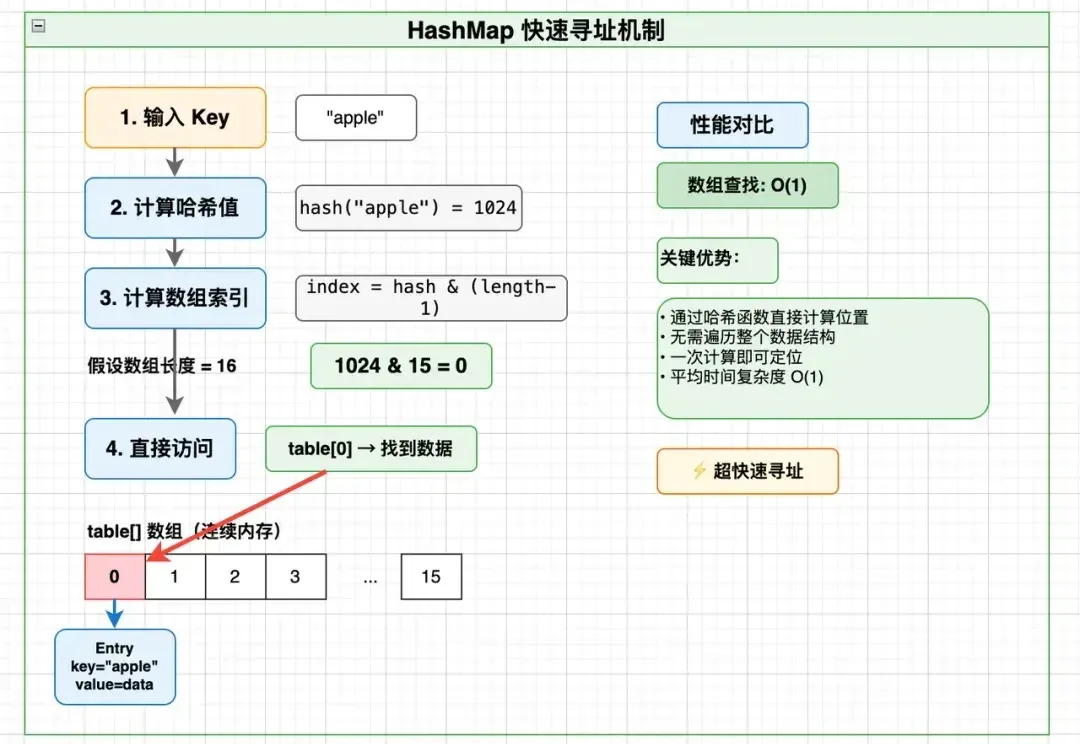
做后端、大数据、分布式存储的同学,大概率都遇到过这样的问题:
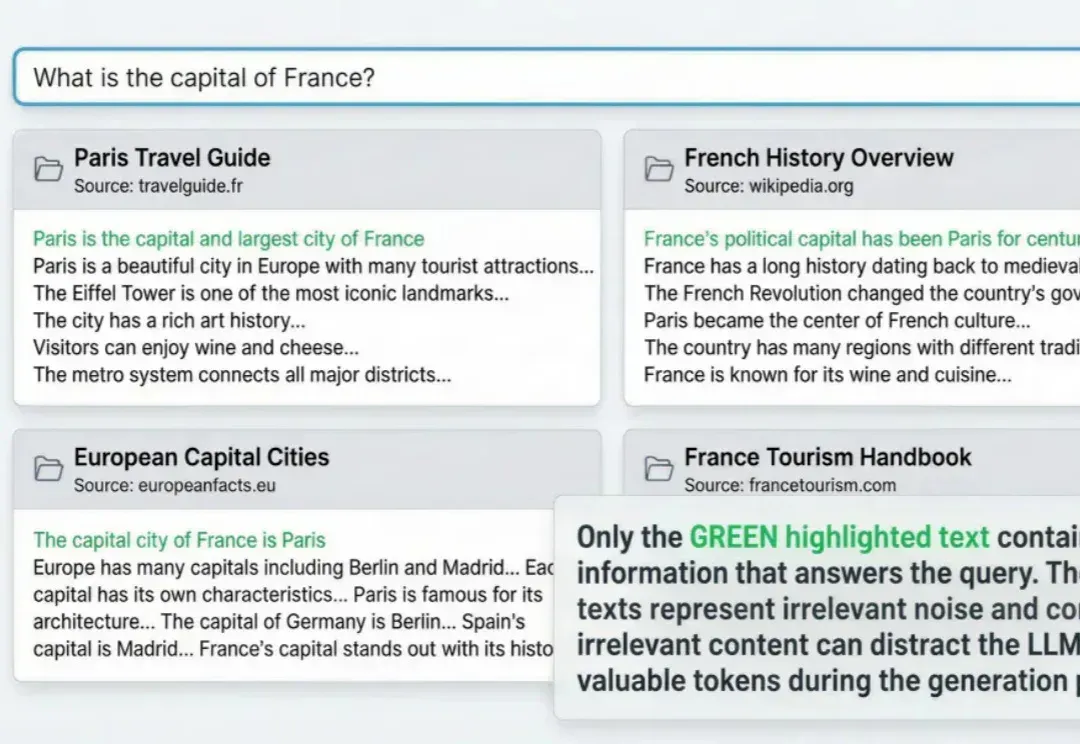
RAG与agent用到深水区,一定会遇到这个问题: 明明架构很完美,私有数据也做了接入,但项目上线三天,不但token账单爆了,模型输出结果也似乎总差点意思。
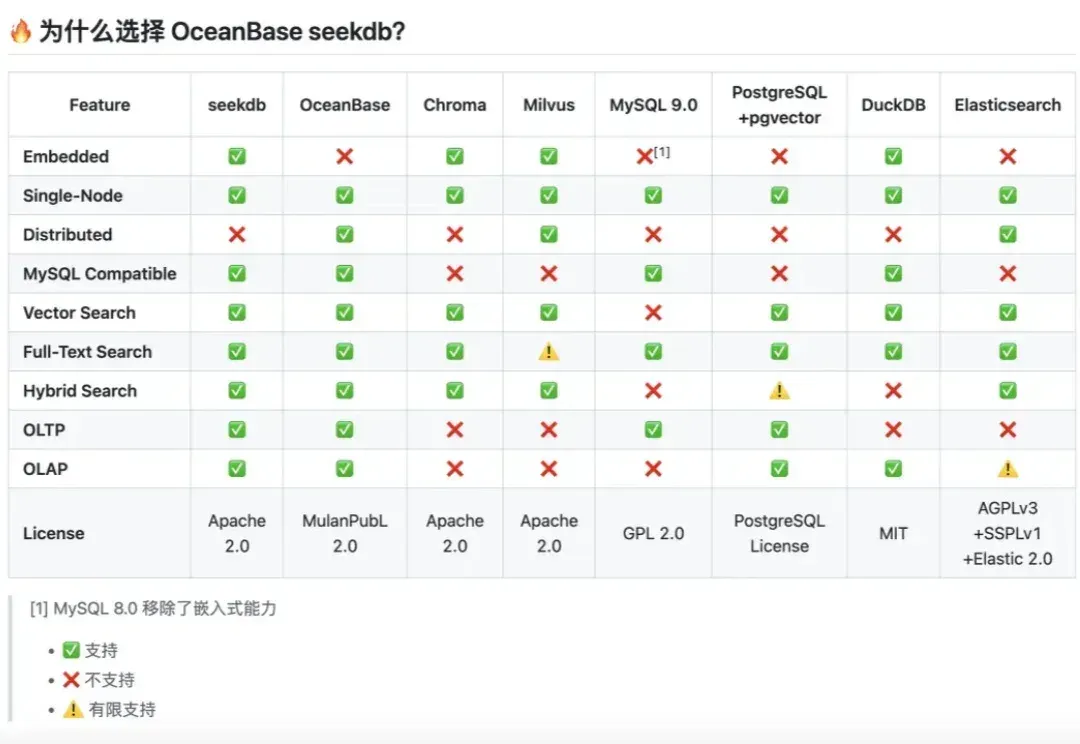
故事得从我们那个行业交流群说起。 群里都是帮搞技术架构的老朋友,平时大家最大的乐趣就是吐槽:吐槽大模型幻觉,吐槽 RAG效果差,分享新的RAG框架。 经常是今天这个说 MySQL 顶不住了,明天那个骂向量库的数据同步又挂了。 大概上个月吧,群里有个做金融项目的技术负责人,突然甩了一个 GitHub 链接出来。 说实话,当时群里刷屏快,我瞥了一眼,心想:“又是个不知名的小开源项目吧。” 毕竟这两年向量数据库赛道太卷了,GitHub 上每天都能冒出好几个号称“拳打 Milvus,脚踢 Pinecone”的新轮子。 大多数都是 Demo 级别的玩具,我手指一滑,准备直接划走。 直到我眼神往下扫,看到
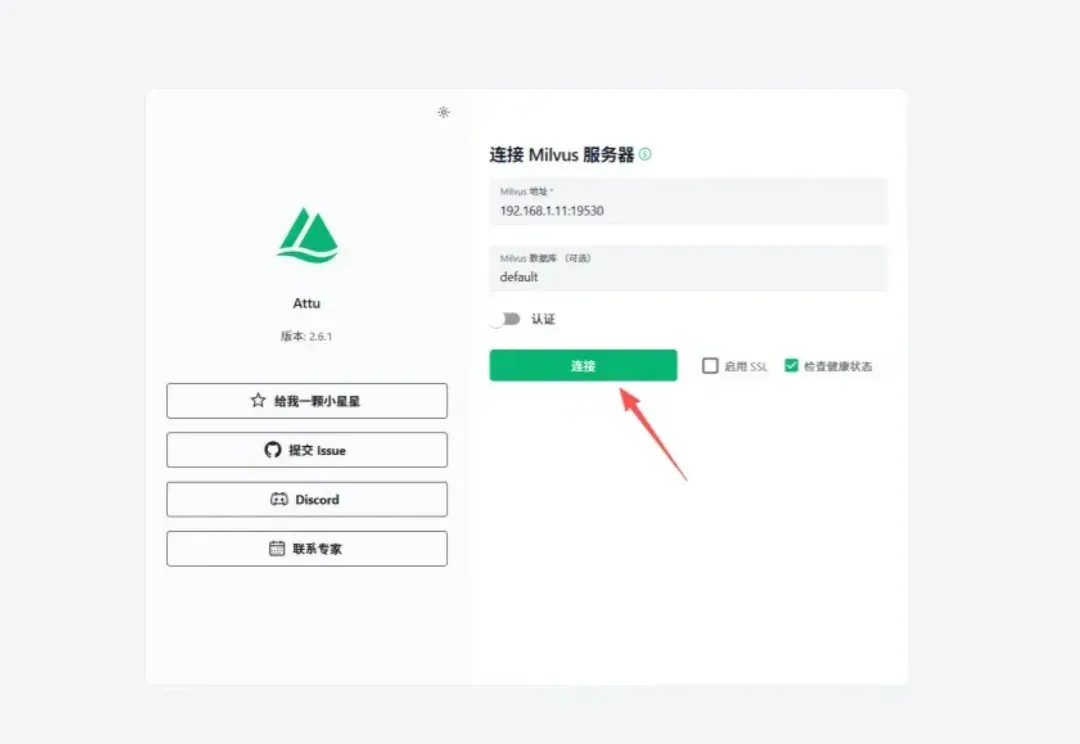
今天在讲Milvus的Attu之前,我们先来唠一段计算机行业的八卦。
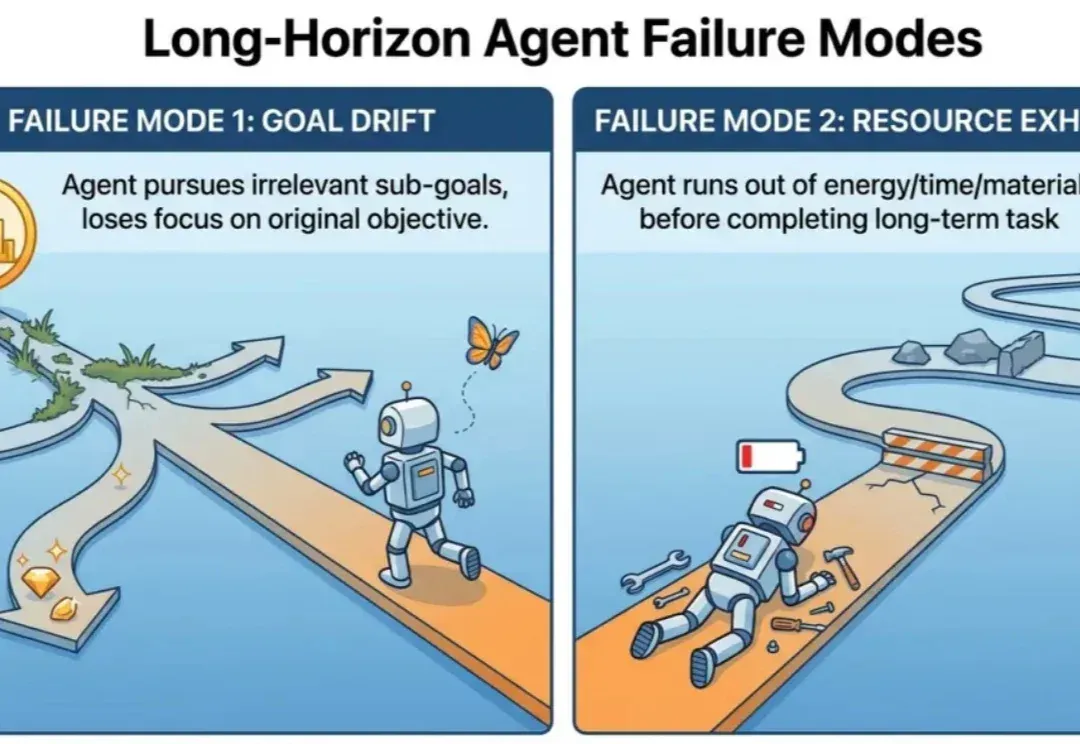
做agent简单,但是做能落地的agent难,做能落地的长周期agent更是难上加难!
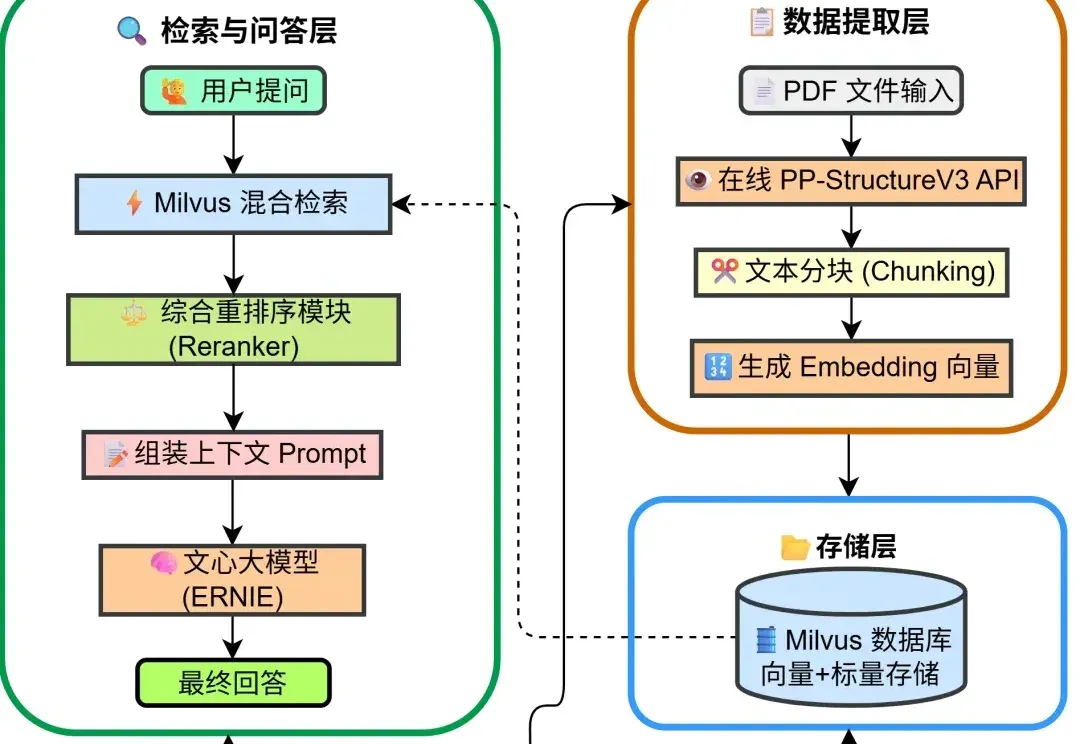
在大型语言模型(LLM)的应用落地中,RAG(检索增强生成)是解决模型幻觉和知识时效性的关键技术。
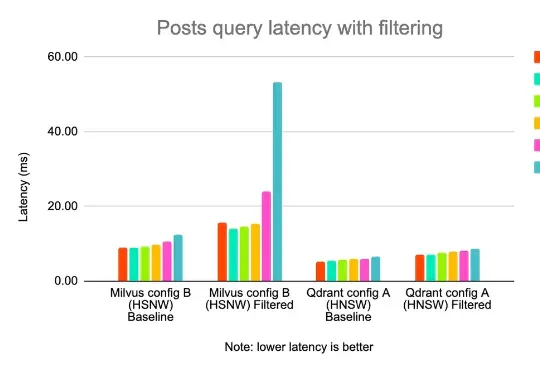
业务团队可能说他们想要个负重一吨,时速两百公里的马车…… 现如今,借助向量检索能力,实现基于语义相似度的智能搜索,已经是所有电商、推荐、社区平台技术架构的重要一环。 作为拥有约 1.08 亿日活、 1
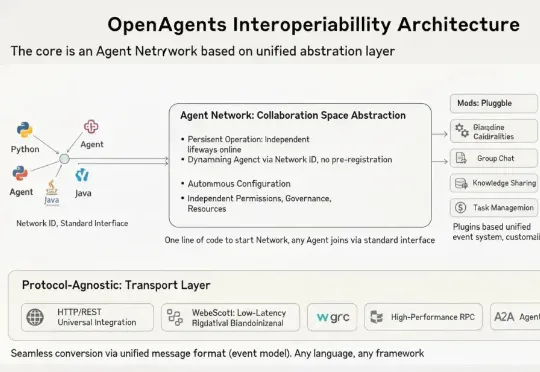
静态编排 VS 动态编排,谁是多agent系统最优解?通常来说,面对简单问题,采用react模式的单一agent就能搞定。可遇到复杂问题,单一agent就会立刻出现包括但不限于以下问题:串行执行效率低:无法同时完成并行的子步骤(如 “同时爬取 A、B 两个网站的数据”)。