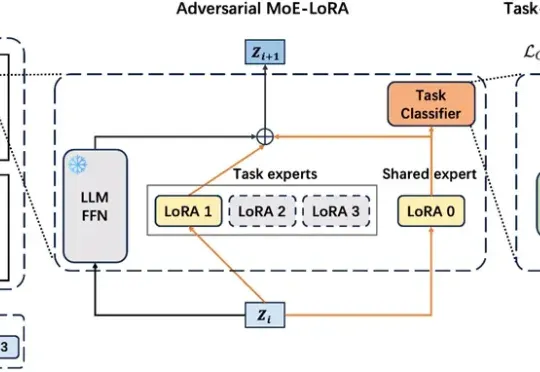
LLM工业级自进化:北邮与腾讯AI Lab提出MoE-CL架构,解决大模型持续学习核心痛点(在新窗口打开)
在工业级大语言模型(LLM)应用中,动态适配任务与保留既有能力的 “自进化” 需求日益迫切。真实场景中,不同领域语言模式差异显著,LLM 需在学习新场景合规规则的同时,不丢失旧场景的判断能力。这正是大模型自进化核心诉求,即 “自主优化跨任务知识整合,适应动态环境而无需大量外部干预”。
共 375 篇
在工业级大语言模型(LLM)应用中,动态适配任务与保留既有能力的 “自进化” 需求日益迫切。真实场景中,不同领域语言模式差异显著,LLM 需在学习新场景合规规则的同时,不丢失旧场景的判断能力。这正是大模型自进化核心诉求,即 “自主优化跨任务知识整合,适应动态环境而无需大量外部干预”。
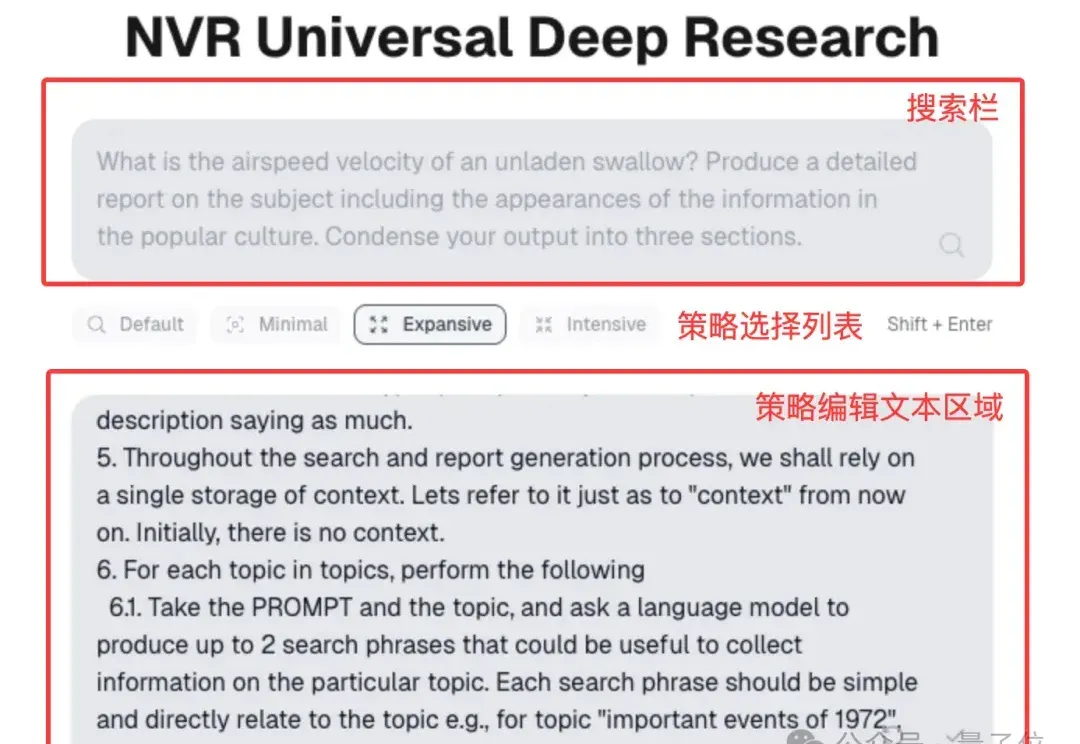
英伟达也做深度研究智能体了。 最新论文介绍了英伟达的通用深度研究(UDR)系统,该系统支持个人定制,可接入任何大语言模型(LLM)。 这意味着它能够围绕任何语言模型运行,用户可以完全自定义深度研究策略,并交给智能体实现。 为展示其通用性,英伟达还为UDR配备了带用户界面的研究演示原型,可在GitHub上下载。 网友认为,它使智能体的自主性得到了突破,非常适合企业工作。 自带模型和策略 论文介绍,以往推出的所有深度研究智能体,都采用硬编码方式,仅能通过固定的工具选择来执行特定研究策略。 而英伟达的UDR系统能够围绕任何LLM运行。 还能使用户能够在无需额外训练或微调的情况下,创建、编辑和优化他们
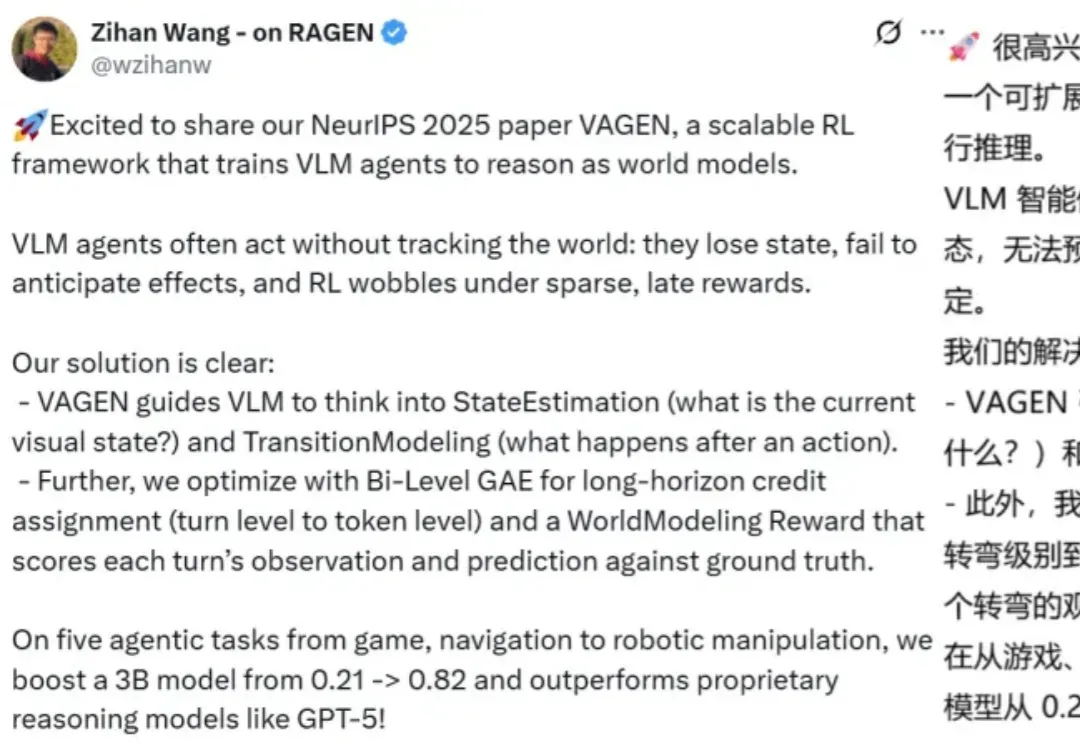
当今的 AI 智能体(Agent)越来越强大,尤其是像 VLM(视觉-语言模型)这样能「看懂」世界的智能体。但研究者发现一个大问题:相比于只处理文本的 LLM 智能体,VLM 智能体在面对复杂的视觉任务时,常常表现得像一个「莽撞的执行者」,而不是一个「深思熟虑的思考者」。
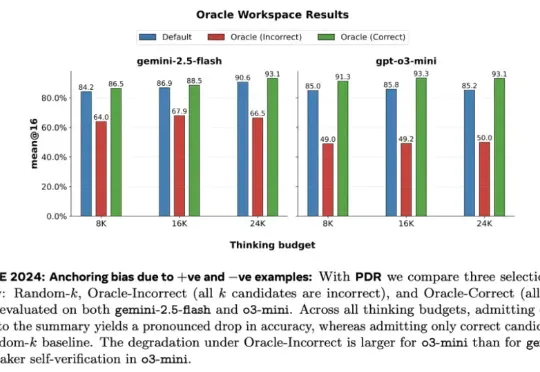
Meta 超级智能实验室、伦敦大学学院、Mila、Anthropic 等机构的研究者进行了探索。从抽象层面来看,他们将 LLM 视为其「思维」的改进操作符,实现一系列可能的策略。研究者探究了一种推理方法家族 —— 并行 - 蒸馏 - 精炼(Parallel-Distill-Refine, PDR),
近日,腾讯微信 AI 团队提出了 WeDLM(WeChat Diffusion Language Model),这是首个在工业级推理引擎(vLLM)优化条件下,推理速度超越同等 AR 模型的扩散语言模型。
众所周知,大型语言模型(LLM)的根本运作方式是预测下一个 token(词元),能够保证生成的连贯性和逻辑性,但这既是 LLM 强大能力的「灵魂」所在,也是其枷锁,将导致高昂的计算成本和响应延迟。 可
近日,浙江大学 OmniAI 团队在 《Show, Don’t Tell: Evaluating Spatial Cognition in Generative Pixels Rather Than LLM Text》 中提出 ProVisE,让图像生成模型直接在图中回答空间问题,并将视觉答案还原为原 benchmark 可以评分的结构化预测。
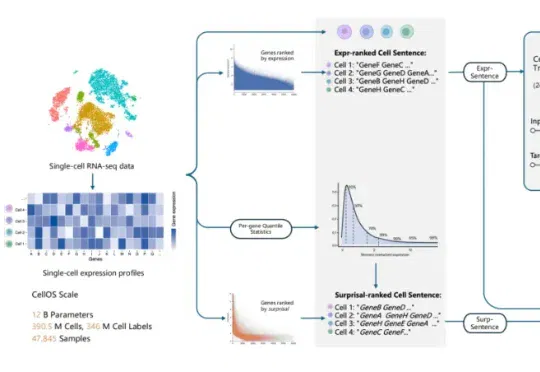
最近,AI虚拟细胞(AIVC)赛道,迎来关键突破!作为全球最早布局该领域的企业之一,百曜科技正式发布全球首个基于LLM-JEPA架构的AI虚拟细胞世界模型——AURA CellOS。
当地时间 5 月 5 日,迈阿密一家名为 Subquadratic 的公司走出隐身模式。CTO Alexander Whedon 在 X 上把首款模型 SubQ 称作“a major breakthrough in LLM intelligence”(LLM 智能领域的重大突破),
最近,一篇由中国团队领衔全球24所TOP高校机构发布,用于评测LLMs for Science能力高低的论文,在外网炸了!当晚,Keras (最高效易用的深度学习框架之一)缔造者François Chollet转发论文链接,并喊出:「我们迫切需要新思路来推动人工智能走向科学创新。」