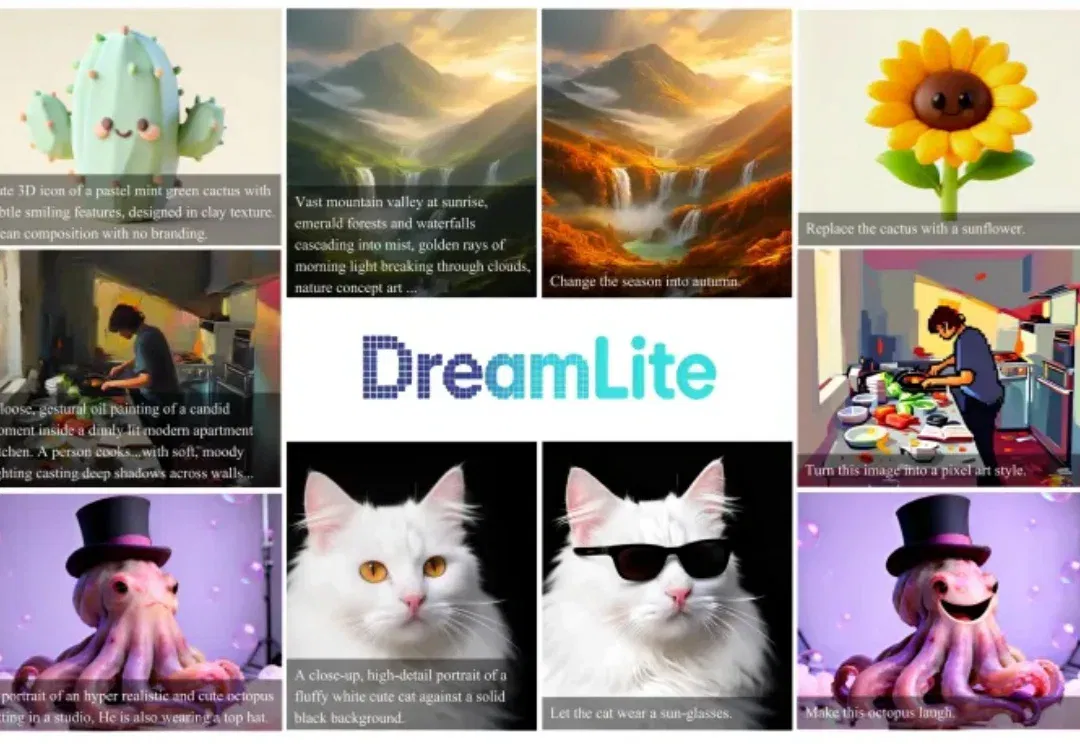
告别云端依赖!字节开源新作DreamLite让手机秒变 AI 画板(在新窗口打开)
近日,字节跳动智能创作部门(Intelligent Creation Lab)提出新作 DreamLite,一个主干网络仅有 0.39B 参数的轻量级统一扩散模型,在单一网络内同时支持文生图(Text-to-Image) 和图像编辑(Text-guided Image Editing)两个任务,是目前已知首个实现这一能力的端侧模型。
共 96 篇
近日,字节跳动智能创作部门(Intelligent Creation Lab)提出新作 DreamLite,一个主干网络仅有 0.39B 参数的轻量级统一扩散模型,在单一网络内同时支持文生图(Text-to-Image) 和图像编辑(Text-guided Image Editing)两个任务,是目前已知首个实现这一能力的端侧模型。
就在几小时前,Gemini 3.0重磅发布。随着而来的还有其颠覆性的AI原生IDE产品——Antigravity,这不只是一个新工具那么简单。谷歌的这次发布,将三个核心开发工具,AI代理(Agent)、代码编辑器(Editor)和浏览器(Browser) 集成在了一起,构建了由AI驱动、从编码、研究、测试到验证的完整闭环,一举打通了自家的生态。
相似度超越Seed-TTS、MiniMax-Speech等知名模型。昨晚,美团LongCat团队发布了文本转语音模型LongCat-AudioDiT,并开源1B、3.5B参数量的版本。这一模型的最大特点,是彻底抛弃了梅尔谱等中间表示,直接在波形潜空间进行基于扩散模型的文本转语音。通俗地说,这一模型直接根据声音本身的规律进行生成,“雕刻”出最原始的声音波形,从根源阻断数据转换的级联误差。
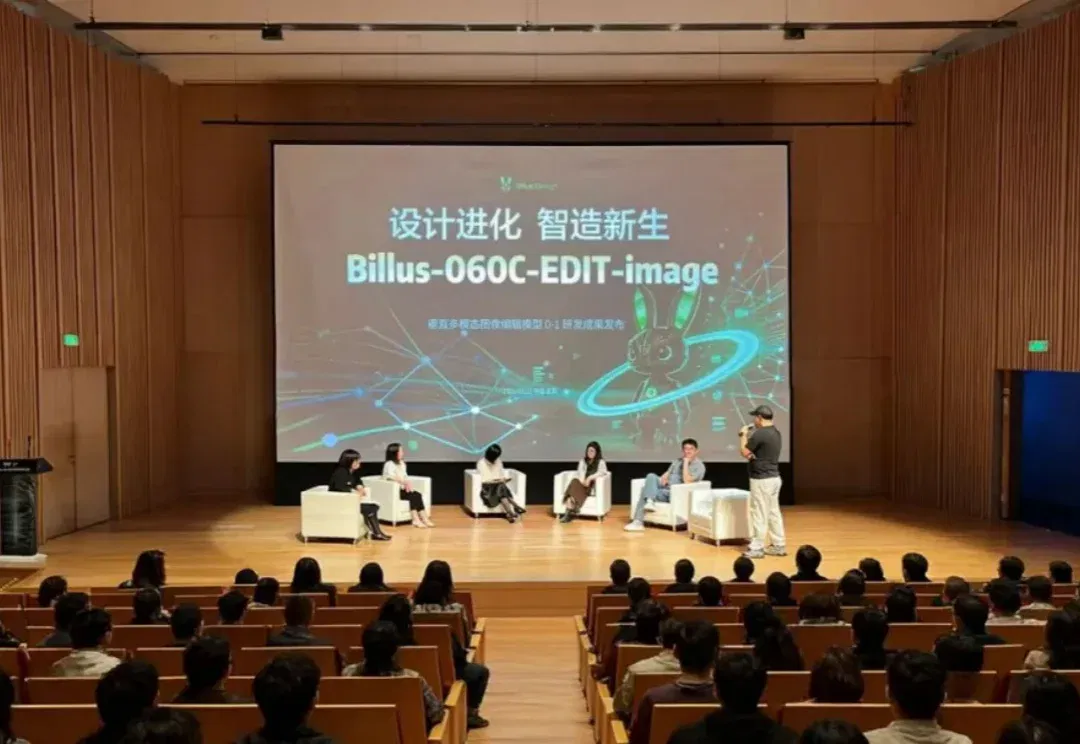
3月23日,在DIA「湾区智造」论坛上,毕鲁斯人工智能正式发布 Billus-060C-EDIT-image。为了这一刻,我们潜心打磨,终于在建筑与工业设计领域,实现了从 0 到 1 的技术研发突破。
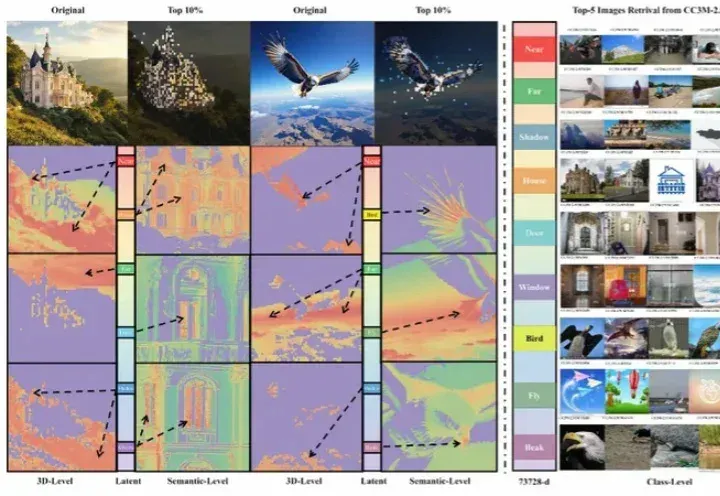
过去三年,扩散模型席卷图像生成领域。以 DiT (Diffusion Transformer) 为代表的新一代架构不断刷新图像质量的极限,让模型愈发接近真实世界的视觉规律。
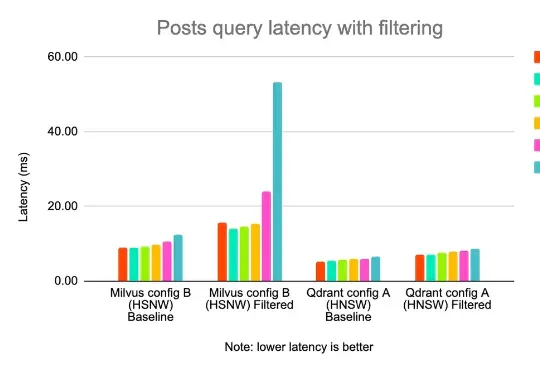
业务团队可能说他们想要个负重一吨,时速两百公里的马车…… 现如今,借助向量检索能力,实现基于语义相似度的智能搜索,已经是所有电商、推荐、社区平台技术架构的重要一环。 作为拥有约 1.08 亿日活、 1
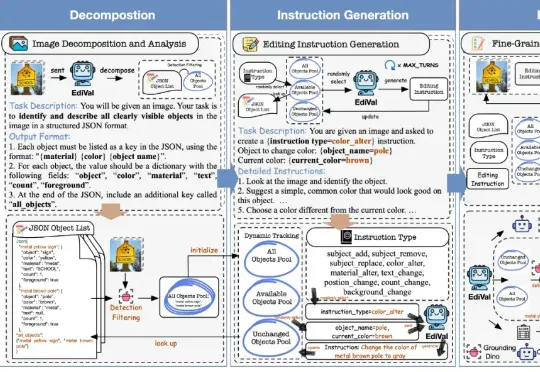
在 AIGC 的下一个阶段,图像编辑(Image Editing)正逐渐取代一次性生成,成为检验多模态模型理解、生成与推理能力的关键场景。我们该如何科学、公正地评测这些图像编辑模型?
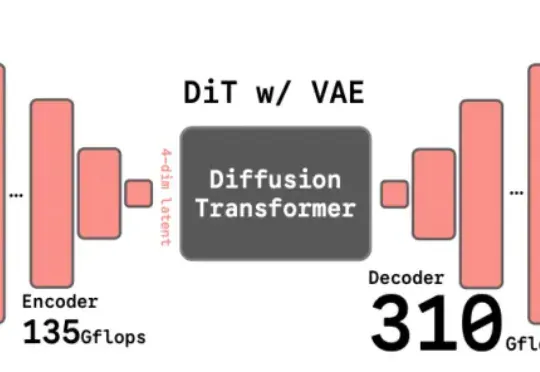
谢赛宁团队最新研究给出了答案——VAE的时代结束,RAE将接力前行。其中表征自编码器RAE(Representation Autoencoders)是一种用于扩散Transformer(DiT)训练的新型自动编码器,其核心设计是用预训练的表征编码器(如DINO、SigLIP、MAE 等)与训练后的轻量级解码器配对,从而替代传统扩散模型中依赖的VAE(变分自动编码器)。
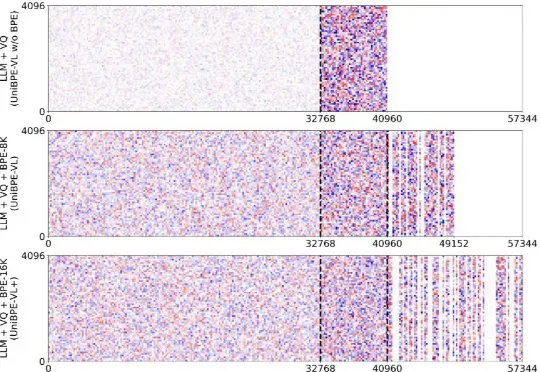
为此,北大、UC San Diego 和 BeingBeyond 联合提出一种新的方法——Being-VL 的视觉 BPE 路线。Being-VL 的出发点是把这一步后置:先在纯自监督、无 language condition 的设定下,把图像离散化并「分词」,再与文本在同一词表、同一序列中由同一 Transformer 统一建模,从源头缩短跨模态链路并保留视觉结构先验。
阿里、王慧文家办都投了。 智东西7月14日报道,今日,北京AI视频独角兽爱诗科技宣布完成整体C轮融资,本轮累计融资29.8亿元人民币。 其中,C+轮由阿里巴巴领投,Lollapalooza Capital(王慧文家办)、常春藤资本、惠远资本、钟鼎资本、韩国未来资产、OCBC生态旗下Lion X基金、蓝色光标、CloudAlpha、iGlobe Partners等十余家机构参投。 爱诗科技计划将本轮资金主要用于视频生成基础模型、实时世界模型研发,以及全球化产品增长和产业场景落地。 爱诗科技成立于2023年4月,专注于AI视频生成大模型及相关产品的研发应用,是国内首个发布DiT架构视频生成模型的初