曝DeepSeek来了位90后CFO(在新窗口打开)
DeepSeek据悉将迎来高瓴创投90后合伙人严文韬出任CFO,同时已聘请中信证券筹备上海科创板IPO,并近期发布了DeepSeek V4.1 Flash模型,资本与产品双线加速推进。
共 40 篇
DeepSeek据悉将迎来高瓴创投90后合伙人严文韬出任CFO,同时已聘请中信证券筹备上海科创板IPO,并近期发布了DeepSeek V4.1 Flash模型,资本与产品双线加速推进。
月之暗面发布2.8万亿参数后训练模型Kimi K3.1 Pro,其综合智能指数领先DeepSeek V4.1 Flash-1017和MiniMax M3.1 Flash,但API费用最高,并正研发Flash版本以平衡能力、成本与商业化。
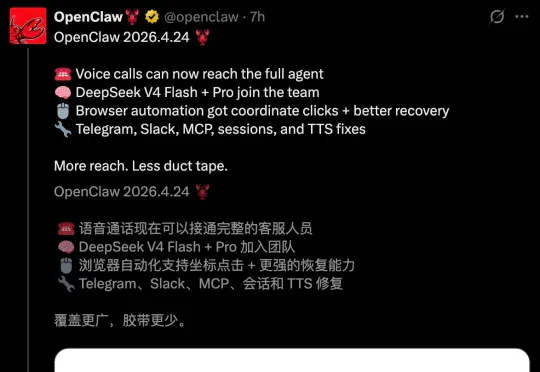
OpenClaw最新版本官宣,DeepSeek V4 Flash正式成为默认大模型,250k+星标的全球最火开源Agent框架,把中国最强开源AI推上了C位。
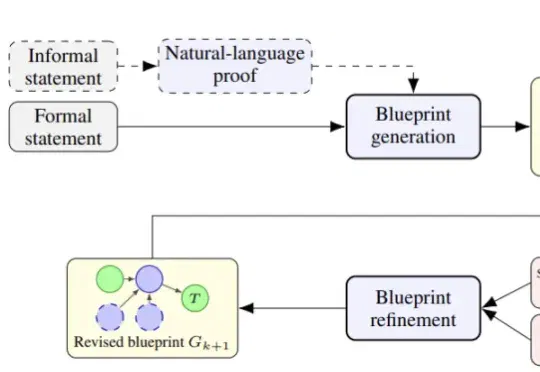
近日,普林斯顿大学的研究团队发布了一篇新论文,提出了一个名为 Goedel-Architect 的智能体框架。他们用的核心模型,是国内开源大模型 DeepSeek-V4-Flash。
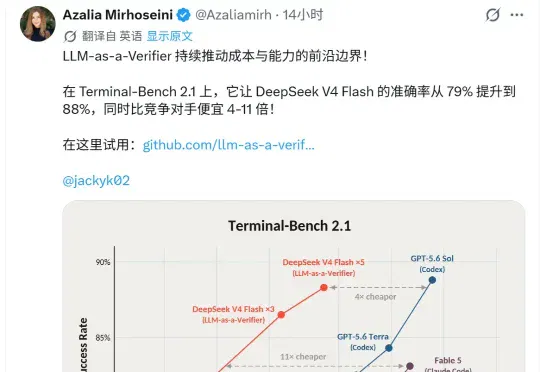
同样的模型,同样的任务,让它执行五遍,再让他自己挑一遍最稳的,效果能有多大提升?斯坦福把这套玩法用在了AI身上,DeepSeek V4 Flash在Terminal-Bench 2.1的成绩从79%一路涨到88%,反超了尖子生Fable 5。而且连做五遍加挑选这一通折腾,价格依然比Fable 5便宜了4-11倍。
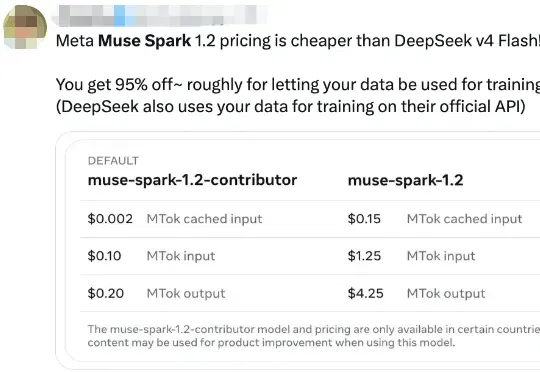
今日,Meta推出其首款编程Agent——Muse Code(测试版),以及该Agent搭载的新一代模型Muse Spark 1.2。模型一经面世便引发海外热议,核心关注点直指定价策略:比DeepSeek-V4-Flash更便宜。如果用户允许Meta用他们的数据训练模型,就能享受95折优惠。
创新工场汪华与Floatboat.ai创始人谭少卿对话指出,腾讯WorkBuddy、字节豆包工作、阿里千问办公等大厂AI办公会战已完成Agent市场教育,GLM-5.3-Flash和DeepSeek-V4-Flash等国产模型跨过能力门槛,巨头的壁垒仅剩资金,而中国创业者凭借贴近开源模型生态的优势,有望在垂直Agent领域找到更多机会。
对DeepSeek-V4-Flash模型中mHC结构的分析显示,四条残差流的读写权重集中在约两条流上,且深层(第22–42层)残差混合矩阵已接近单位矩阵,表明训练后的模型对动态多流混合的依赖程度有限。
27B正在成为本地AI的新选择。 一个能塞进24GB家用显卡的开源模型,凭什么被开发者称为新模型的斩杀线? 答案藏在一张榜单里:在Artificial Analysis最新的Intelligence Index上拿到了52分,和GPT-5.6 Luna、DeepSeek-V4-Flash打成平手。换句话说,往后再发小模型,够不到这条线,就很难再让人提起兴趣。 它就是刚刚开源的Qwen3.8-27B。 而比这个分数更让个人开发者上心的一点是:这一次,它是真的能被下载回家、跑在自己电脑上的。 Qwen3.8-27B在正式开放权重之前,海外开源社区已经等了好一阵。 量化版本什么时候出来,24GB显存
这两天,AI圈百家争鸣。GPT-6曝光、DeepSeek V4 Flash公测、SD2.5发布、MiniMax多模态开源视频模型发布……