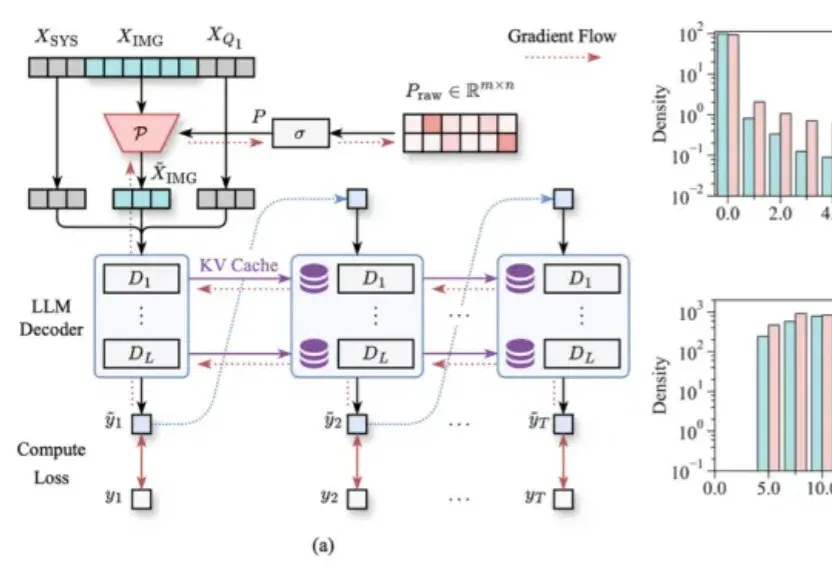
只看图片就能学会压缩Token!浙大&阿里新框架多轮VQA压缩率90%,精度不掉|CVPR 2026(在新窗口打开)
多轮视觉问答,正在成为LVLM推理效率的“照妖镜”。
共 62 篇
多轮视觉问答,正在成为LVLM推理效率的“照妖镜”。
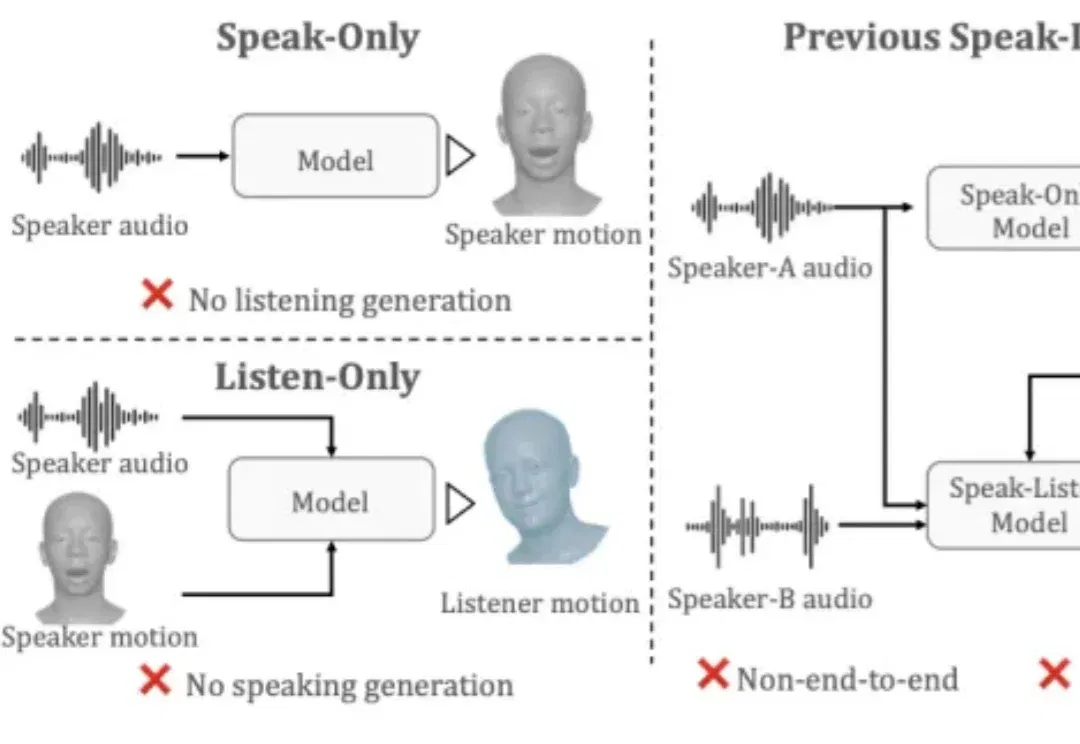
在游戏 NPC、虚拟主播、在线客服等数字人对话场景中,倾听时的 “扑克脸” 问题一直是行业长期痛点 —— 虚拟人说话时口型可以做到精准同步,但倾听时却表情僵硬、毫无反应,严重影响对话的自然感和沉浸感。盛大 AI 研究院(东京)与东京大学联合提出 UniLS(Unified Listening and Speaking),首个仅凭双轨音频即可端到端同时驱动说话和倾听面部动作的统一框架。
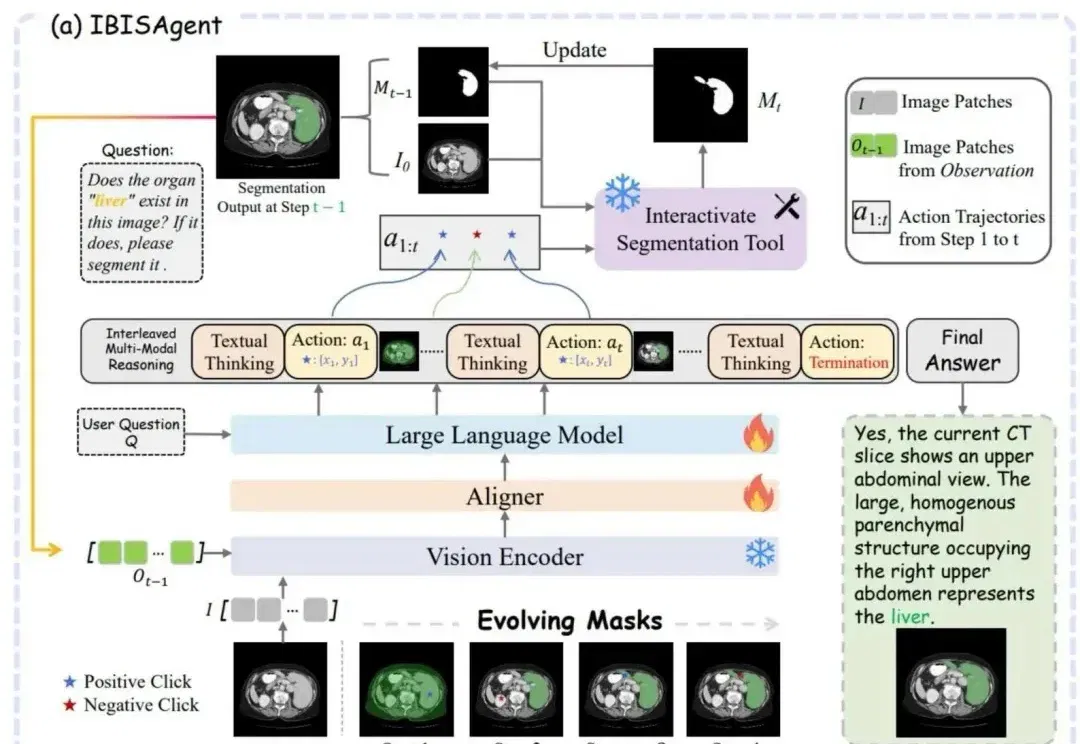
这个生物医学视觉推理框架,被CVPR 2026接收了!
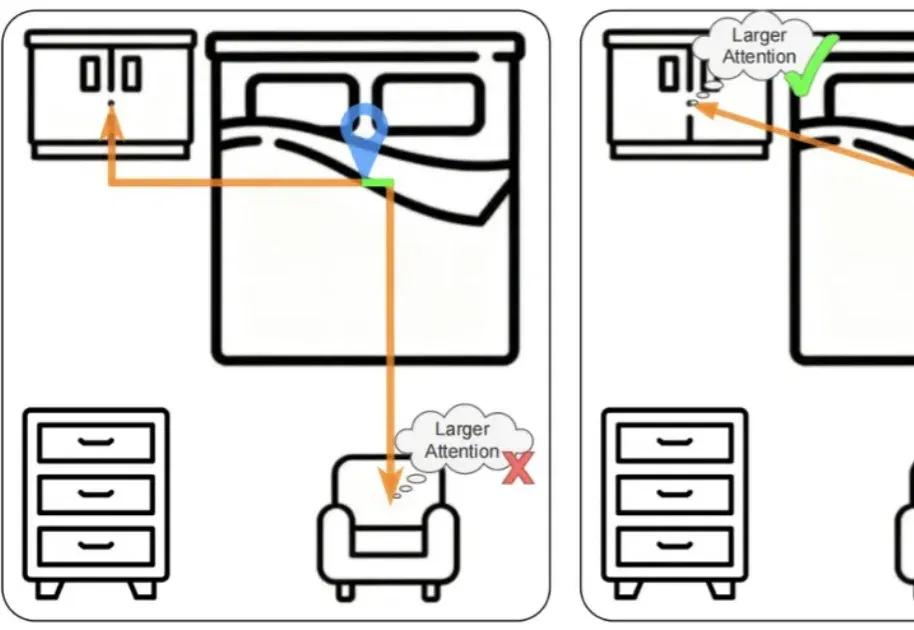
本文主要介绍来自该团队的最新论文:Scalable Object Relation Encoding for Better 3D Spatial Reasoning in Large Language Models。
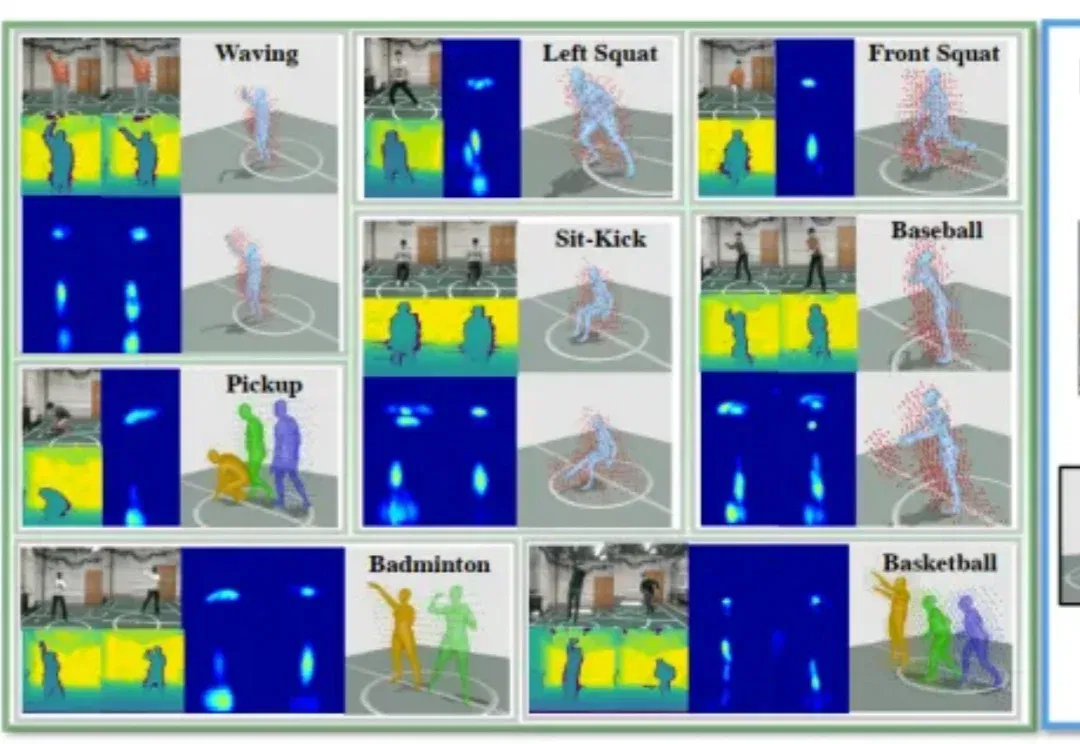
想象几个并不遥远的场景: 医院的病房里,刚做完手术的患者正在练习下床、走动,智能系统通过摄像头捕捉他的动作,判断步态是否稳定、有没有跌倒风险;回到家,在卧室或浴室这样私密的空间里,老人起身、转身、洗漱,甚至意外滑倒的瞬间,也可能被视觉传感器记录,只为了让 AI 能更早发现异常;
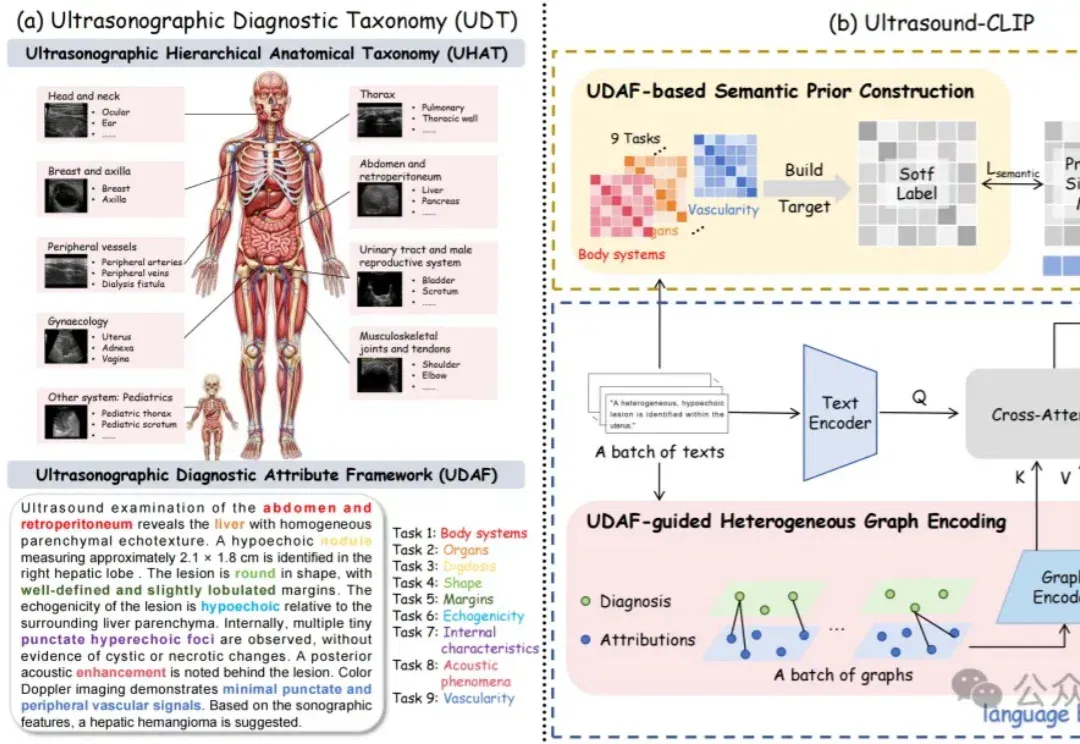
超声领域也有大模型了! 超声影像凭借实时、无辐射的优势,成为临床各场景的一线诊断手段。 但异质的解剖结构、多样的诊断属性,让通用视觉语言预训练模型难以直接适配,且现有医疗跨模态数据中超声样本占比不足5%,成为领域研究的核心瓶颈。 △ 超声图像统计数据跨越主要基准点的分布情况。 上图红色区域和内部百分比显示了超声图像所占的比例,而蓝色区域则展示了其余模态的占比情况。顶部标签表示绝对数量(以千为单位)。论文中所提出的US-365K是首个大规模、100%专用于超声影像的数据集。 针对这一问题,浙大城市学院联合浙江大学、香港城市大学、香港浸会大学、浙江大学医学院附属第一医院、浙江大学医学院附属妇产科医
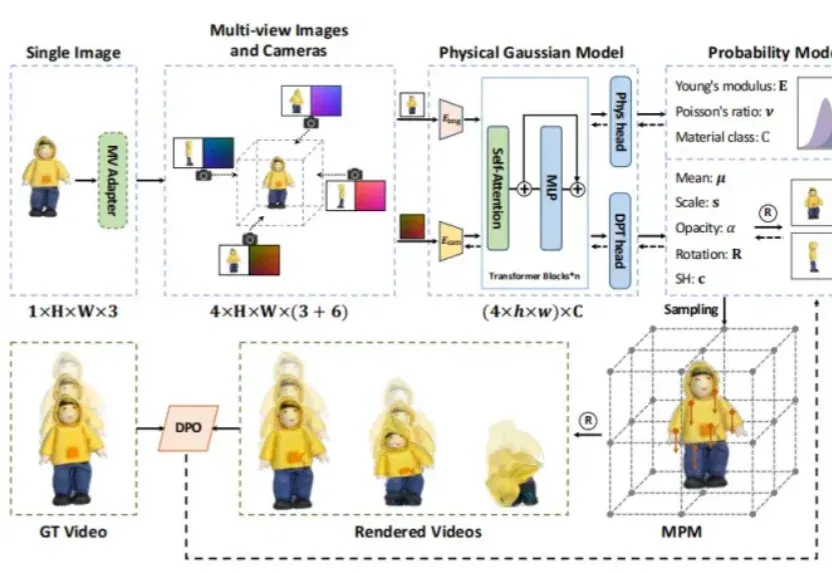
让静态的图片变成三维物体并动起来已经不算新鲜,但如果让图片不仅动起来,还能完美遵循现实世界的物理规律(比如蛋糕的Q弹、沙堆的散落、石雕的坚硬)呢?
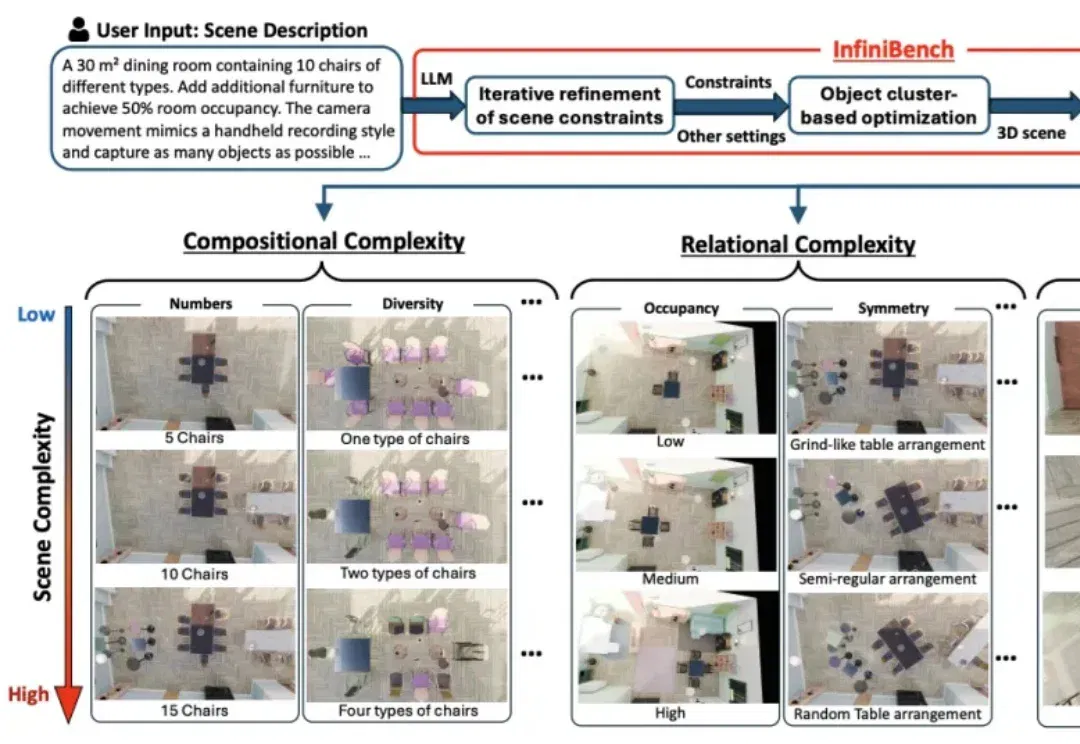
VLM看图像描述头头是道,一遇到3D空间推理就“晕菜”。
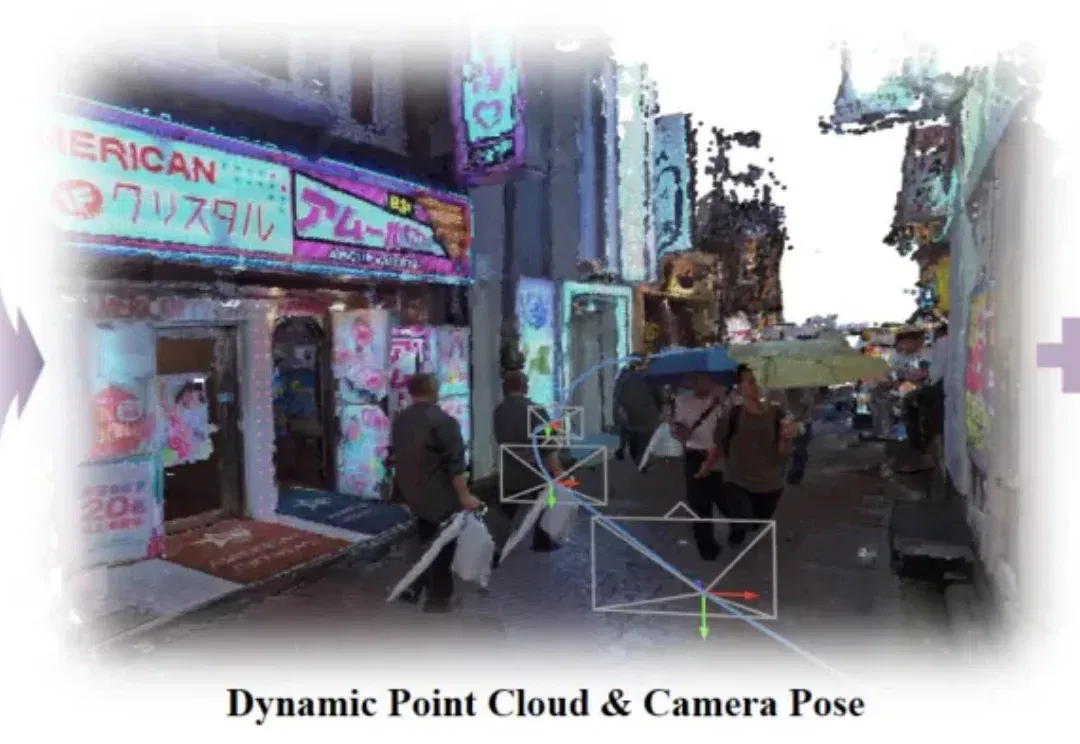
SLAM 在自动驾驶、机器人、AR/VR 乃至具身智能系统中都是至关重要的环节,它决定了算法能否在一个陌生环境中一边“看懂世界”,一边“知道自己在哪”。
如果把手机屏幕想象成一个舞台,GUI 智能体就是台下那个 “被授权动手” 的人:它能看懂屏幕上的按钮、输入框和弹窗,能按你的指令去点、去滑、去输入。