天下苦VAE久矣:阿里高德提出像素空间生成模型训练范式, 彻底告别VAE依赖(在新窗口打开)
近年来,基于扩散模型的图像生成技术发展迅猛,催生了Stable Diffusion、Midjourney等一系列强大的文生图应用。然而,当前主流的训练范式普遍依赖一个核心组件——变分自编码器(VAE),这也带来了长久以来困扰研究者们的几个问题:
共 65 篇
近年来,基于扩散模型的图像生成技术发展迅猛,催生了Stable Diffusion、Midjourney等一系列强大的文生图应用。然而,当前主流的训练范式普遍依赖一个核心组件——变分自编码器(VAE),这也带来了长久以来困扰研究者们的几个问题:
由两名00后大学生创办的美国AI训练数据公司AfterQuery五个月内估值从3亿美元升至32亿美元,其数据已用于英伟达Nemotron 3 Ultra模型训练,并与Thinking Machines Lab、Legora及部分中国AI实验室合作。
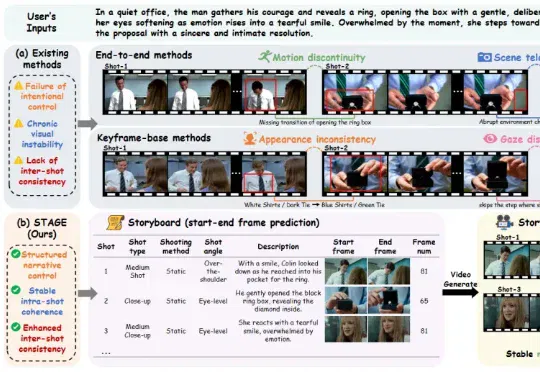
目前,该论文已录用至 CVPR 2026,相关数据集和模型训练训练和推理代码将逐步开源:究其原因,一个好故事并非一堆漂亮镜头的简单拼接,而是一个有结构、有逻辑的叙事整体。
随着 MiniMax M2.5 的发布并在社区引发热烈反响,很高兴能借此机会,分享在模型训练背后关于 Agent RL 系统的一些思考。 在大规模、复杂的真实世界场景中跑 RL 时,始终面临一个核心难
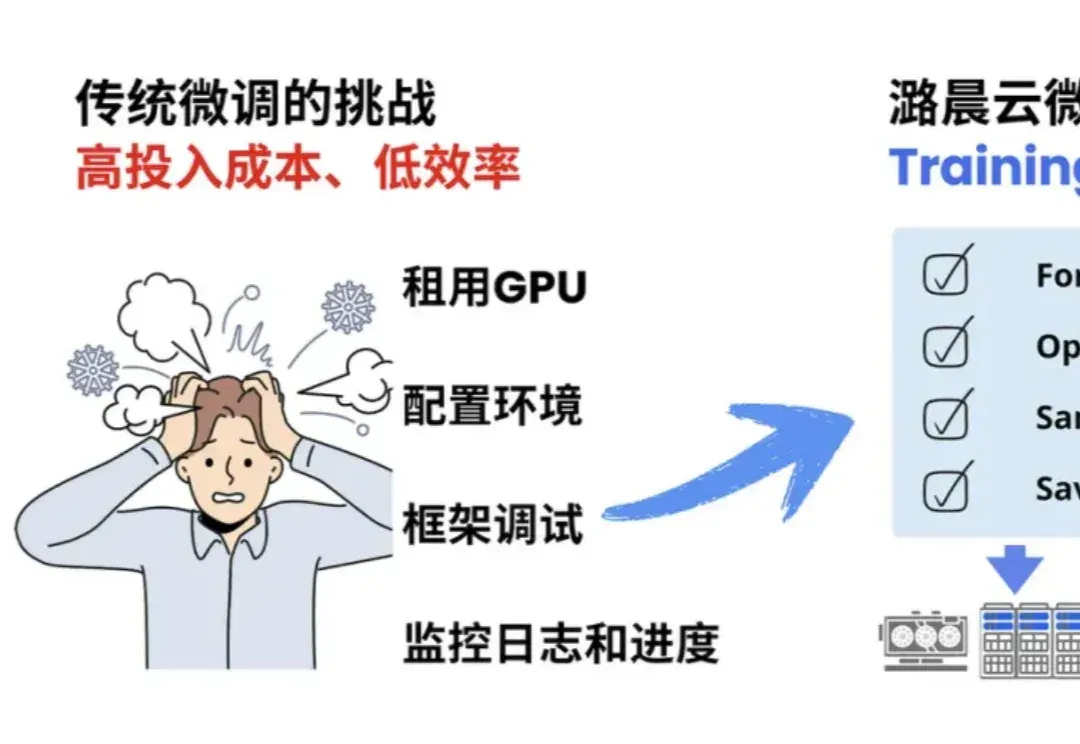
当 OpenAI 前 CTO Mira Murati 创立的 Thinking Machines Lab (TML) 用 Tinker 创新性的将大模型训练抽象成 forward backward,optimizer step 等⼀系列基本原语,分离了算法设计等部分与分布式训练基础设施关联,
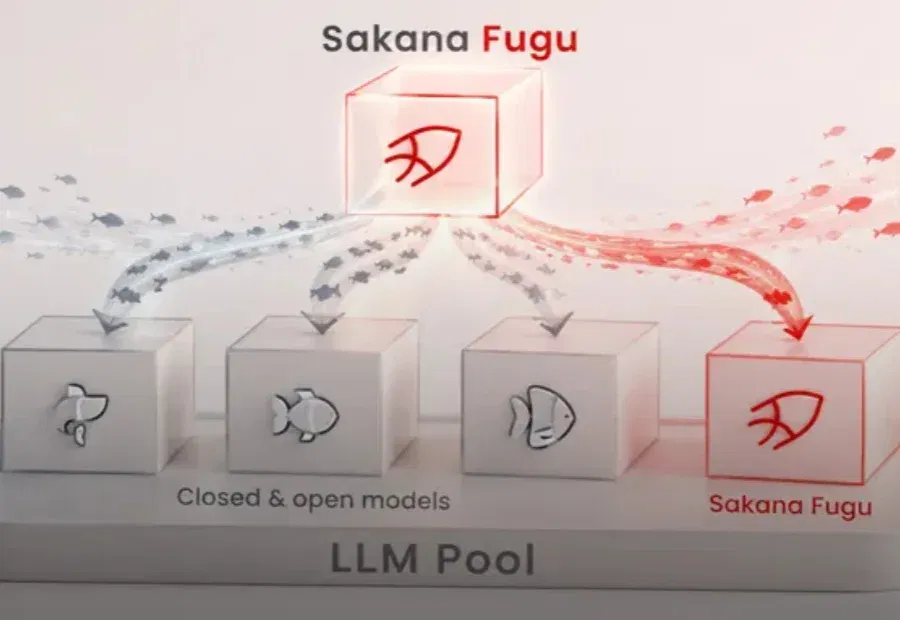
Sakana AI提出大模型训练新思路。 智东西6月22日报道,今天,日本AI独角兽Sakana AI发布了Sakana Fugu系列编排器模型,包括Fugu Ultra和Fugu两款模型。其中Fugu Ultra模型在工程、科学和推理基准测试中,性能接近或超越了Fable 5以及Mythos Preview等顶尖模型。 和传统大语言模型不同的是,Sakana Fugu不会自己回答问题,它会调用世界上各种模型来完成任务。简单来说,Sakana Fugu像一个“总指挥”,会根据任务选择最佳的模型来处理。 Fugu在日文中是河豚的意思,从官方发布的动画可以看出,Sakana Fugu是要用多个“小
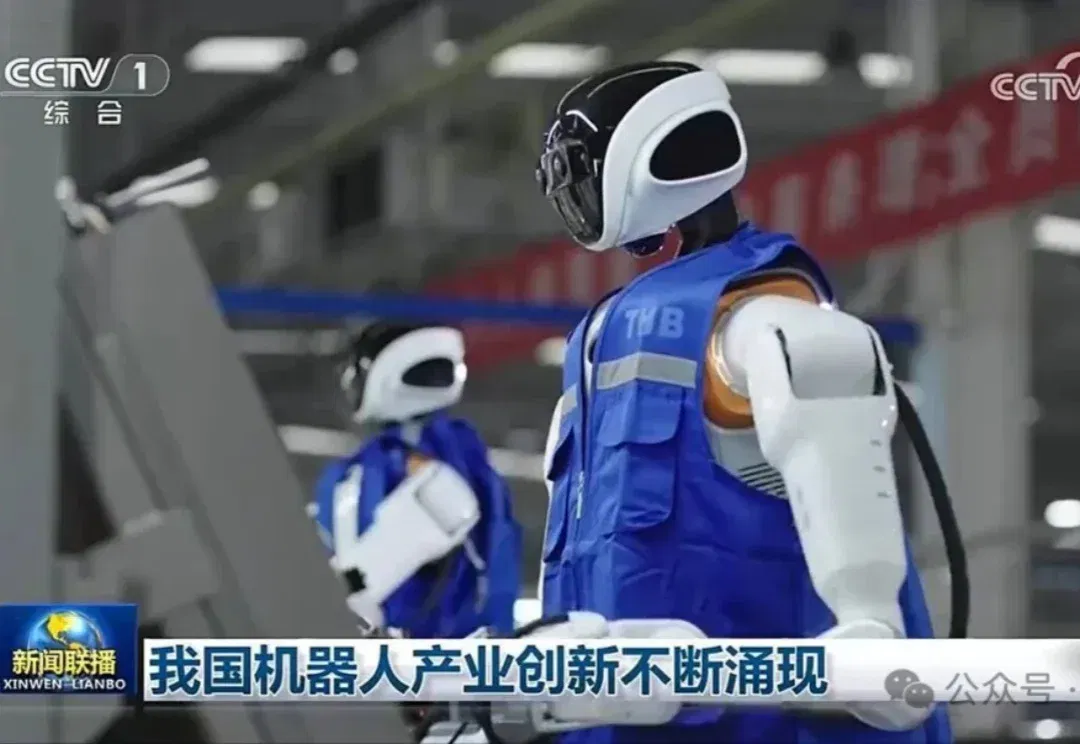
长期以来,机器人系统大多依赖专有模型。 一旦物体、场景或控制方式发生变化,往往就要重新进行数据采集、模型训练和部署调试。 如今,具身智能正步入以规模化落地为核心的下半场,较量的已不再是能否完成单点任务,而是同一套智能系统能否跨越环境、本体与任务边界,实现能力迁移与复用。 近日,它石智航通用具身大模型AWE3.7(AI World Engine)在十天内连续密集发布一系列任务,用同一颗“具身大脑”,贯通工业产线、物流作业、生活服务与移动操作等多场景,以真实任务回应了具身智能如何实现“通用泛化”这一行业命题。 工业产线:精度、力度与稳定性的三重考验 工业现场是检验具身智能的硬尺度——毫米级对位、实
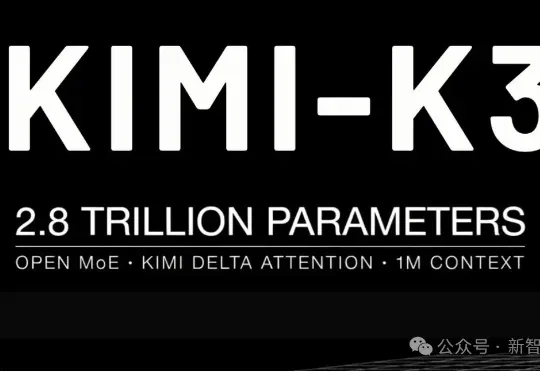
就在刚刚,全球首个3万亿参数级开源模型Kimi K3正式开源!https://github.com/MoonshotAI/Kimi-K3/tree/main。Moonshot AI宣布,发布Kimi K3的模型权重、技术报告,并开源支撑Kimi K3模型训练的关键Infra技术:MoonEP、FlashKDA和AgentEnv。
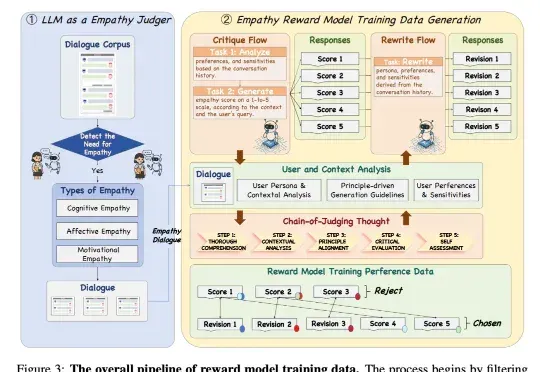
近日,来自 NatureSelect(自然选择)的研究团队 Team Echo 发布了首个情感大模型 Echo-N1,提出了一套全新的「情感模型训练方法」,成功将 RL 用在了不可验证的主观情感领域。仅 32B 参数的 Echo-N1,在多轮情感陪伴任务中胜率(Success Rate)达到 46.7%。作为对比,
两年前因在字节跳动实习期间恶意篡改代码、干扰模型训练任务而被辞退,随后遭字节起诉索赔800万元的田柯宇,已经带着一家世界模型实验室重回牌桌。团队只有约 10 个人,没有公开公司名字,没有推出产品 demo ,完整模型预计要到 2027 年才发布,但已经融到近 3000 万美元,投后估值 2 亿美元。