CVPR 2026 | 还在为AI「鬼画符」发愁?TextPecker即插即用破解文字渲染难题(在新窗口打开)
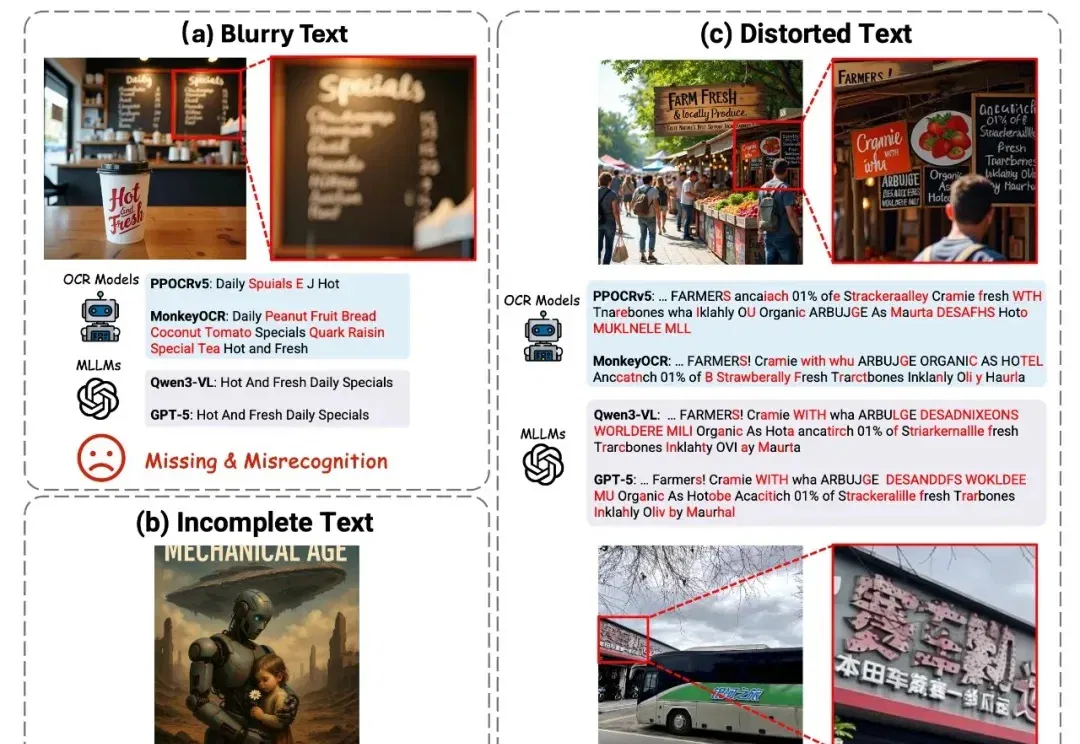
在生成式 AI 浪潮中,文生图技术已实现跨越式发展,在视觉呈现上达到了前所未有的高度。然而,在生成图像中准确合成拼写正确、结构规范且风格协调的文字 —— 视觉文本渲染(Visual Text Rendering, VTR),至今仍是该领域尚未攻克的核心难题。
共 43 篇
在生成式 AI 浪潮中,文生图技术已实现跨越式发展,在视觉呈现上达到了前所未有的高度。然而,在生成图像中准确合成拼写正确、结构规范且风格协调的文字 —— 视觉文本渲染(Visual Text Rendering, VTR),至今仍是该领域尚未攻克的核心难题。
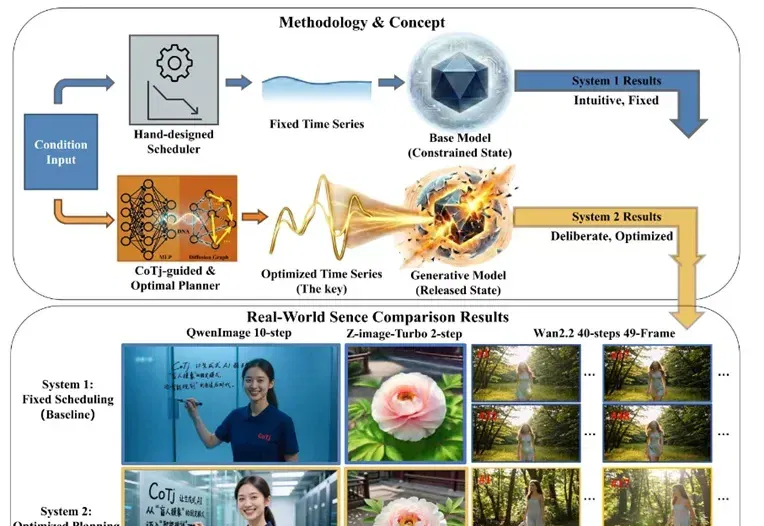
扩散模型终于学会“看题下菜碟”了! 一直以来,文生图模型都是“凭直觉”作画——不管提示词是“黑色的天空”还是“梵高风格的漩涡星空”,都死板地用同一套固定步数采样。 结果就是:简单题算力过剩,复杂题细节崩坏。 中国联通数据科学与人工智能研究院联合高校提出的新框架“轨迹链”(CoTj),彻底打破了这一僵局。它让扩散模型拥有了“系统2”的规划能力,能根据提示词的复杂程度,动态分配计算资源。 更颠覆的是,在5步的极端压缩下,CoTj规划出的轨迹配上最朴素的1阶求解器,画质居然吊打了传统方法配高阶求解器——证明“找对路”比“用什么交通工具”更重要。 目前,该研究的论文已在arXiv发布,推理代码也已开源
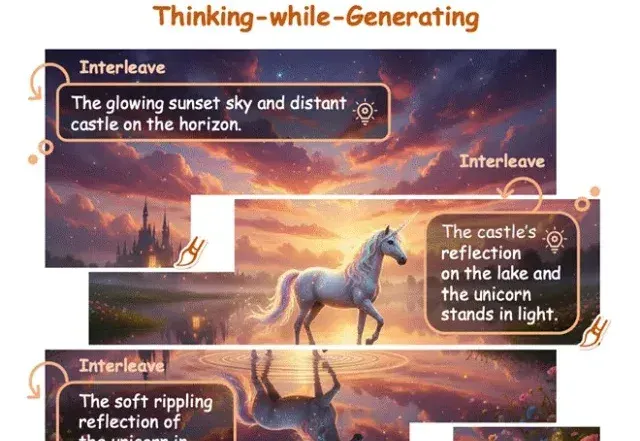
在文生图(Text-to-Image)和视频生成领域,以FLUX.1、Emu3为代表的扩散模型与自回归模型已经能生成极其逼真的画面。
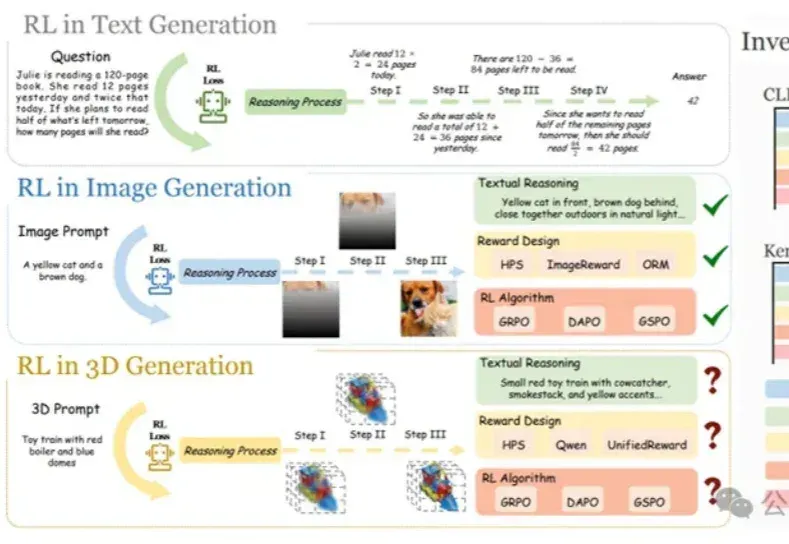
在大语言模型和文生图领域,强化学习(RL)已成为提升模型思维链与生成质量的关键方法。
今日,美团正式发布并开源图像生成模型LongCat-Image,这是一款在图像编辑能力上达到开源SOTA水准的6B参数模型,重点瞄准文生图与单图编辑两大核心场景。在实际体验中,它在连续改图、风格变化和材质细节上表现较好,但在复杂排版场景下,中文文字渲染仍存在不稳定的情况。
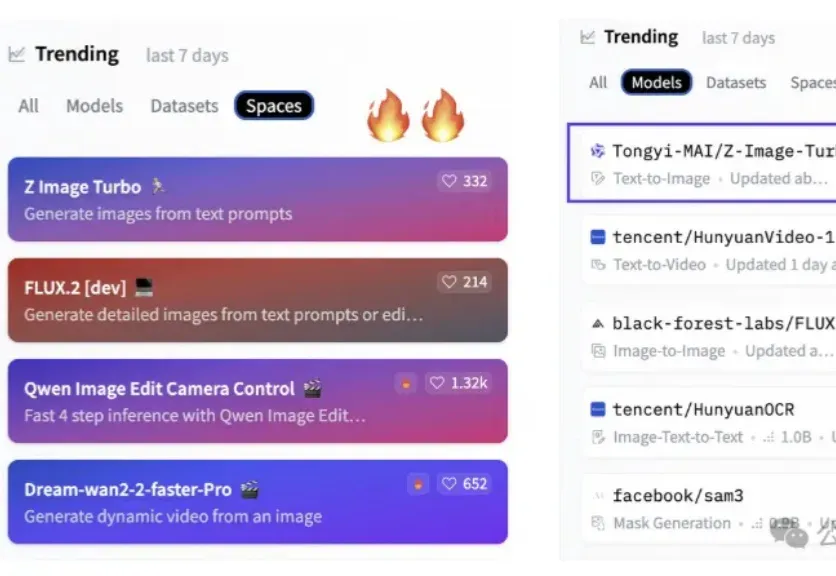
6B小模型,首日下载量高达50万次,上线不到两天直接把HuggingFace两个榜单都冲了个第一。
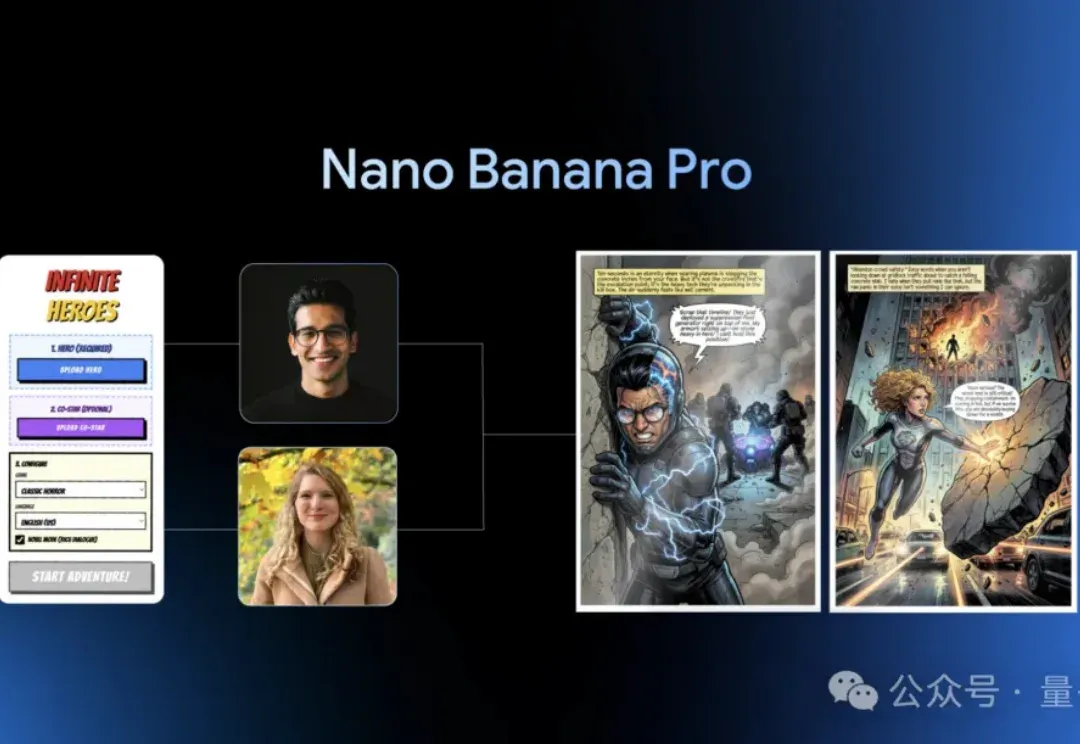
谷歌乘胜追击!Gemini 3 Pro好评如潮没两天,最强文生图模型Nano Banana也推出Pro版本。
LayerComposer革新了个性化图像生成,让用户像在Photoshop里一样自由操控元素位置、大小,解决传统方法交互性与多主体扩展难题,实现更自然、高效的创作,推动个性化生成迈向主动交互新阶段。
近年来,基于扩散模型的图像生成技术发展迅猛,催生了Stable Diffusion、Midjourney等一系列强大的文生图应用。然而,当前主流的训练范式普遍依赖一个核心组件——变分自编码器(VAE),这也带来了长久以来困扰研究者们的几个问题:
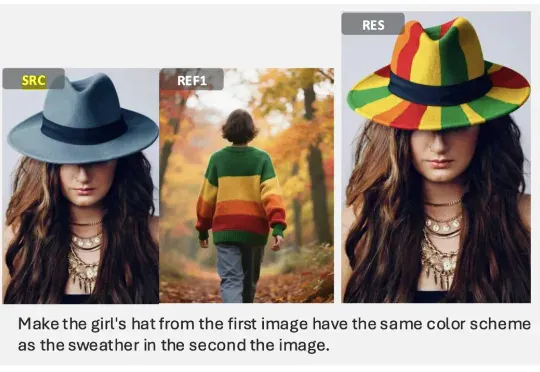
两周前,港科大讲座教授、冯诺依曼研究院院长贾佳亚团队开源了他们的最新成果 DreamOmni2,专门针对当前多模态指令编辑与生成两大方向的短板进行了系统性优化与升级。该系统基于 FLUX-Kontext 训练,保留原有的指令编辑与文生图能力,并拓展出多参考图的生成编辑能力,给予了创作者更高的灵活性与可玩性。