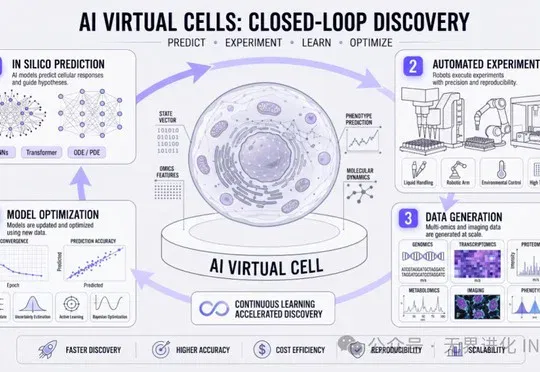
INFevo宣布完成超亿元Pre-A轮融资,推进细胞模型与科研平台(在新窗口打开)
INFevo披露完成超亿元Pre-A轮融资,用于模型研发、科研产品和团队建设。报道介绍OCOO-T等模型的实验指标及平台布局,相关成绩属于所述数据集和任务。
共 74 篇
INFevo披露完成超亿元Pre-A轮融资,用于模型研发、科研产品和团队建设。报道介绍OCOO-T等模型的实验指标及平台布局,相关成绩属于所述数据集和任务。
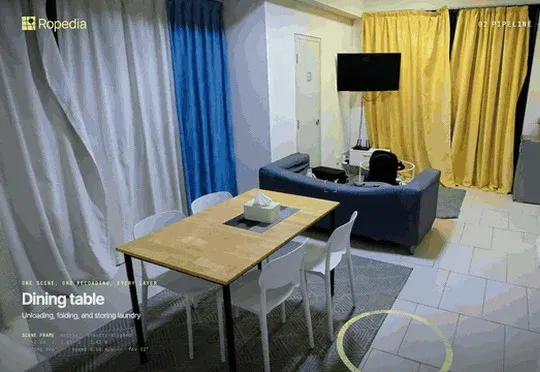
数据集把场景几何、录像和身体轨迹放入同一坐标,演示仿真转换、动作重定向和轨迹生成,真机训练收益仍需后续检验。
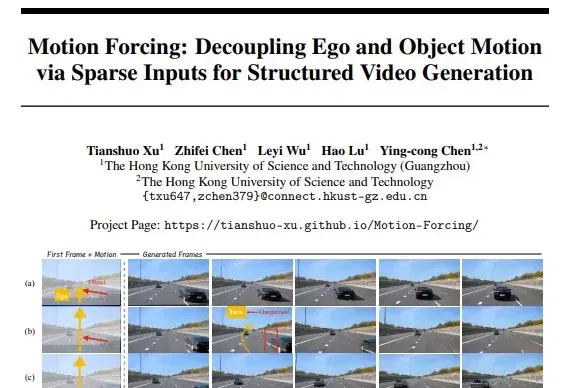
港科大(广州)团队在 Waymo 数据集的 100 段样本上比较生成效果。Motion Forcing 在所用的运动连贯性与物理合理性指标上得分更优。
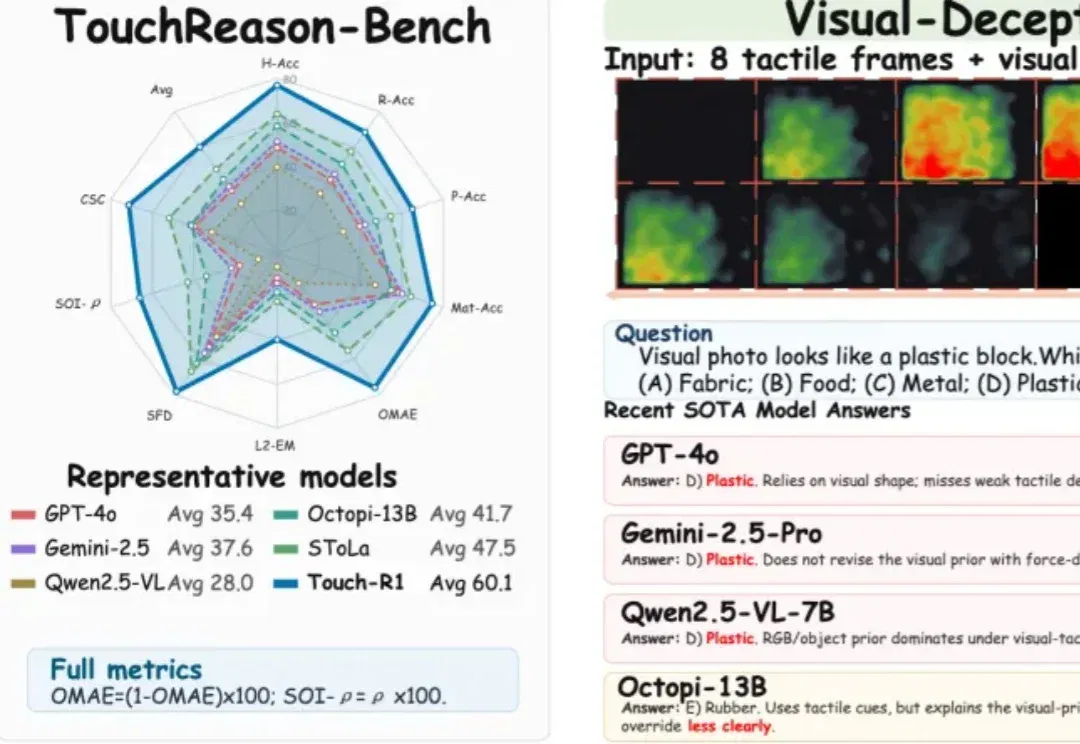
Touch-R1 团队构建 TouchReason-1M 数据集,将四种视触觉传感器的观测用于问答和推理,并在所设评测上报告 60.1 的综合分。
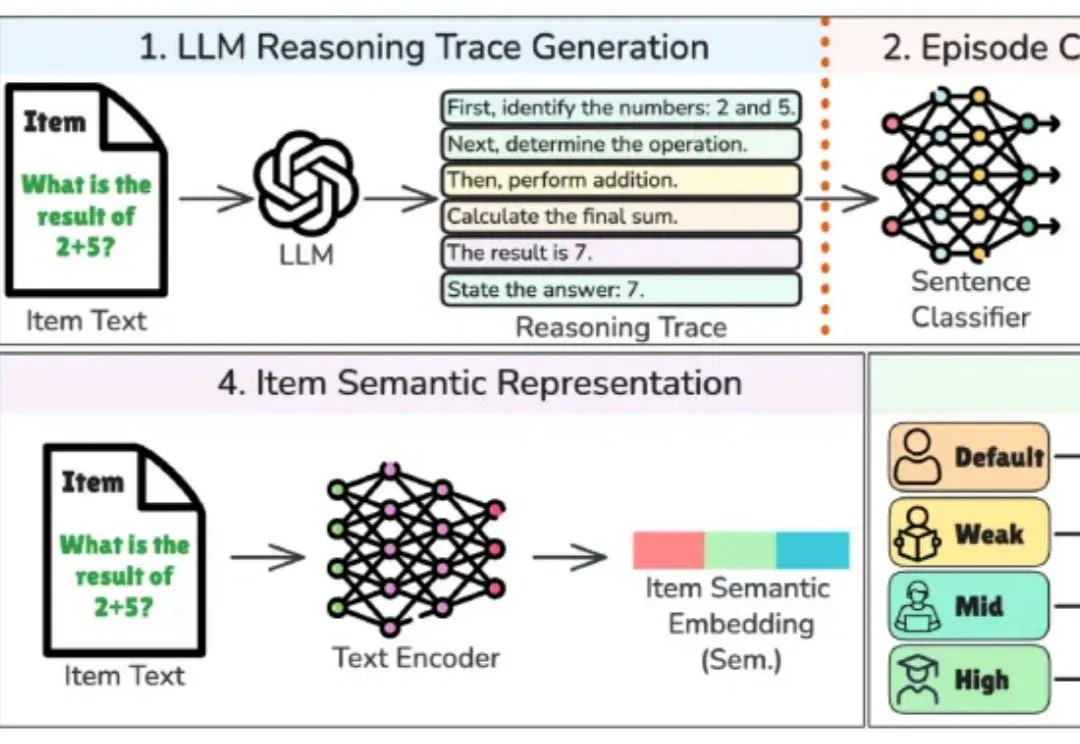
Epi2Diff 将大模型解题过程拆为八类认知片段,提取过程特征并结合题目语义预测人类作答难度。研究在四个测评数据集上报告结果,SAT数学主实验准确率为73.0%;方法仍依赖已有难度标签训练,也需要目标人群验证与专家复核。
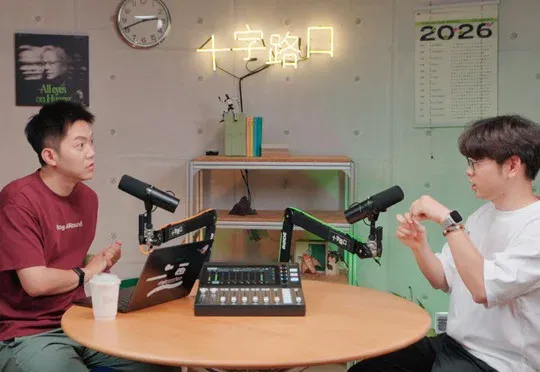
深朴智能24岁首席科学家王家伟在播客对话中回顾了从中科大少年班、MSRA、DeepSeek到字节Seed的经历,阐述放弃大模型舒适区转向具身智能创业的原因,认为具身系统既需要通用大模型承担理解与规划,也需要能毫秒级快速反应的动作模型,并介绍了深朴智能在开源HiFi-UMI数据集、自研高精度UMI手套及构建Agentic OS方面的全栈研发进展。
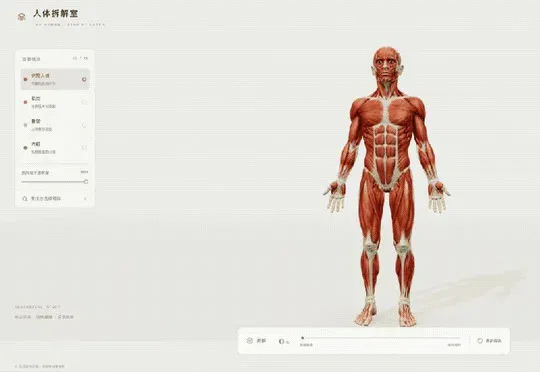
GPT-6爆火的人体解剖3D案例被扒出实际调用了现成3D数据集素材而非真正生成,文章作者通过GPT-6搭配Hyper3D MCP,用Codex调用Hyper3D Rodin模型实际复刻出可交互的3D人体拆解网页,并延伸制作了可拆装蒸汽甲壳虫、橘猫子弹时间、骑楼街景和影子解谜游戏等多种3D交互作品。
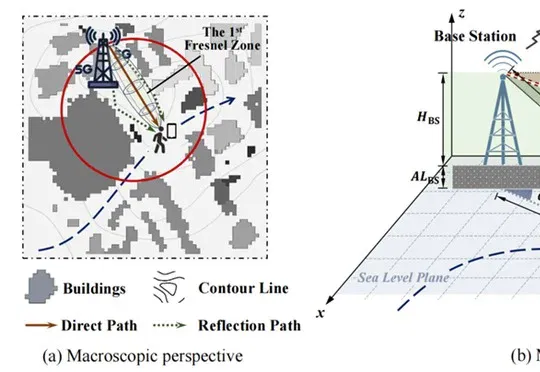
清华大学与北京邮电大学联合提出物理引导扩散模型Channel-Diff,将传播模型、阴影遮挡与多径几何嵌入条件扩散模型,实现无线信道多尺度RSRP预测,在两套真实数据集上相较次优方法分别取得37.19%和25.15%的综合性能提升。
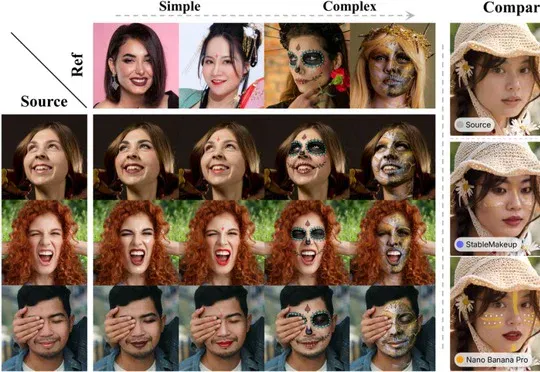
ECCV 2026论文ART由vivo BlueImage Lab联合哈工大与南大提出,通过将真实参考图作为可微分监督信号的两阶段训练框架,突破了复杂妆容迁移中的伪目标天花板,同步发布了首个2K分辨率妆容数据集MF2K。
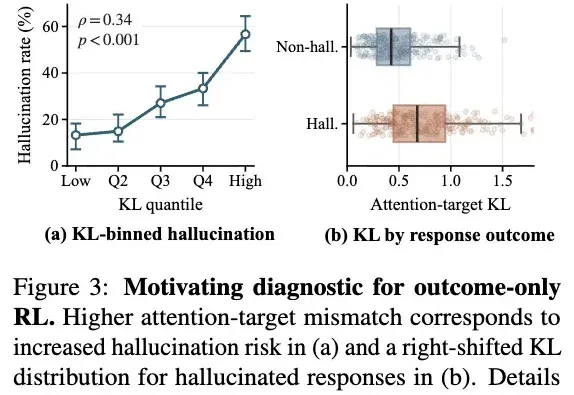
强化学习与可验证奖励(RLVR)已成为提升视觉语言模型(VLM)推理能力的标配手段。但一个隐蔽的问题始终存在:最终答案的奖励信号,只告诉模型「答对了没有」,却从不告诉它「答案应该从图像的哪个区域得出」。答对,可能是因为真的看懂了图,也可能只是语言先验的捷径、数据集的偏差,甚至是一次幸运的瞎猜。