刚刚,Kimi K3正式开源!3万亿模型权重全球开放(附开源地址)(在新窗口打开)
就在刚刚,全球首个3万亿参数级开源模型Kimi K3正式开源!https://github.com/MoonshotAI/Kimi-K3/tree/main。Moonshot AI宣布,发布Kimi K3的模型权重、技术报告,并开源支撑Kimi K3模型训练的关键Infra技术:MoonEP、FlashKDA和AgentEnv。
共 132 篇
就在刚刚,全球首个3万亿参数级开源模型Kimi K3正式开源!https://github.com/MoonshotAI/Kimi-K3/tree/main。Moonshot AI宣布,发布Kimi K3的模型权重、技术报告,并开源支撑Kimi K3模型训练的关键Infra技术:MoonEP、FlashKDA和AgentEnv。
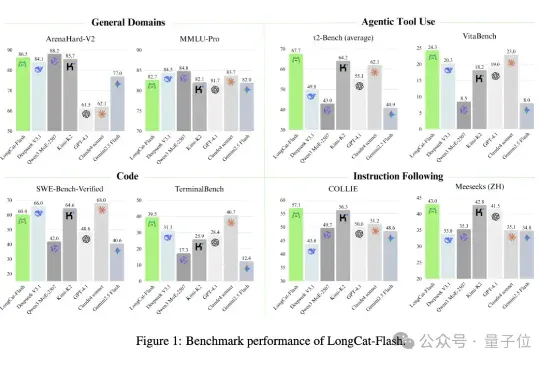
没想到啊,最新SOTA的开源大模型…… 来自一个送外卖(Waimai)的——有两个AI,确实不一样。 这个最新开源模型叫:Longcat-Flash-Chat,美团第一个开源大模型,发布即开源,已经在海内外的技术圈子里火爆热议了。
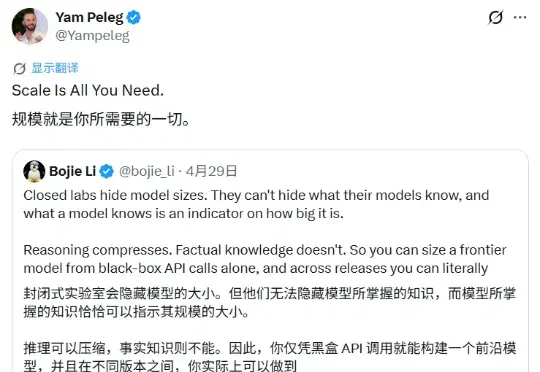
基于此,研究者在 89 个参数量已知的开源模型(规模从 1.35 亿到 1.6 万亿参数)上拟合出事实准确率与参数量的对数线性关系,拟合优度 R² = 0.917,并据此对闭源模型进行参数估算。
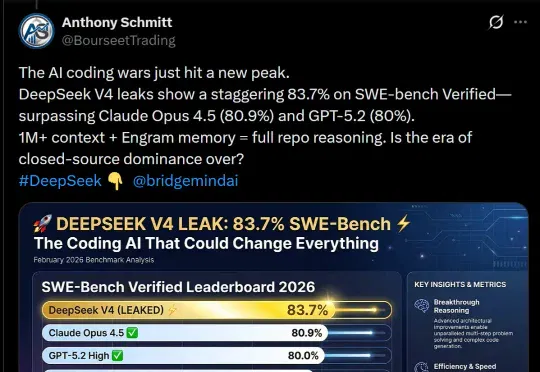
DeepSeek V4,据说明天就要上线了?这是首个匹敌顶尖闭源模型的开源模型,被网友评为「一鲸落万物生」。泄露的基准测试显示,它在SWE-bench Verified上取得了83.7%,已经超越Opus 4.5和GPT-5.2!
就在刚刚,智谱发布了其最新一代旗舰模型GLM-5.3,并宣布模型将在两周内开源。这是一个拥有7430亿个参数的模型,和此前的GLM模型一样主打编程。在多项主流基准测试中,GLM-5.3位居所有已开源或即将开源模型中的第一;其在编程与智能体任务上的能力,已逼近Claude Fable 5、GPT-5.6 Sol等海外顶尖模型。
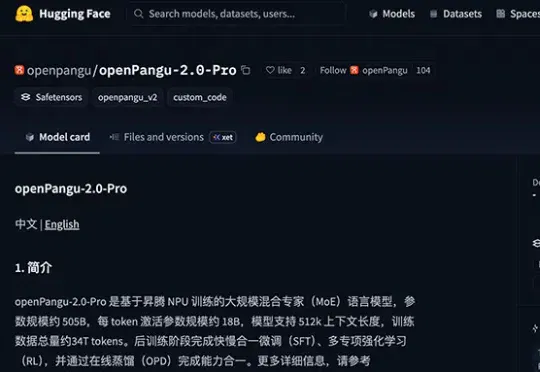
今日,华为开源基于昇腾NPU训练的盘古MoE模型openPangu-2.0-Pro。该模型是openPangu-2.0系列的最新开源模型,总参数规模5050亿,激活参数规模180亿,支持512K上下文长度,训练数据总量约34T tokens。另一轻量化模型openPangu-2.0-Flash已于6月12日开源,参数92亿,其中6亿为激活参数。
27B正在成为本地AI的新选择。 一个能塞进24GB家用显卡的开源模型,凭什么被开发者称为新模型的斩杀线? 答案藏在一张榜单里:在Artificial Analysis最新的Intelligence Index上拿到了52分,和GPT-5.6 Luna、DeepSeek-V4-Flash打成平手。换句话说,往后再发小模型,够不到这条线,就很难再让人提起兴趣。 它就是刚刚开源的Qwen3.8-27B。 而比这个分数更让个人开发者上心的一点是:这一次,它是真的能被下载回家、跑在自己电脑上的。 Qwen3.8-27B在正式开放权重之前,海外开源社区已经等了好一阵。 量化版本什么时候出来,24GB显存
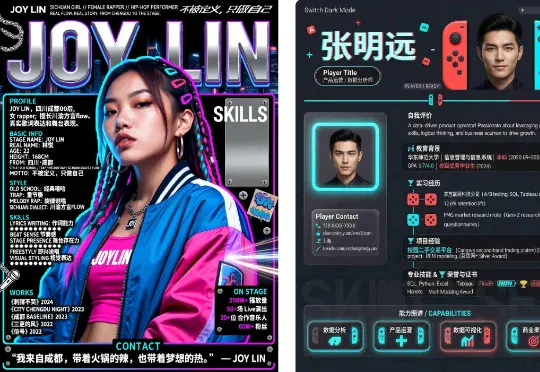
SenseNova U1 是商汤最新发布的一个开源的多模态模型,它的 Lite 系列 8B 和 A3B 参数版本,目前已经在 Hugging Face 和 GitHub 上开源。APPSO 也提前拿到了测试资格,我们发现商汤这款新一代原生理解生成统一模型,就开源模型来说,已经做到了最好水平。
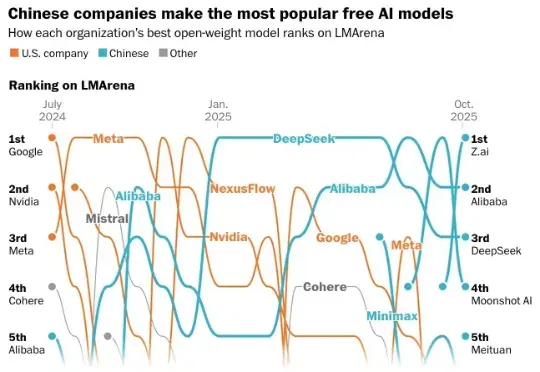
开源大模型,进入中国时间。 10月,公开数据显示,来自中国的开源大模型已经牢牢占据榜单前五。 阿里的Qwen系列和DeepSeek,更是从2024年下半年起,就在开源社区构建起越来越深远的影响力。
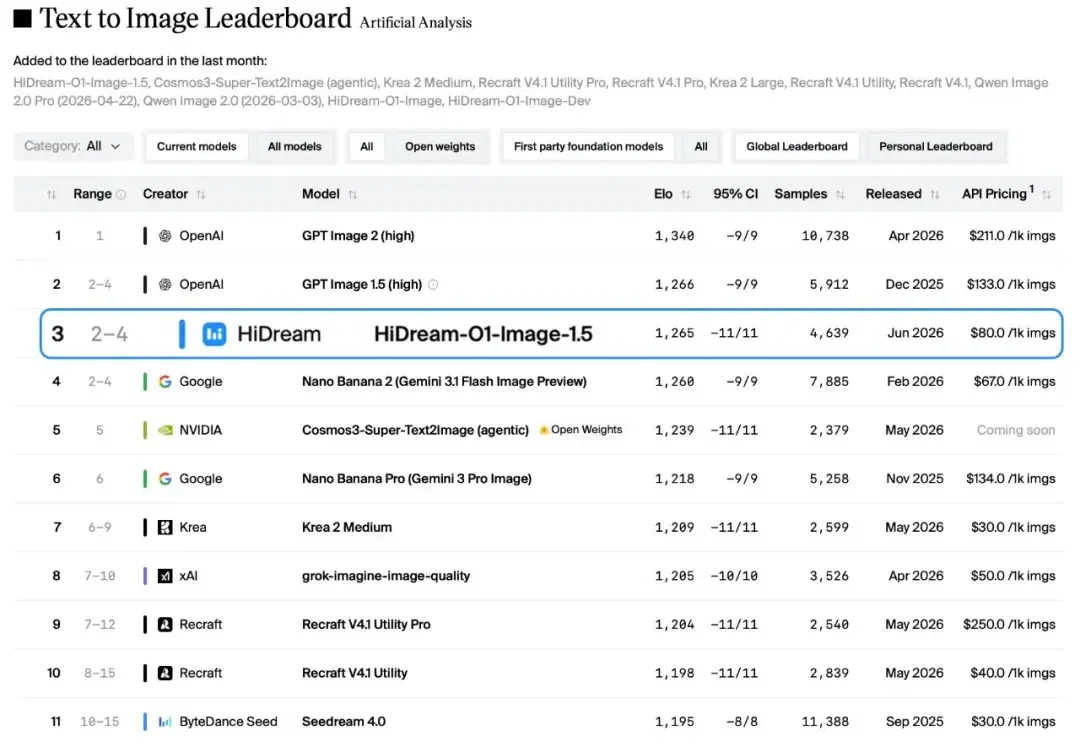
文生图的"慢思考",到底有没有用? “8B 开源版是一扇窗,真正的风景还在 200B+ 参数的 Pro 版本之后。” 智象未来 HiDream-O1-Image 开源版(8B)发布之后,我在测评最后留下了这样一句判断。前者以 Peanut 匿名登上 AA 榜、拿下文生图开源模型全球第一的事迹犹在眼前,今天 1.5 闭源版本又和公众见面了。 珠玉在前,HiDream-O1-Image-1.5 可以说是备受瞩目,而智象未来的官方口径很大程度上回应了这种期待:“连续登顶不仅印证了智象未来在图像生成大模型上的硬核实力,更标志着公司已稳居全球视觉生成大模型的第一梯队”。 看过 1.5 版本在 Artif