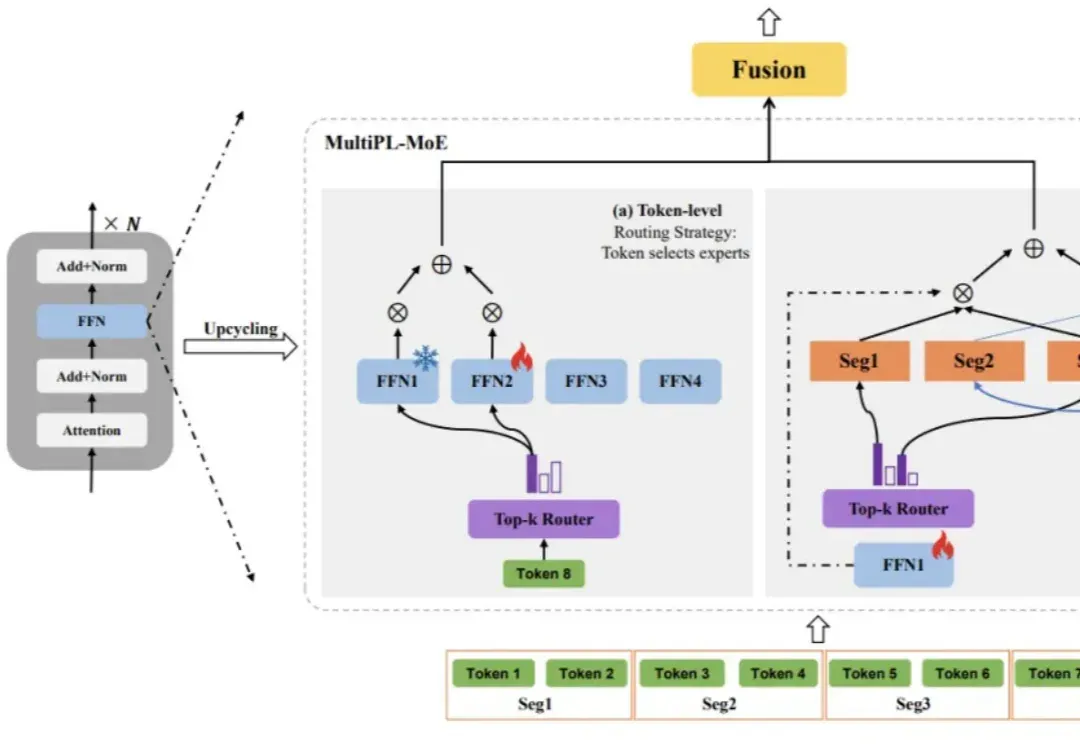
中移动九天团队MultiPL-MoE:全新Hybrid-MoE架构用于增强通用大模型低资源代码能力(在新窗口打开)
大语言模型(LLM)虽已展现出卓越的代码生成潜力,却依然面临着一道艰巨的挑战:如何在有限的计算资源约束下,同步提升对多种编程语言的理解与生成能力,同时不损害其在主流语言上的性能?
共 194 篇
大语言模型(LLM)虽已展现出卓越的代码生成潜力,却依然面临着一道艰巨的挑战:如何在有限的计算资源约束下,同步提升对多种编程语言的理解与生成能力,同时不损害其在主流语言上的性能?
世界模型是个依然模糊和遥远的概念。 它被赋予的期待很清楚:赋予AI理解物理世界的能力。 过去,大语言模型让AI学会了“说话”,它能写出流畅的文章,却不知道一个杯子从桌上滑落会发生什么。从理解语言到理解物理世界,中间隔着一道巨大的鸿沟——重力、碰撞、物体恒存、因果关系,这些人类凭直觉就能感知的规则,对AI来说全是盲区。 世界模型试图填平这道鸿沟,它让AI在行动之前先在“脑海”中预演后果,就像人类闭眼想象推门后会看到什么。这让机器人不再只是执行预设指令,而是真正开始“理解”自己所处的世界。 在一个所有要素都在鼓励创业公司更加大胆定位自己的时期,世界模型方向的创业公司迎来又一波集体亮相。 本期推荐的
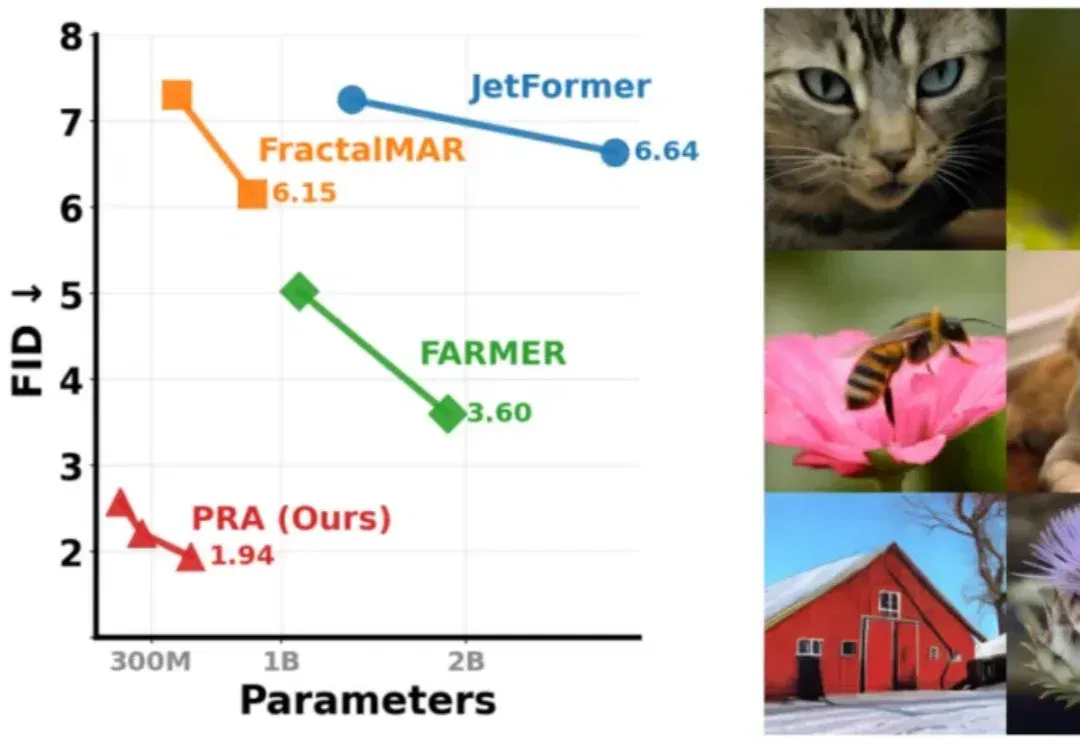
过去几年,扩散模型几乎定义了高质量图像生成:从随机噪声出发,经过多轮迭代,逐步 “雕刻” 出一张图像。但随着大语言模型席卷人工智能领域,另一条路线正迅速走到舞台中央 —— 图像,能否也像语言一样,通过自回归方式逐步生成?
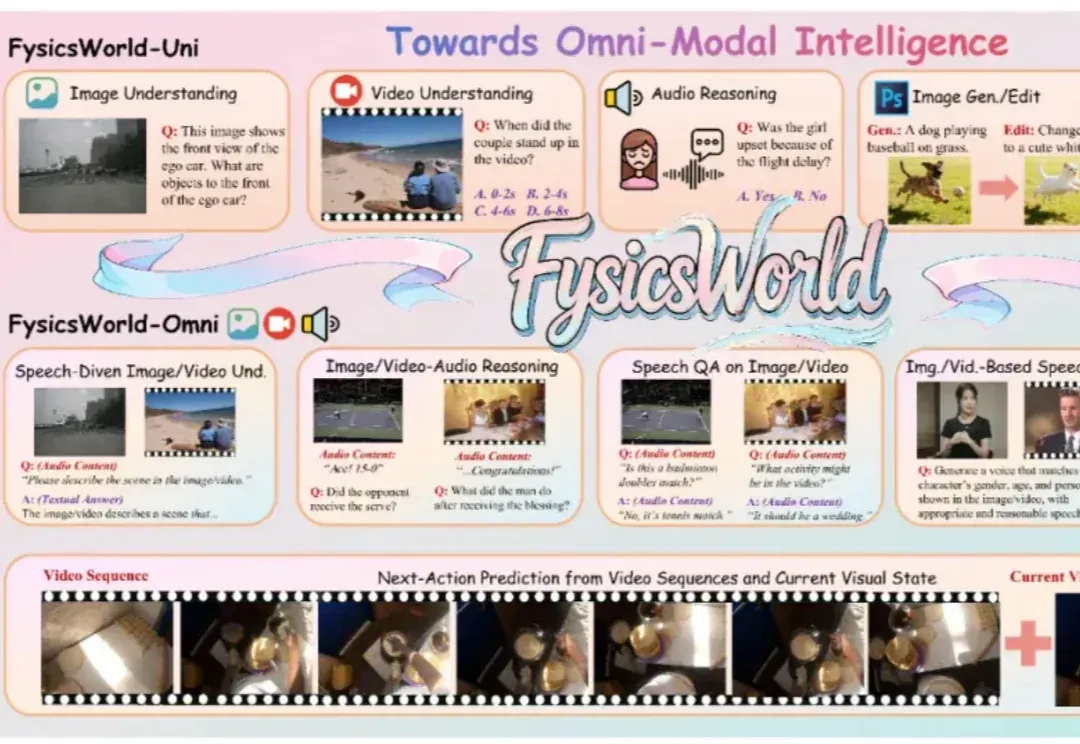
近年来,多模态大语言模型正在经历一场快速的范式转变,新兴研究聚焦于构建能够联合处理和生成跨语言、视觉、音频以及其他潜在感官模态信息的统一全模态大模型。此类模型的目标不仅是感知全模态内容,还要将视觉理解和生成整合到统一架构中,从而实现模态间的协同交互。
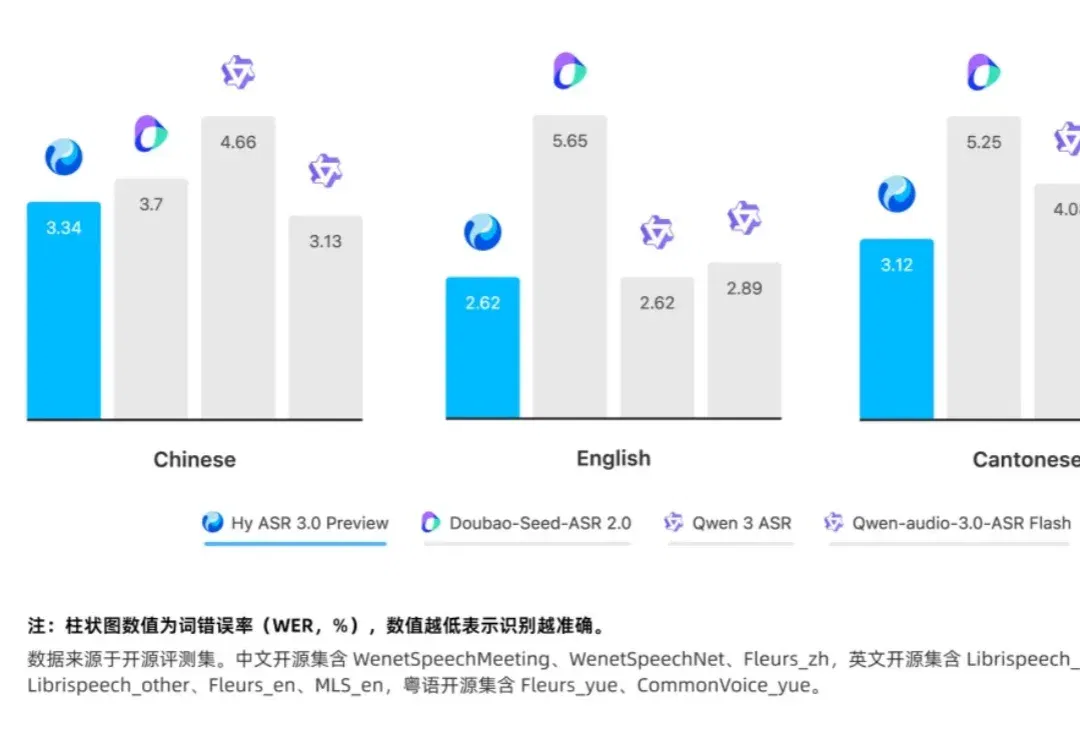
8 月 4 日,腾讯混元正式发布新一代语音识别模型 Hy ASR 3.0 preview。基于最新一代大语言模型 Hy3 的语言理解能力,Hy ASR 3.0 preview 融合高精度语音识别与深度语义理解能力,在通用识别、上下文感知、多场景鲁棒性以及方言覆盖等核心维度实现全面提升,
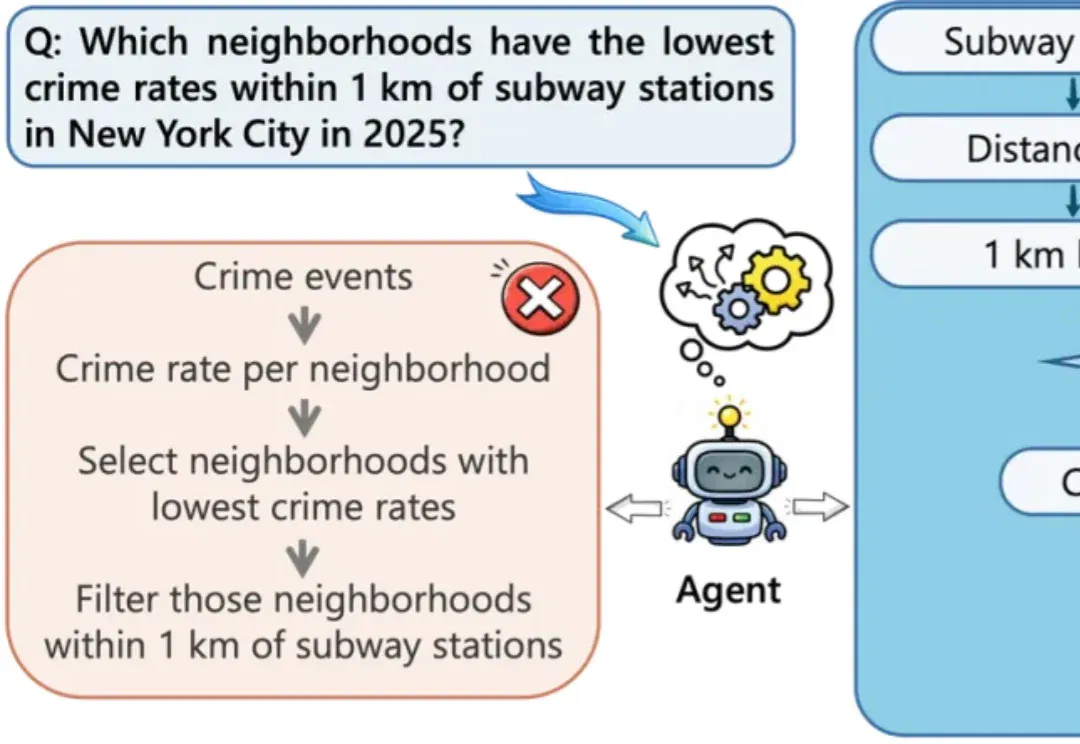
大语言模型在地图、城市、交通等空间领域的应用越来越广泛。对于这些场景来说,问题往往不只是 “查一个地点” 或 “调用一次路线 API” 就能解决的,而是需要把用户的自然语言问题组织成一段可执行、可验证的地理分析流程。
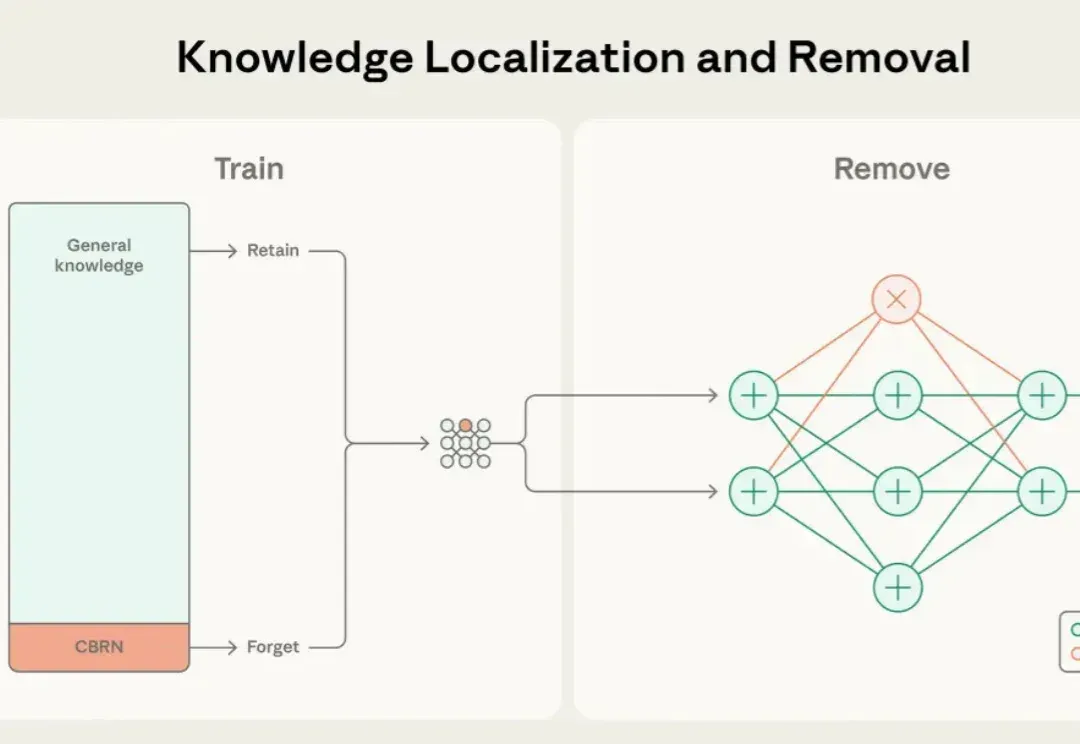
近年来,大语言模型的能力突飞猛进,但随之而来的却是愈发棘手的双重用途风险(dual-use risks)。当模型在海量公开互联网数据中学习时,它不仅掌握语言与推理能力,也不可避免地接触到 CBRN(化学、生物、放射、核)危险制造、软件漏洞利用等高敏感度、潜在危险的知识领域。
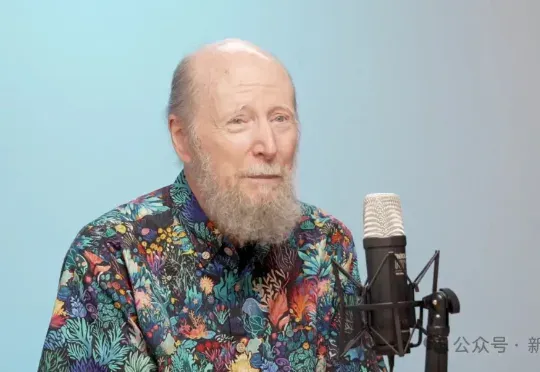
当全世界都在狂热追逐大模型时,强化学习之父、图灵奖得主Richard Sutton却直言:大语言模型是「死胡同」。在他看来,真正的智能必须源于经验学习,而不是模仿人类语言的「预测游戏」。这番话无异于当头一棒,让人重新思考:我们追逐的所谓智能,究竟是幻影,还是通向未来的歧路?
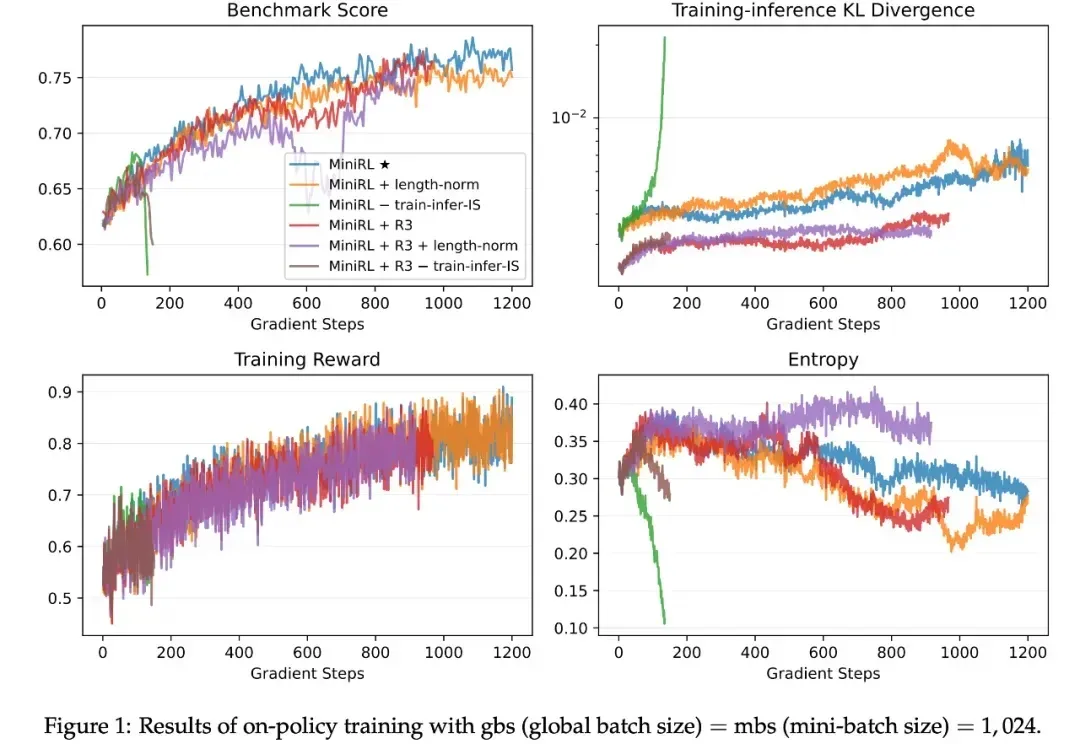
如今,强化学习(RL)已成为提升大语言模型(LLM)复杂推理与解题能力的关键技术范式,而稳定的训练过程对于成功扩展 RL 至关重要。由于语言具有强烈的上下文属性,LLM 的 RL 通常依赖序列级奖励 —— 即根据完整生成序列给一个标量分数。
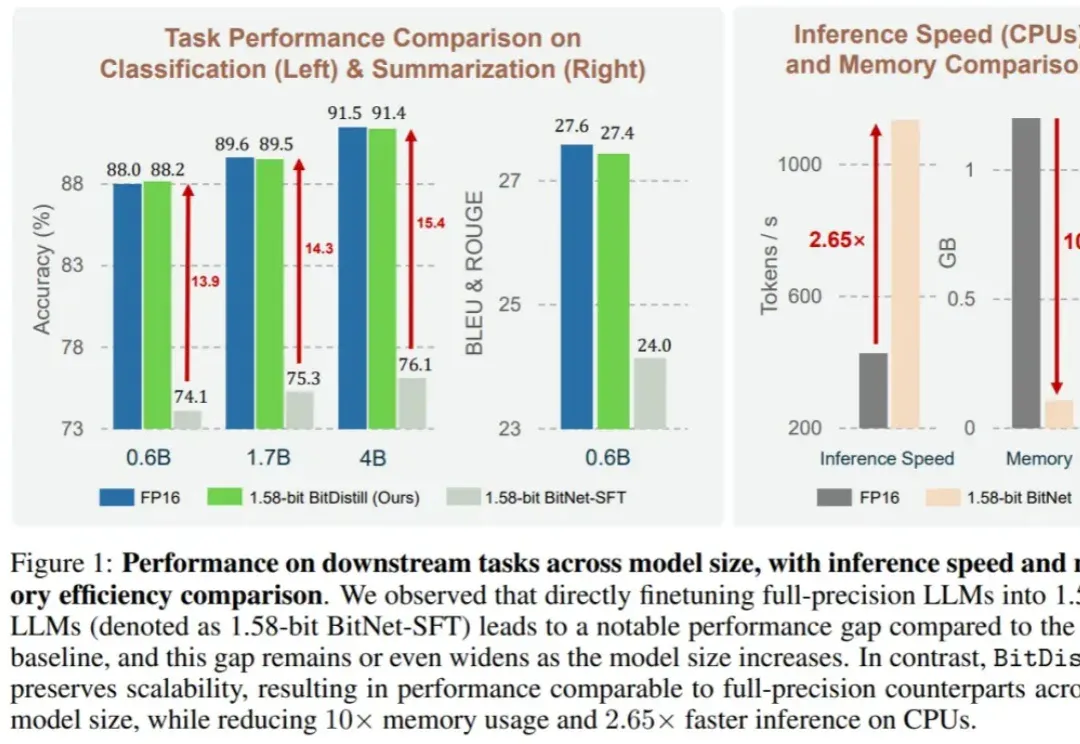
大语言模型(LLM)不仅在推动通用自然语言处理方面发挥了关键作用,更重要的是,它们已成为支撑多种下游应用如推荐、分类和检索的核心引擎。尽管 LLM 具有广泛的适用性,但在下游任务中高效部署仍面临重大挑战。