Z Tech|专访中科大02年白寅岐:让隐式世界模型学会因果,做最快最省落地的世界模型(在新窗口打开)
世界模型(World Model),正在成为AI领域新的技术高地。从OpenAI的Sora,到图灵奖得主Yann LeCun力推的JEPA体系,再到李飞飞创办的World Labs,全球最顶尖的一批研究者都在试图回答同一个问题:AI究竟如何像人一样理解世界,而不仅仅是生成语言和图像。
共 388 篇
世界模型(World Model),正在成为AI领域新的技术高地。从OpenAI的Sora,到图灵奖得主Yann LeCun力推的JEPA体系,再到李飞飞创办的World Labs,全球最顶尖的一批研究者都在试图回答同一个问题:AI究竟如何像人一样理解世界,而不仅仅是生成语言和图像。
我被AI杀了? 有视频为证,我被一个不知道是人还是AI的东西,一枪崩了。 还是在一个世界模型创造的世界里。 嗯,就是这个画质糊成马赛克的网页版FPS。 背后没有游戏引擎,没有物理规则,没有一行渲染代码。 你看到的一切,都是靠一个叫Agora-1的世界模型,实时生成的。 人类和AI,同时在其中搏击。 AI版黄金眼007 先一起看看这条官方产品发布视频。 我看了好多遍,很奇怪的感觉。 和之前看到的demo都不一样。审美很独特的一家公司,拍个发布视频跟拍《黑镜》一样。 关键伪人感真的很重,我时刻怀疑视频里的人是不是也是AI生成的。 实在集中不了注意力,交给codex转成逐字稿看了一下,大概意思就是—
今日,蚂蚁灵光App上线“体验世界模型”功能,成为业界首个可在移动端体验世界模型的智能助手,实现了分钟级一致性和实时可交互体验。用户只需上传一张图片,即可在手机上探索最长60秒的3D世界,并通过手游摇杆操控视角,像玩游戏一样在其中走动。从触发指令到开始探索,整个过程仅需秒级。
世界模型真的变天了!今天,谷歌正式发布重磅世界模型原型产品“Project Genie”,只需一句话或一张图,就能一键生成可玩、可交互的实时虚拟世界。 它的重磅程度,让谷歌“掌舵人”劈柴哥和 Google DeepMind 创始人哈萨比斯亲自为它站台。
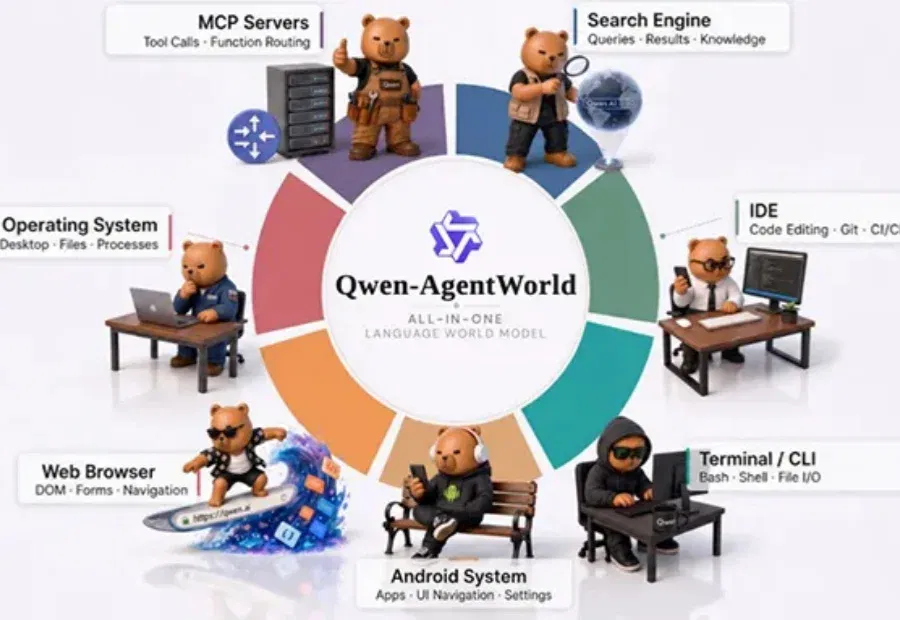
一个模型能模拟7种环境。 智东西6月24日消息,刚刚,阿里千问大模型上新,发布首个原生语言世界模型(LWM)Qwen-AgentWorld,该模型有35B-A3B与397B-A17B两种参数规模。 该模型专门为各类AI智能体研发与训练而生。在博客中,研究人员提到,该语言世界模型的核心目的不是降成本、替代智能体的真实交互环境,而是为了增强通用智能体的能力。其可以让智能体在做动作前,先在内部模拟环境反馈再决策。 Qwen-AgentWorld两大核心亮点为: 从预训练阶段就将环境建模作为训练目标,贯穿CPT→SFT→RL全流程。此前完整训练通用基础大模型,往往会在训练结束后,才开始教AI理解环境、
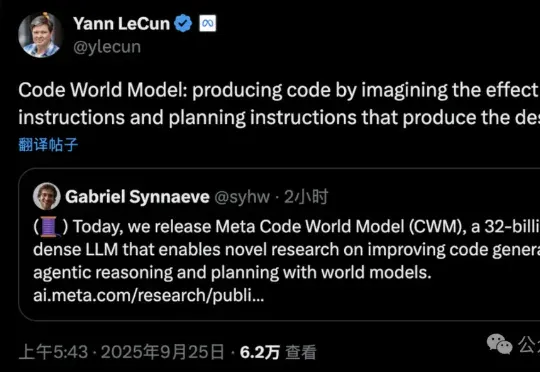
刚刚,Meta FAIR推出了代码世界模型!CWM(Code World Model),一个参数量为32B、上下文大小达131k token的密集语言模型,专为代码生成和推理打造的研究模型。这是全球首个将世界模型系统性引入代码生成的语言模型。
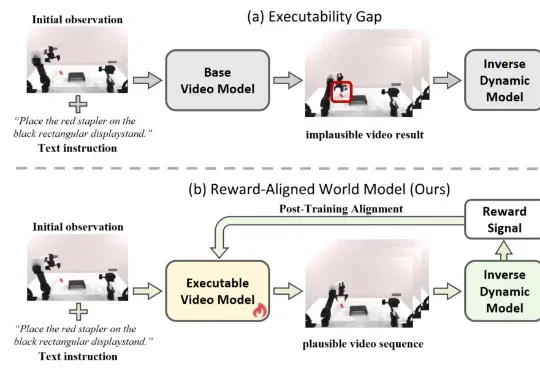
近期,利用视频生成模型为机器人构建 “世界模型”,已成为具身智能领域的热门技术路线。给定当前观测和自然语言指令,这类模型能够先 “想象” 出未来的视觉轨迹,再由逆动力学模型(IDM)将生成画面解码为机器人动作,从而形成 “先预测、后执行” 的解耦式规划范式。由于兼具较强的可解释性与开放场景泛化潜力,这一路线正在受到学术界和工业界的广泛关注。
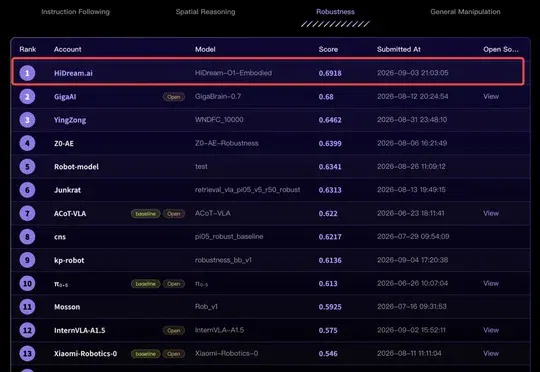
智象未来(HiDream.ai)正式发布具身世界模型HiDream-O1-Embodied,该模型在具身智能评测平台RoboColiseum扰动适应子榜单中以0.692分登顶榜首,标志着智象原生全模态世界模型矩阵的进一步完善。
在世界模型这条路上,行业一直卡在一个几乎无解的矛盾里:想要更真实的长程模拟,就必须给模型更深的计算;可一旦把模型做得更深,部署成本、参数规模和误差累积又会迅速抬头。结果就是,大家都知道世界模型要 “想得更久”,却很难让它在现实系统里 “算得起、跑得稳”。
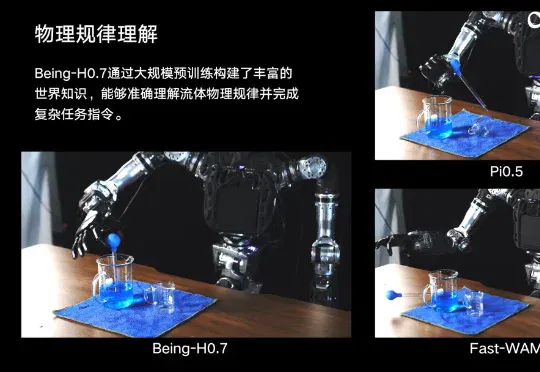
4 月 14 日,智在无界发布第三代旗舰模型 Being-H0.7,该模型将数据规模扩展至 20 万小时人类视频,并提出一种全新的范式 —— 基于潜空间推理的世界模型。在 6 项国际性权威评测中,H0.7 综合排名全球第一(其中 4 项登顶),同时也是首个覆盖跨本体、跨场景、连续动态、流体、柔性物体、物理规律与上下文推理等七大关键维度的通用世界模型。