国内大模型厂商 Token/Coding Plan 汇总对比:MiniMax、智谱、阶跃、Kimi 怎么选(在新窗口打开)
我自己用 Coding Plan 也有一段时间了,最开始只是为了省点 API 钱,后来各家陆续推出固定月费套餐,我发现选起来比想象中复杂。Codex、Claude Code、Cline、OpenClaw 这些工具让开发者越来越习惯用自然语言驱动代码生成和任务执行,但高频调用带来的 API 成本也成了一笔固定开销。
共 619 篇
我自己用 Coding Plan 也有一段时间了,最开始只是为了省点 API 钱,后来各家陆续推出固定月费套餐,我发现选起来比想象中复杂。Codex、Claude Code、Cline、OpenClaw 这些工具让开发者越来越习惯用自然语言驱动代码生成和任务执行,但高频调用带来的 API 成本也成了一笔固定开销。
Anthropic 团队正以极高强度内部试用 Claude Code。
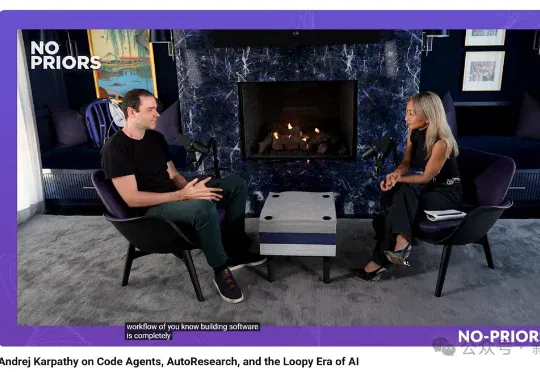
Karpathy自曝:我得AI精神病了!这些天,他已经处于精神错乱边缘,16小时不吃不睡就是搞Agent,而且很焦虑自己有没有把智元(token)用到极限,根本停不下来……
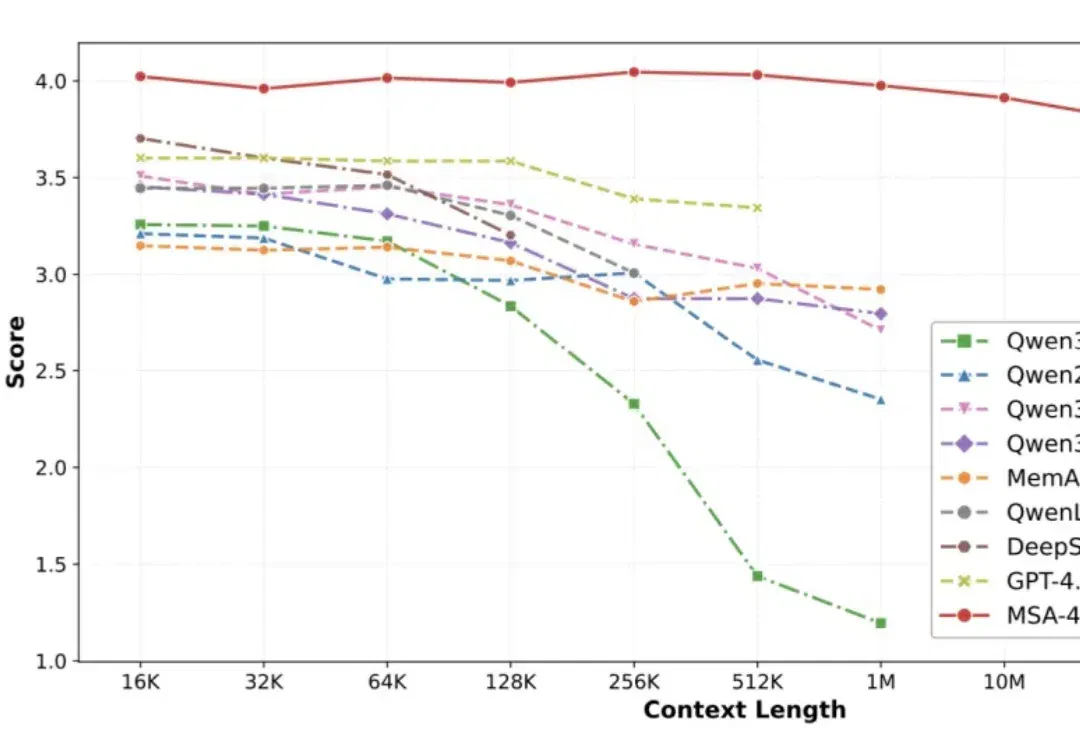
人的智能能力主要由推理能力和长期记忆能力构成。近年来,大模型的推理能力一直处于快速发展过程,但大模型的长期记忆能力一直受限于上下文长度,无法取得突破。在历史上,曾经有多种路线进行尝试,但都无法突破扩展性(Scalability)、精度(Precision)和效率(Efficiency)的不可能三角。
当全网还在为搞定环境配置和Token账单焦头烂额时,有人直接掀了桌子,把OpenClaw从「工具」变成了「造印钞机」!
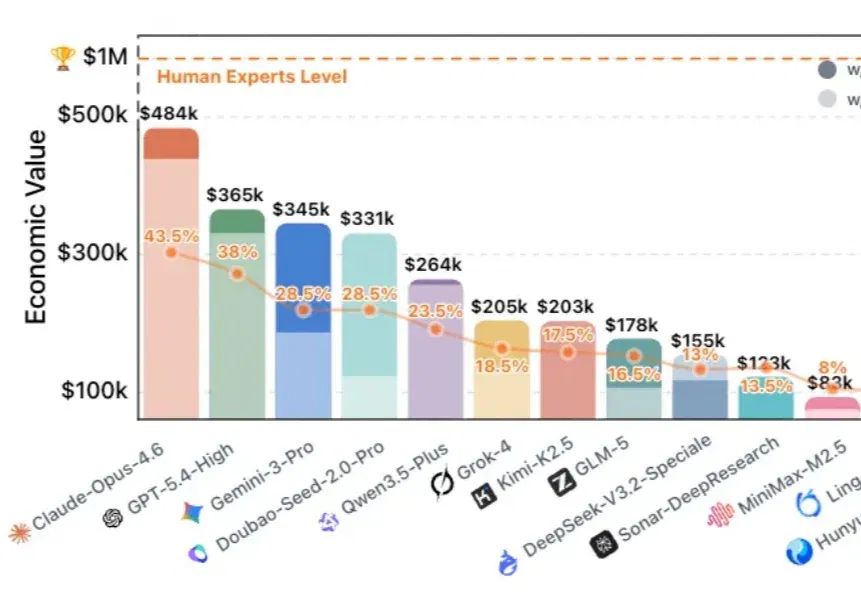
如果有价值 $100 万美金的顶级专家任务,AI 能完成其中多少?
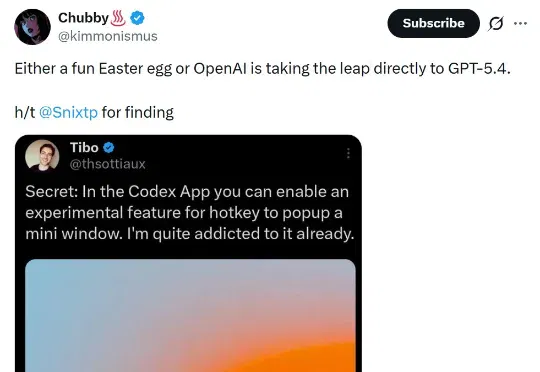
OpenAI 意外泄露 GPT-5.4!新版凭 200 万 Tokens 与「状态化 AI」实现跨会话持久记忆,并支持全分辨率视觉直读。AI 将从聊天工具向「全自动代理」进化,彻底重塑工作流并引爆底层硬件内存之战。
结果今天就等到豆包全家族了。Seedance 2.0都把贾樟柯干Fomo了,现在又上了个最全面的多模态Agent模型,还有人管管字节吗?Seed团队跳动得停不下来了💃烧的全是火山引擎上的Tokens,同时火山引擎上已经有豆包2.0系列的API了。
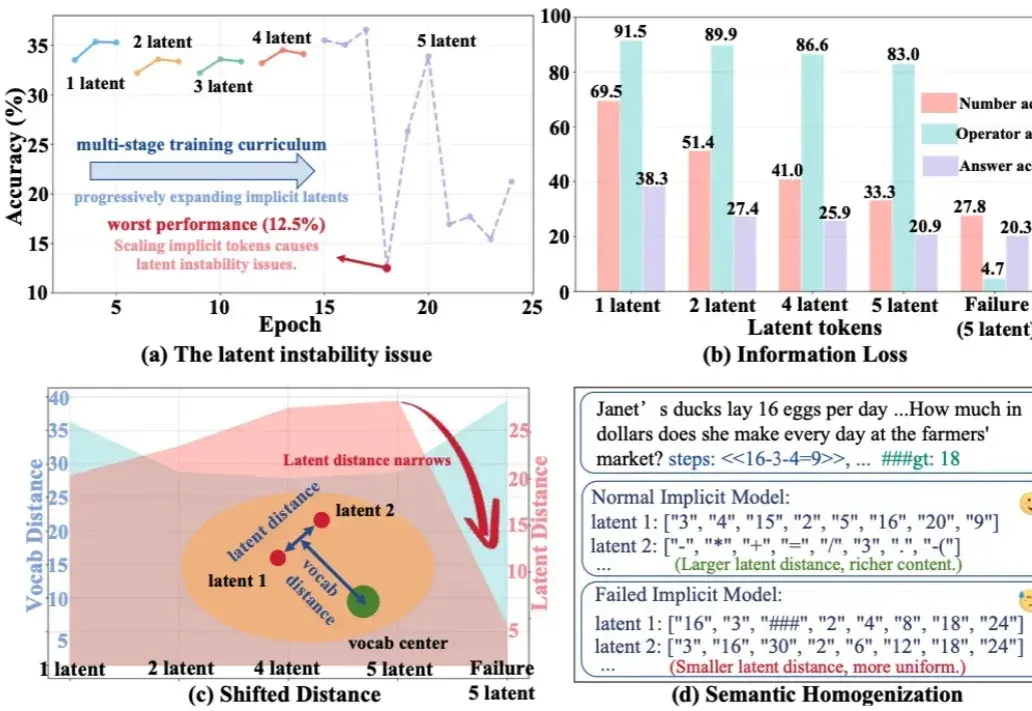
今天推荐一个 Implicit Chain-of-Thought(隐式推理) 的最新进展 —— SIM-CoT(Supervised Implicit Chain-of-Thought)。它直击隐式 CoT 一直「扶不起来」的核心痛点:隐式 token 一旦 scale 上去,训练就容易塌缩到同质化的 latent 状态,推理语义直接丢失。
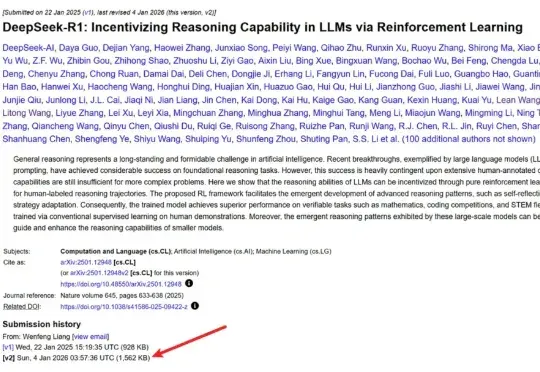
几天前,DeepSeek 毫无预兆地更新了 R1 论文,将原有的 22 页增加到了现在的 86 页。新版本充实了更多细节内容,包括首次公开训练全路径,即从冷启动、训练导向 RL、拒绝采样与再微调到全场景对齐 RL 的四阶段 pipeline,以及「Aha Moment」的数据化验证等等。