亚马逊Agent克服遗忘的“秘诀”,被中国团队掌握,让大模型遗忘率趋近于0(在新窗口打开)
国内记忆框架首开源,企业实战已上线运行。在海外巨头已经将“记忆系统”提升到基础设施层的同时,红熊AI便是其中之一。公司成立于2024年,围绕多模态大模型与记忆科学开展研发,并将这些能力用于为企业提供智能客服、营销自动化与AI智能体服务。
共 1518 篇
国内记忆框架首开源,企业实战已上线运行。在海外巨头已经将“记忆系统”提升到基础设施层的同时,红熊AI便是其中之一。公司成立于2024年,围绕多模态大模型与记忆科学开展研发,并将这些能力用于为企业提供智能客服、营销自动化与AI智能体服务。
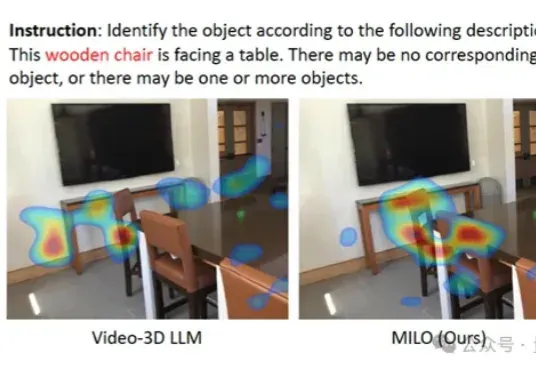
大模型总是无法理解空间,就像我们难以想象四维世界。
最近研究发现,大模型在判断逻辑谬误时容易「想太多」,误报正常句子,但在确定有谬误后,其分类能力较强。研究人员构建了首个高质量英文逻辑谬误基准SMARTYPAT-BENCH,并开发了基于Prolog的逻辑谬误自动生成框架SMARTYPAT,为大模型逻辑能力评估提供新思路,可用于谬误识别、辩论教育等领域。
近日,清华大学深圳国际研究生院的机器人博士团队创办的「知有无界」获得卓源亚洲领投、力合科创跟投的种子轮融资。「知有无界」诞生在清华大学王学谦教授的智能机器人实验室,实现了全球首个船舶具身通用大模型,本轮融资后,「知有无界」将会进一步加快在船坞的商业化落地,并持续进行多代产品的研发。
大模型推理的爆发,实际源于 scaling 范式的转变:从 train-time scaling 到 test-time scaling(TTS),即将更多的算力消耗部署在 inference 阶段。典型的实现是以 DeepSeek r1 为代表的 long CoT 方法:通过增加思维链的长度来获得答案精度的提升。那么 long CoT 是 TTS 的唯一实现吗?
正值AlphaFold问世五周年,其设计者、也是凭借AlphaFold获得诺贝尔化学奖的John Jumper公开表示:AlphaFold的下一步是与大模型融合。不过具体方法并没有透露,或许已有所思路,甚至已经在进程之中。
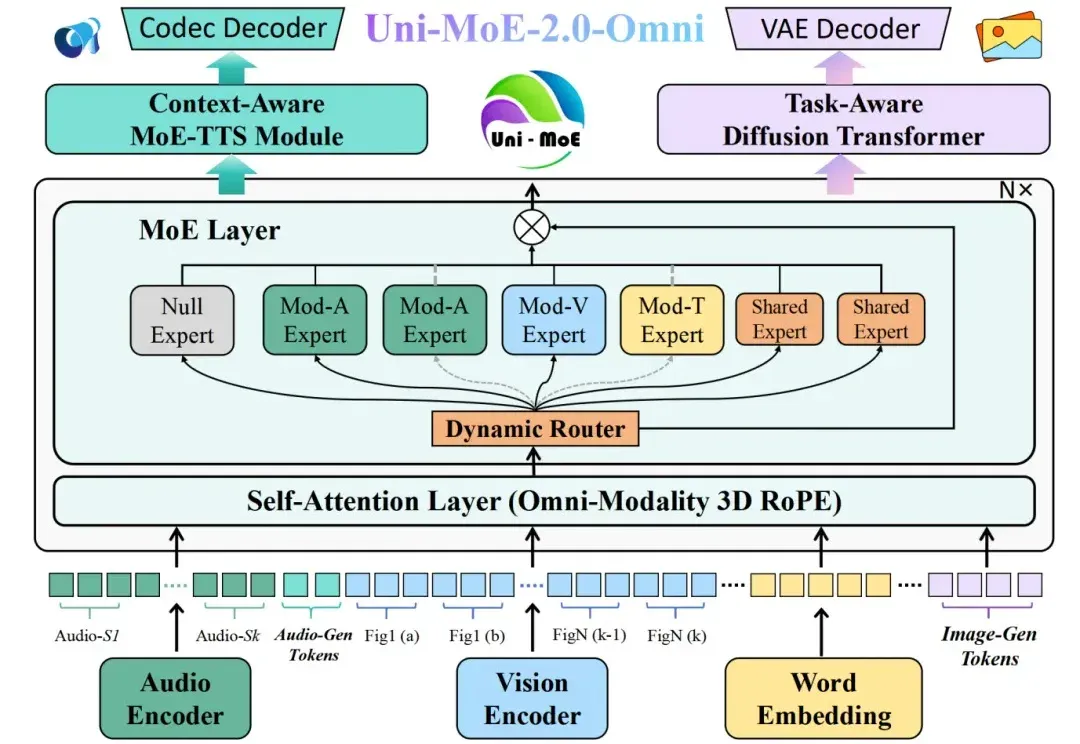
全模态大模型(Omnimodal Large Models, OLMs)能够理解、生成、处理并关联真实世界多种数据类型,从而实现更丰富的理解以及与复杂世界的深度交互。人工智能向全模态大模型的演进,标志着其从「专才」走向「通才」,从「工具」走向「伙伴」的关键点。
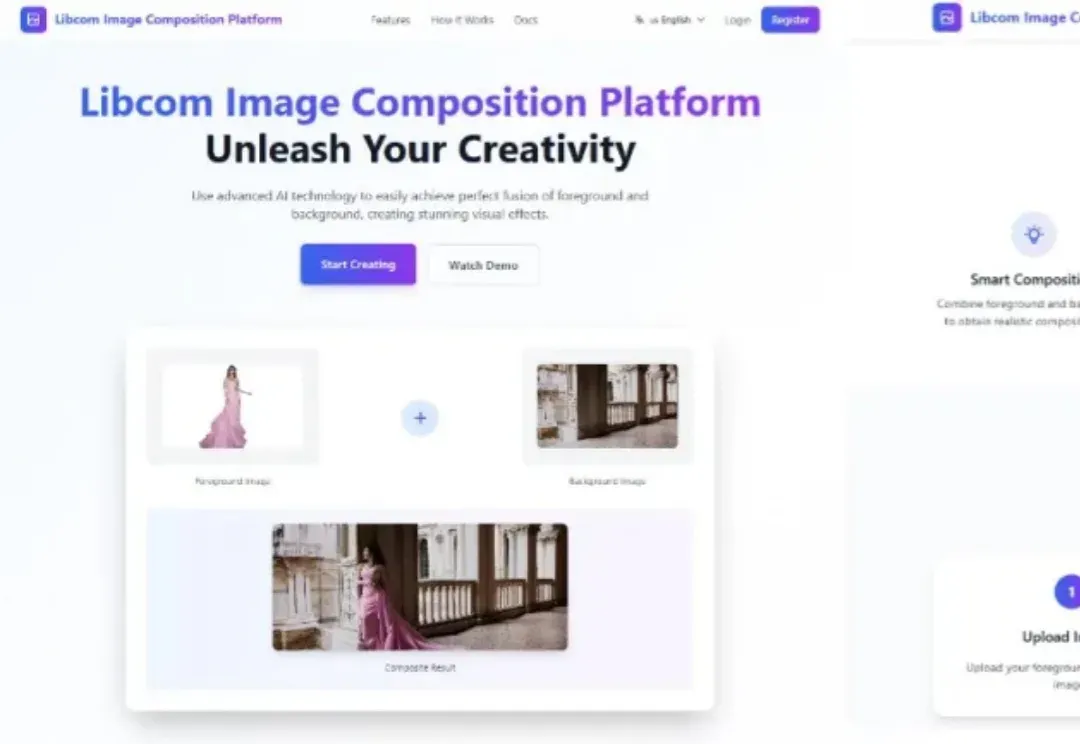
2025 年,AIGC 热度再冲新高:从社交头像、电商海报到影视分镜,AI 生成内容已全面渗透日常创作。在这股浪潮中,Nano Banana、Qwen Edit 等通用图像编辑大模型功能强大,涵盖了广泛的图像编辑场景。特别是最新爆火的 Nano Banana Pro 能将文字指令转化为高精度图像,精准呈现复杂场景。但是上述图像编辑大模型在一些细分领域的表现仍有不足,并且用于简单任务性价比不高。
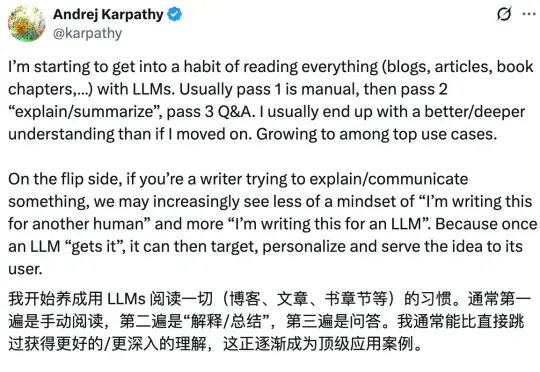
前 OpenAI 联合创始人、特斯拉 AI 总监 Andrej Karpathy 也一样。他在前几天发推,说自己「开始养成用 LLM 阅读一切的习惯」。Karpathy 在周六用氛围编程做了个新的项目,让四个最新的大模型组成一个 LLM 议会,给他做智囊团。
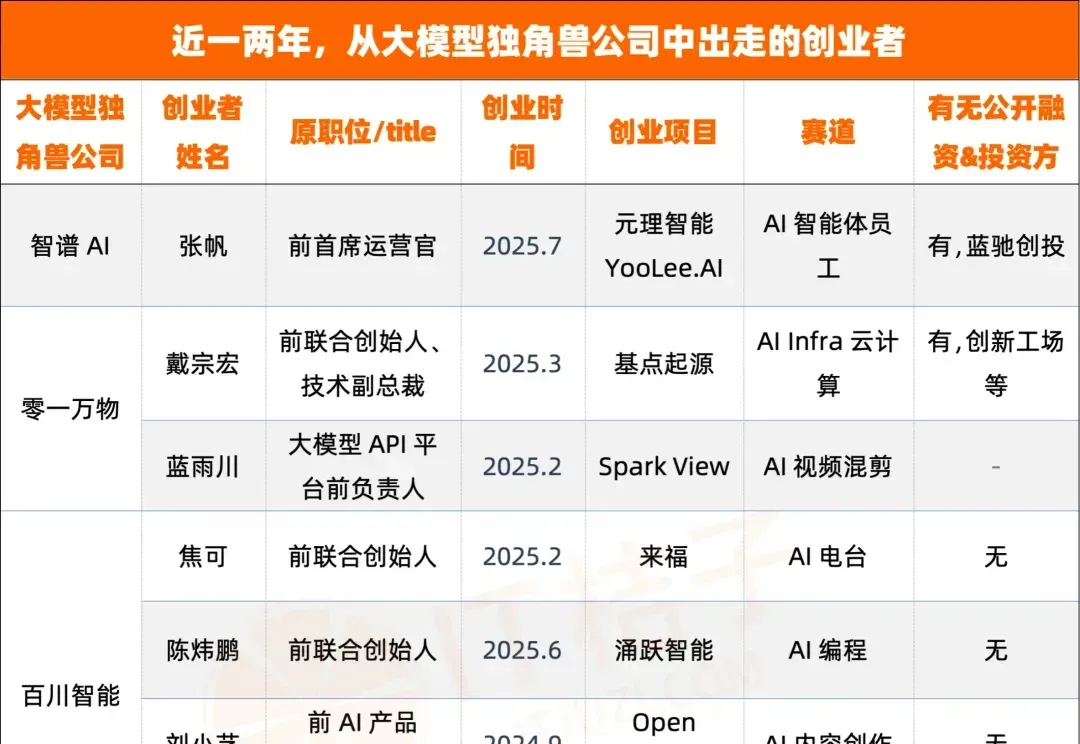
在最近的一年多时间里,中国“大模型六小虎”几乎无一不在经历着相似的阵痛: