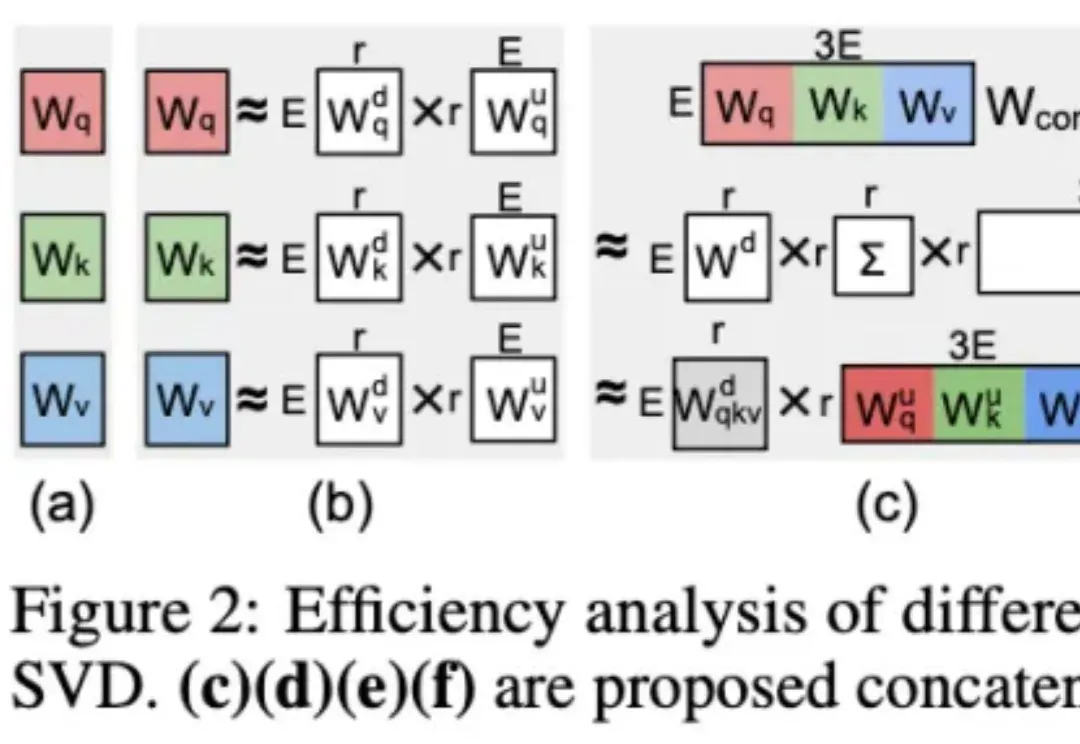
NeurIPS 2025 Spotlight | NYU提出QSVD,仅数学压缩让模型更轻、更快、更稳(在新窗口打开)
在多模态智能浪潮中,视觉语言模型(Vision-Language Models, VLM)已成为连接视觉理解与语言生成的核心引擎。从图像描述、视觉问答到 AI 教育和交互系统,它们让机器能够「看懂世界、说人话」。
共 438 篇
在多模态智能浪潮中,视觉语言模型(Vision-Language Models, VLM)已成为连接视觉理解与语言生成的核心引擎。从图像描述、视觉问答到 AI 教育和交互系统,它们让机器能够「看懂世界、说人话」。
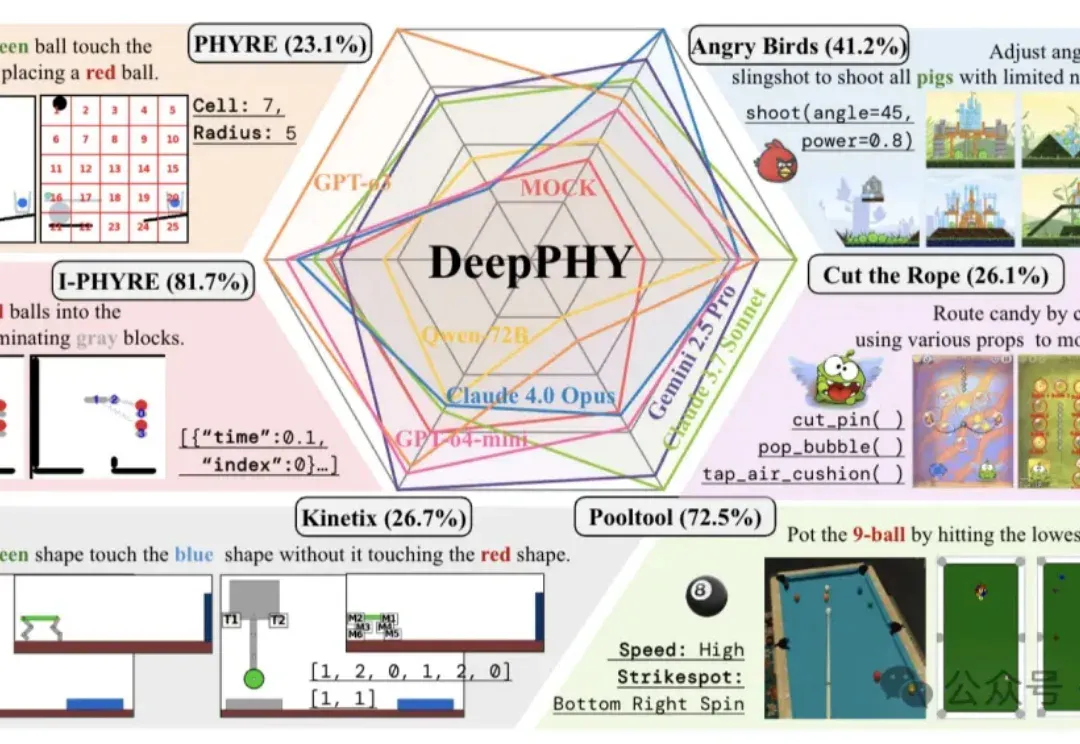
首个系统性评估多模态大模型(VLM)交互式物理推理能力的综合基准来了。
百度这次又往AI眼镜里狠狠塞了一把“猛料”。刚刚,百度官方发布了全新AI拍摄眼镜——小度AI眼镜Pro,2299元起。这回不光把颜值搞上去了,还把全新发布的多模态AI智能助手「超能小度」塞进了这幅39g重的眼镜里:
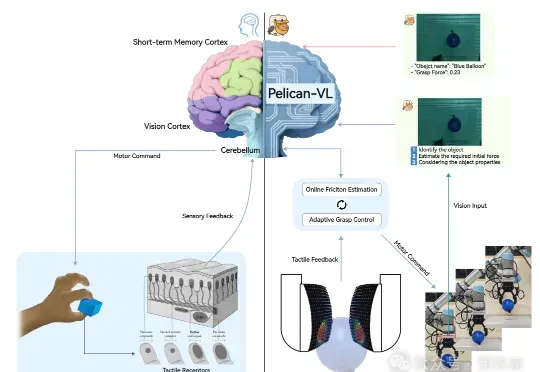
昨天,全球参数量最大的具身智能多模态大模型——Pelican-VL 1.0正式开源。它不仅覆盖了7B到72B级别,能够同时理解图像、视频和语言指令,并将这些感知信息转化为可执行的物理操作。
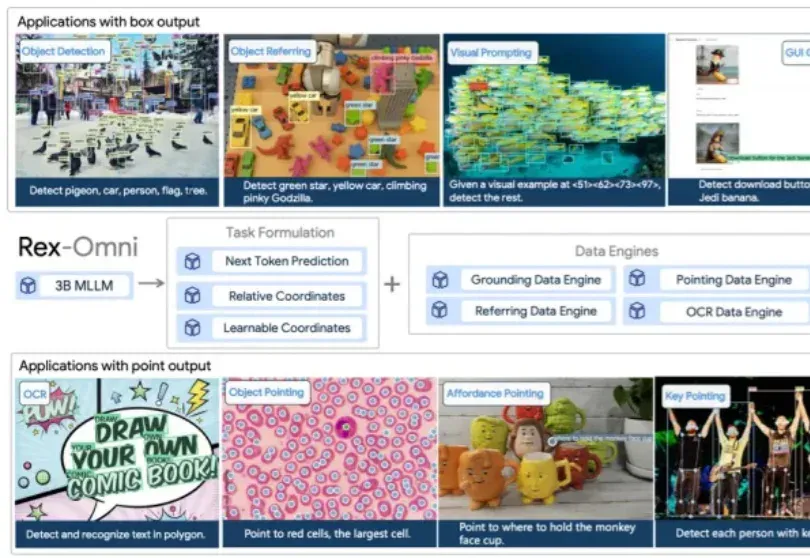
多模态大语言模型(MLLM)在目标定位精度上被长期诟病,难以匹敌传统的基于坐标回归的检测器。近日,来自 IDEA 研究院的团队通过仅有 3B 参数的通用视觉感知模型 Rex-Omni,打破了这一僵局。
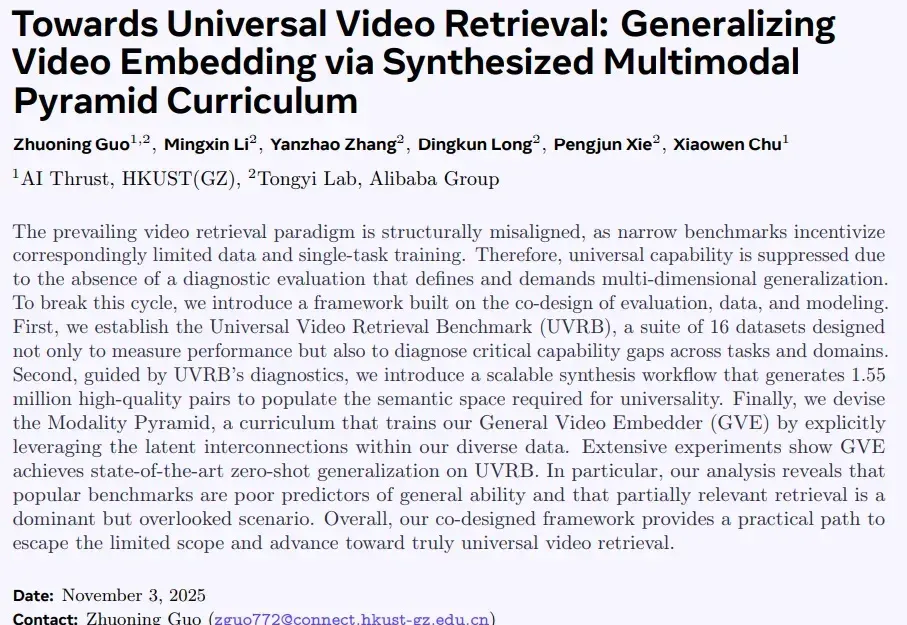
当前视频检索研究正陷入一个闭环困境:以MSRVTT为代表的窄域基准,长期主导模型在粗粒度文本查询上的优化,导致训练数据有偏、模型能力受限,难以应对真实世界中细粒度、长上下文、多模态组合等复杂检索需求。
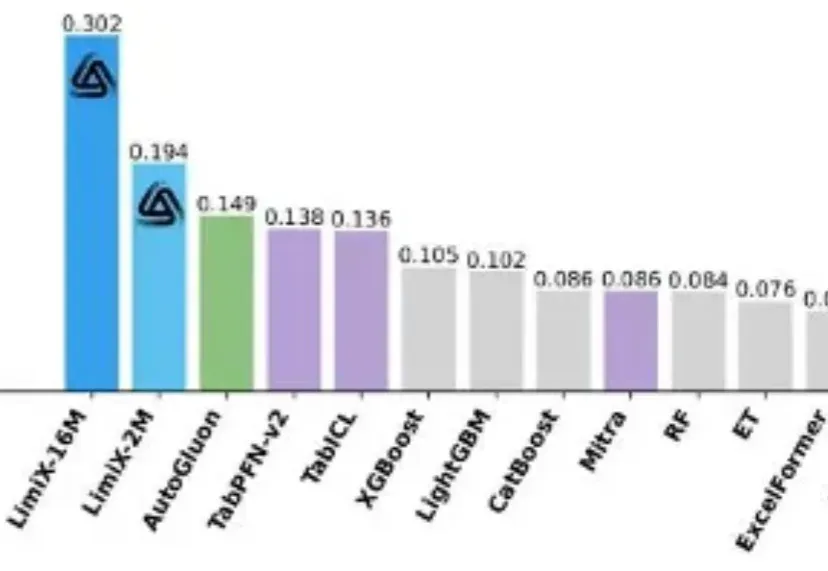
提到 AI 的突破,人们首先想到的往往是大语言模型(LLM):写代码、生成文本、甚至推理多模态内容,几乎重塑了通用智能的边界。但在一个看似 “简单” 的领域 —— 结构化表格数据上,这些强大的模型却频频失手。
Marble,终于来了。 没错,就是两个月前在 AI 圈刷屏的那个 3D 世界生成模型。就在刚刚,李飞飞旗下的 World Labs 公司官宣向全体用户开放,还一次性放出了一大波新功能。 多模态生成:
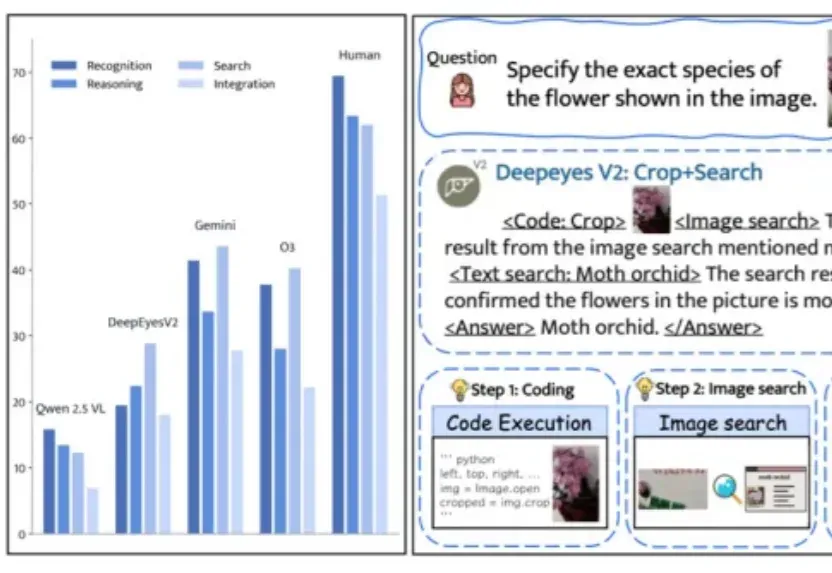
还记得今年上半年小红书团队推出的DeepEyes吗?
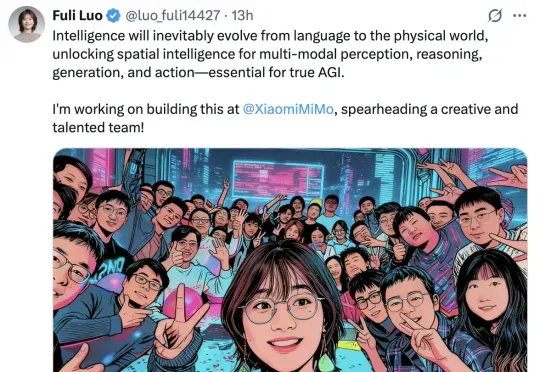
就在今天,罗福莉以C位之姿,首次对外官宣了小米任职。刚刚,罗福莉在X上高调宣布——正式加入小米,出任MiMo团队负责人。智能的进化必然会从语言世界走向物理世界,解锁多模态的空间智能——具备感知、推理、生成与行动的能力,这是实现真正通用人工智能(AGI)的关键一步。