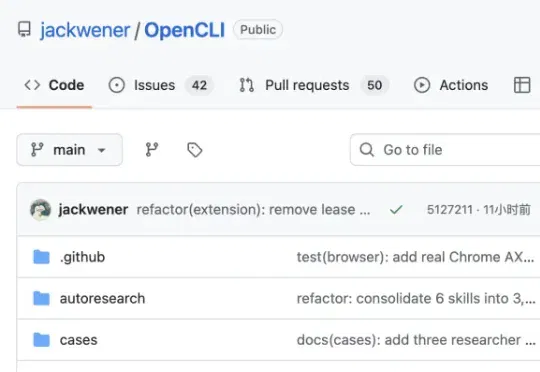
别让模型烧Token了!GitHub 20k星神作:把全网变成命令行(在新窗口打开)
每次想让AI读个外部网站的信息,看到这句话头都要炸了。不过,GitHub有个开源项目OpenCLI把这事儿解决了:网站变命令行。Reddit讨论、B站热门、Arxiv论文,以前开浏览器一个个翻的东西,现在终端一行命令直接出结构化数据。
共 619 篇
每次想让AI读个外部网站的信息,看到这句话头都要炸了。不过,GitHub有个开源项目OpenCLI把这事儿解决了:网站变命令行。Reddit讨论、B站热门、Arxiv论文,以前开浏览器一个个翻的东西,现在终端一行命令直接出结构化数据。
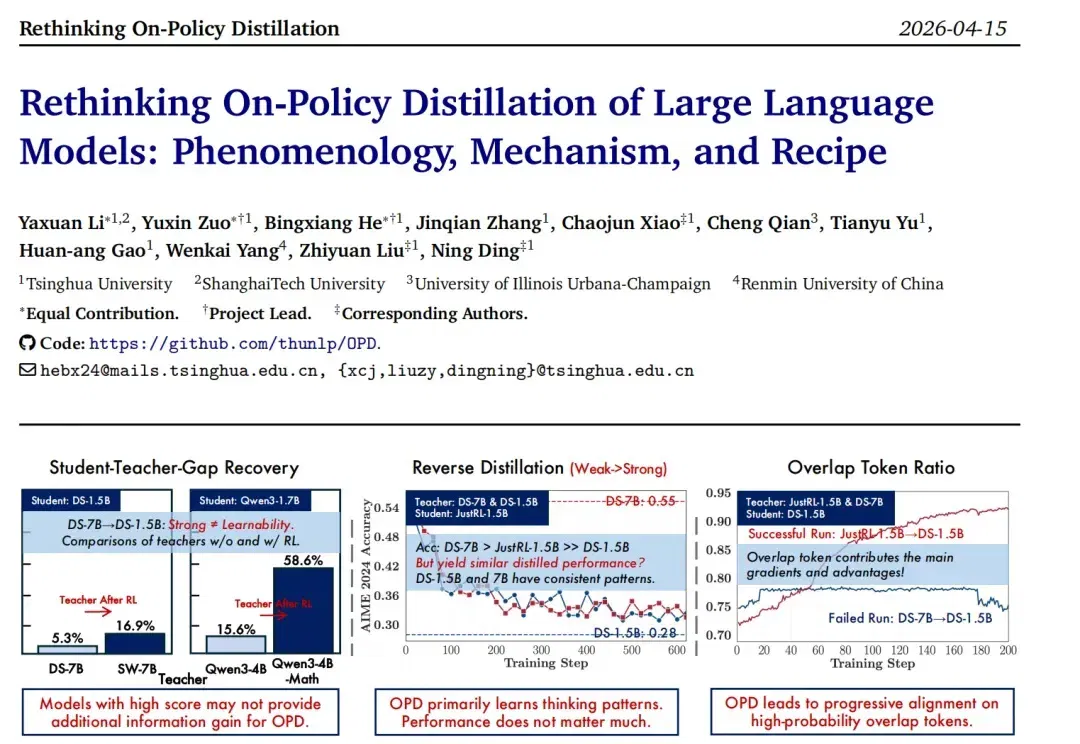
当下的大模型后训练(Post-training)pipeline 中,On-Policy Distillation(OPD)已经成为了明星技术。从 Qwen3、MiMo 到 GLM-5,业界纷纷采用 OPD 并报告了巨大的性能提升。相比于强化学习(RL)稀疏的结果奖励,OPD 提供了密集的 Token 级别监督信号,看起来就像是一顿「免费的午餐」。
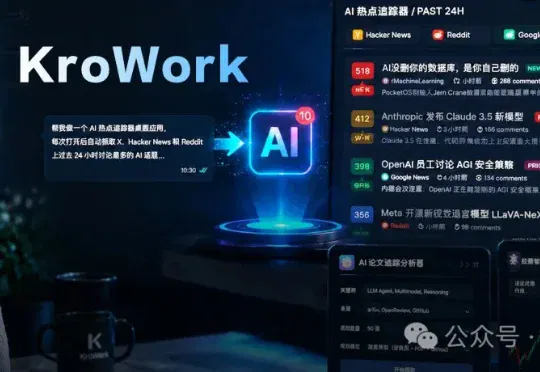
最近快手上线的KroWork,解决的就是这件事。让没有技术背景的普通人也拥有制造这类工具的能力!你跟它说一遍需求,它帮你把活儿干完,然后直接把整个流程变成一个可以直接打开的、有界面的、能反复使用的本地软件。
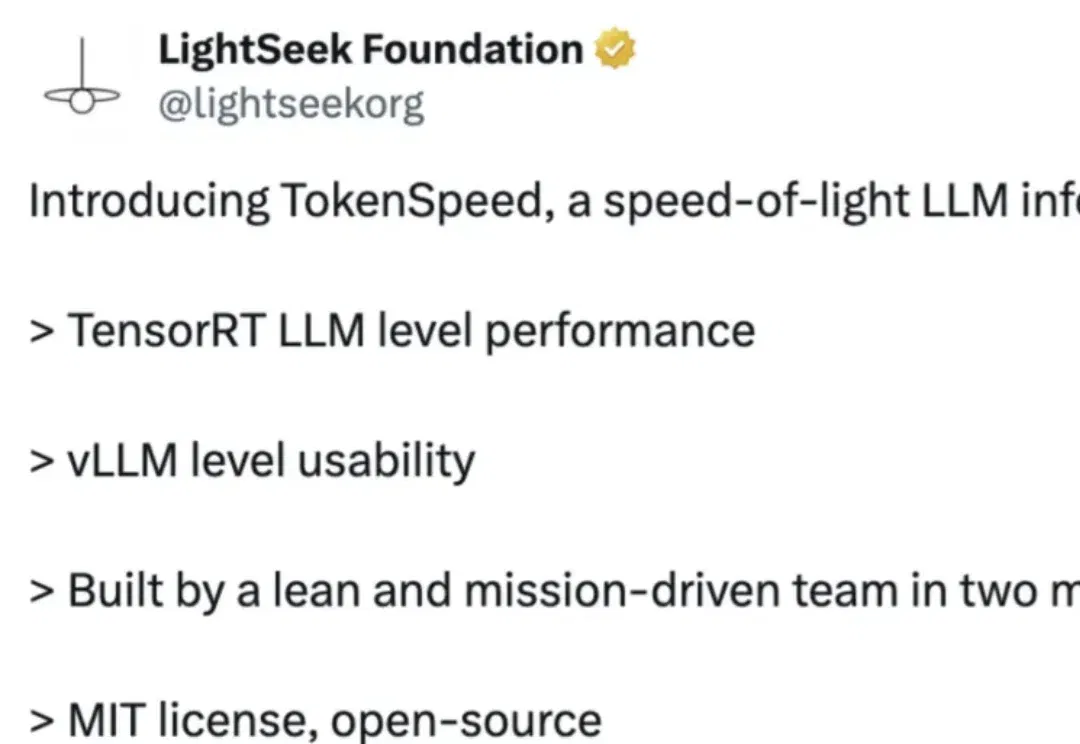
智能体时代的核心是算力。 尤其是在 Coding Agent 爆发之后,算力问题变得前所未有地尖锐。Claude Code、Codex、Cursor 等产品正在把 AI 从「问答工具」变成「持续运行的软件协作者」,单次会话轻松突破 50K tokens,系统负载转向了更极端、更复杂的智能体负载。 最近有关算力的大新闻层出不穷。今天的最新消息:马斯克的 SpaceX 与 Anthropic 宣布达成了重磅协议,超过 22 万块英伟达 GPU 将为 Anthropic 所用。而 Anthropic 对与 SpaceX 合作开发未来的太空算力体系「表示有兴趣」。 在如此庞大的算力需求下,除了开源还有
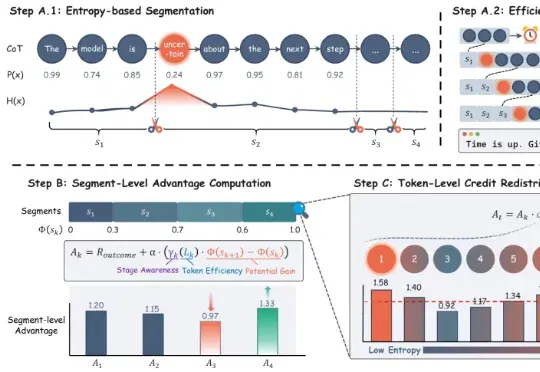
来自华为泰勒实验室、北京大学和上海财经大学的研究团队提出了 SHAPE(Stage-aware Hierarchical Advantage via Potential Estimation),给推理链装上了一套「里程碑 + 推理税」机制——不仅告诉模型每一步推得对不对,还让它为啰嗦付出代价。结果是:准确率平均提升 3%,token 消耗直降 30%。
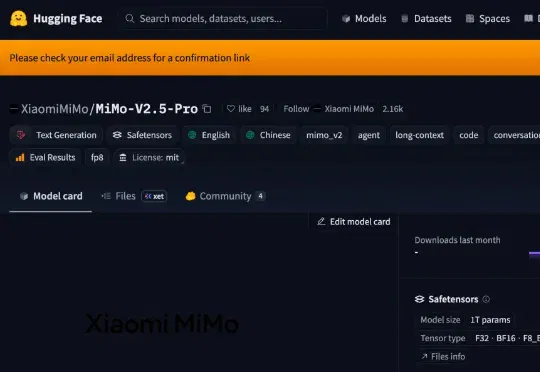
刚刚,小米开源罗福莉带队研发的MiMo-V2.5系列模型,采用MIT协议,允许商用推理部署与二次训练,无需额外授权。此前,该系列模型于4月23日开启公测,包括MiMo-V2.5-Pro、MiMo-V2.5两款模型。模型具备更强Agent能力,支持100万上下文,且Token效率大幅提升。
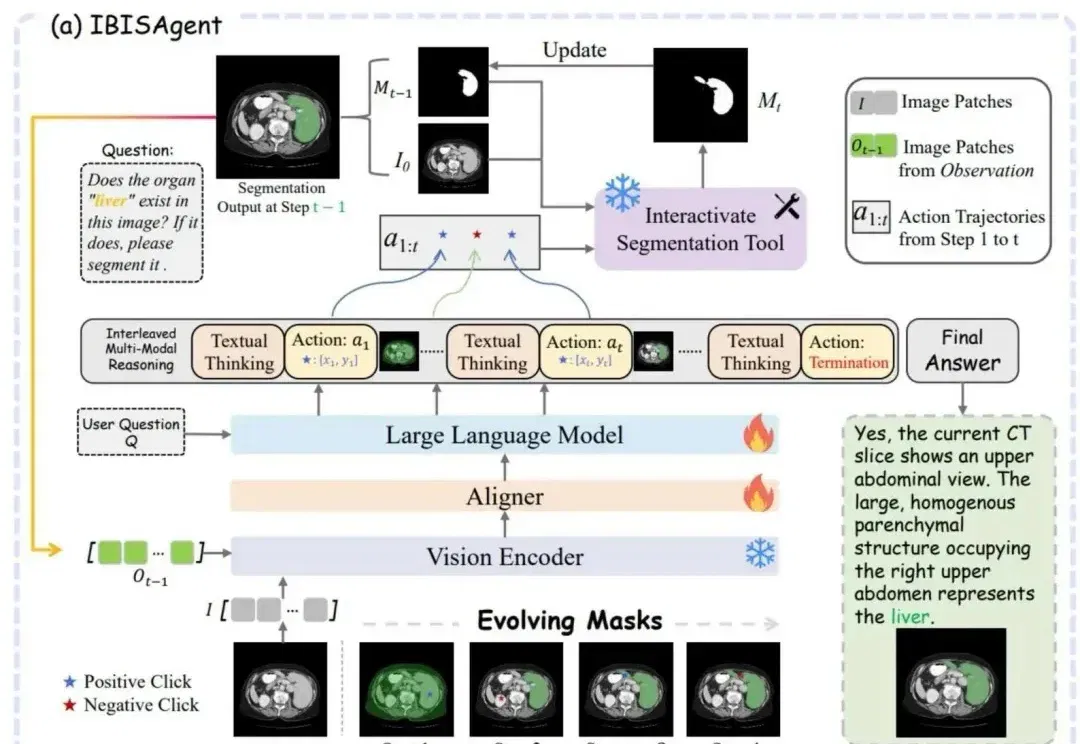
这个生物医学视觉推理框架,被CVPR 2026接收了!
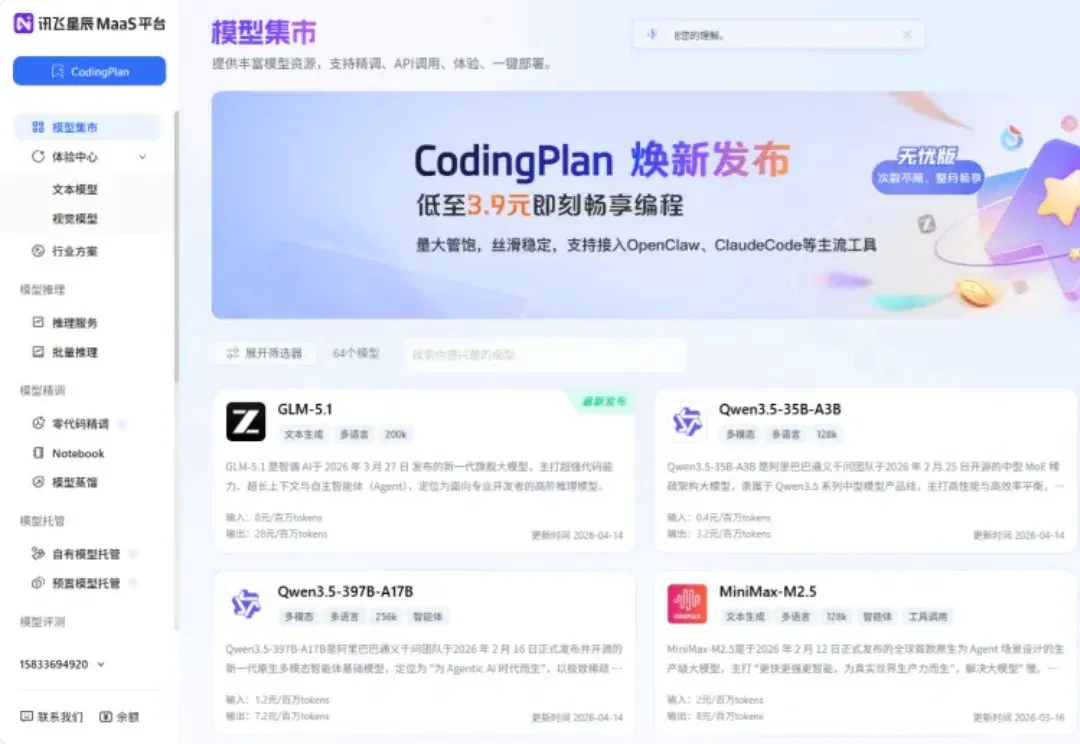
养虾已经成为我们团队的日常了,几乎人手都有一只🦞要养,不仅能实时抓取全网前沿 AI 资讯速递,还能干一些搬砖杂活。
模思智能成立于2024年,位于上海徐汇区,由上海创智学院与复旦大学联合孵化,是国内少数完成“全模态基座模型能力闭环”的初创公司之一,致力于构建统一Token表达框架下的“情境智能”能力,推动Agent系统在真实世界中的自主交互与任务执行。
在使用体验上,龙虾的另一大特色是“活人感极强”。以往的AI,用户不搭话,它就永远沉默;而龙虾的机制则是「心跳」:每隔30秒,自己给自己发一条消息,反思有没有事情做,有的话就去做,没有的话就“没事,继续睡”。当然,这种活人感的代价,是燃烧的Tokens。