微软机房大量英伟达GPU开始吃灰……(在新窗口打开)
你敢想,微软堆成山的GPU,只能在库房里吃灰?
共 412 篇
你敢想,微软堆成山的GPU,只能在库房里吃灰?
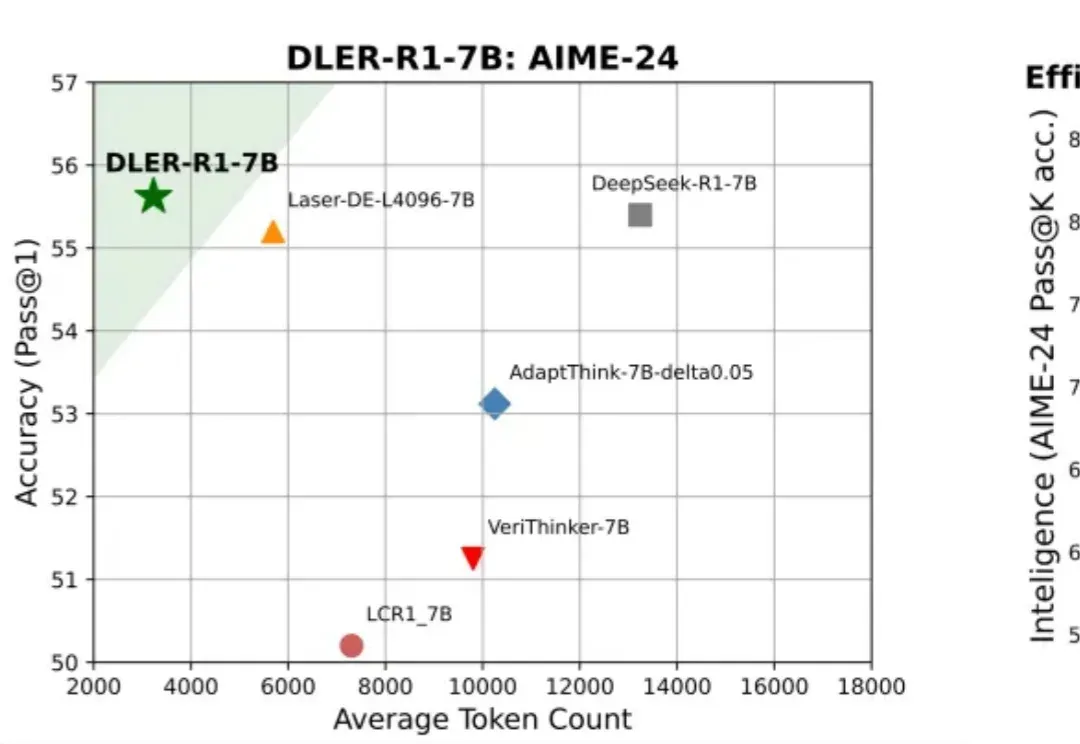
大模型推理到底要不要「长篇大论」?过去一年,OpenAI o 系列、DeepSeek-R1、Qwen 等一系列推理模型,把「长链思维」玩到极致:答案更准了,但代价是推理链越来越长、Token 消耗爆炸、响应速度骤降。
是孩子该看的东西。 「这是我的新项目,10 块 GPU,价值两万美元。」 全球最大的游戏主播,居然开始转型搞 AI 了,没过半天就获得了 100 万播放量。 上周末,PewDiePie 久违地发布了新视频,出乎人们预料的是,内容是在教你训练 AI 大模型。 在这个题为《STOP. Using AI Right now》(停。现在使用 AI)的新视频中,他解释了自己如何从零开始,通过添加搜索、记忆、RAG 和音频输出等功能,创建出个人专属的 ChatGPT 风格用户界面。 他还自己组装了一套硬件系统,共计 10 块英伟达 GPU,使用参数量从 700 亿到 2450 亿不等的大型语言模型,所有这
硅谷巨头正秘密培养第一批「AI原生代」。地点却选在了大学!在亚马逊、OpenAI、Meta、英伟达等巨头的推动下,CSU想成为美国首个并且是最大的AI赋能大学!
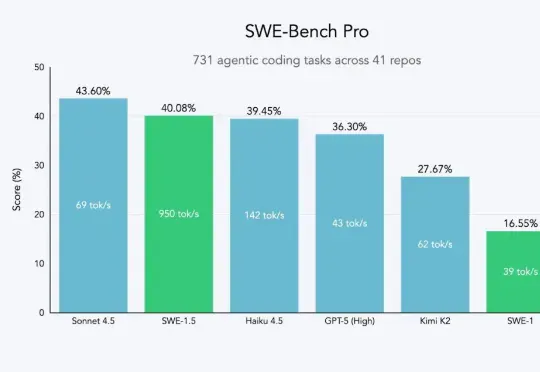
近日,开发出 Devin 智能体的知名人工智能公司 Cognition 推出其全新高速 AI 编码模型 SWE-1.5。据介绍,该模型专为在软件工程任务中实现高性能与高速度而设计,现已在 Windsurf 代码编辑器中开放使用。今年 7 月,Cognition 高调收购开发工具 Windsurf。
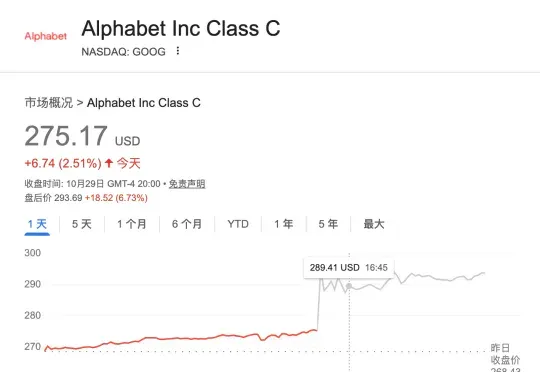
Nano Banana成为爆款之后,Gemini月活达到了6.5亿。AI业务带动之下,谷歌季度营收也首次突破千亿美元,交出了有史以来最亮眼的成绩单。什么概念?市值刚刚突破5万亿美元的英伟达,2025财年上半年的收入也刚刚突破1000亿。
这次不仅发布自研编码模型Composer,还重构了IDE交互逻辑,可以最多8个智能体同时跑,早期测试和开发者都说Cursor 2.0真的太快了。Composer的速度是同等模型的4倍。Cursor说这是一款专门为低延迟智能编码打造的模型,大部分任务都可以在30秒以内完成。
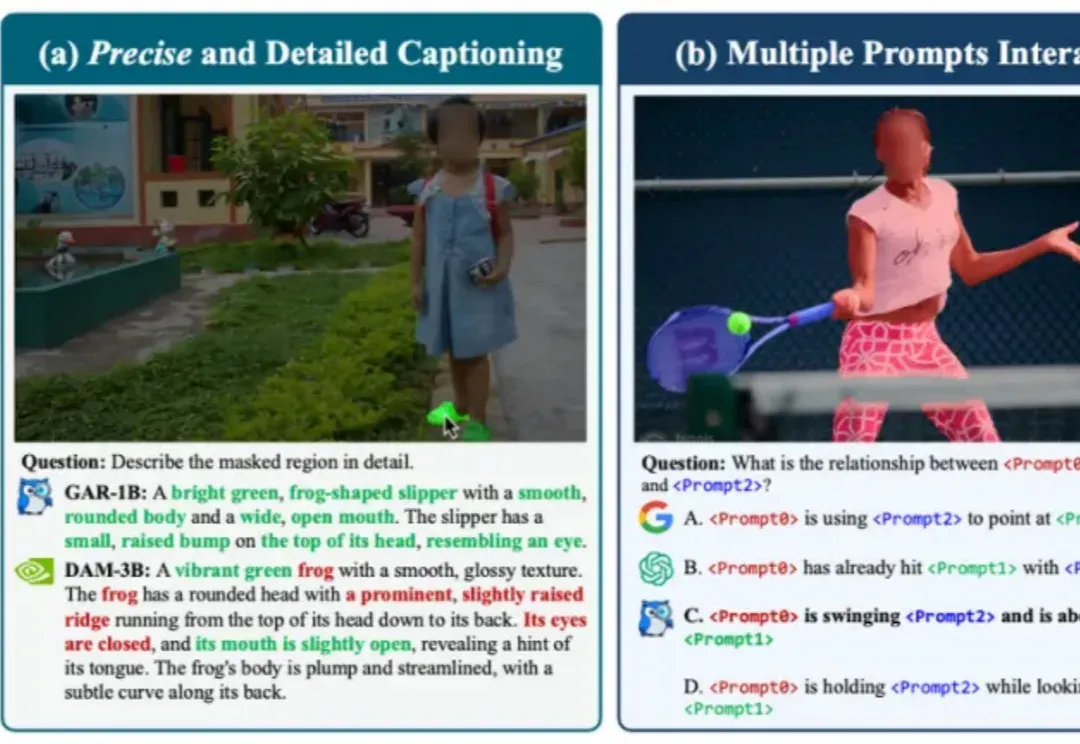
近期,DeepSeek-OCR提出了“Vision as Context Compression”的新思路,然而它主要研究的是通过模型的OCR能力,用图片压缩文档。
今日(10 月 28 日),高通正式宣布推出两款全新芯片——高通 AI200 和高通 AI250,以及相应的机架级解决方案。此举直接挑战了由英伟达和超威半导体长期主导的 AI 芯片领域。消息宣布后,高通股价依然应声飙升,涨幅超 11%,创 2024 年 7 月以来新高。
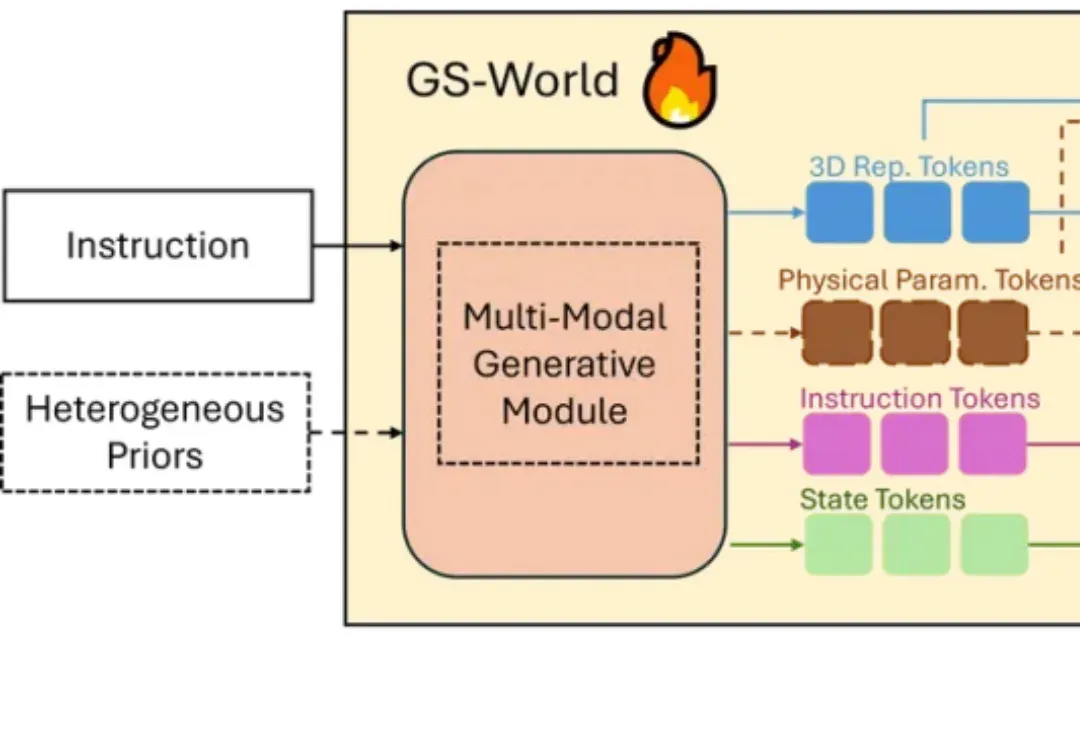
2025 年秋的具身智能赛道正被巨头动态点燃:特斯拉上海超级工厂宣布 Optimus 2.0 量产下线,同步开放开发者平台提供运动控制与环境感知 SDK,试图通过生态共建破解数据孤岛难题;英伟达则在 SIGGRAPH 大会抛出物理 AI 全栈方案,其 Omniverse 平台结合 Cosmos 世界模型可生成高质量合成数据,直指真机数据短缺痛点。