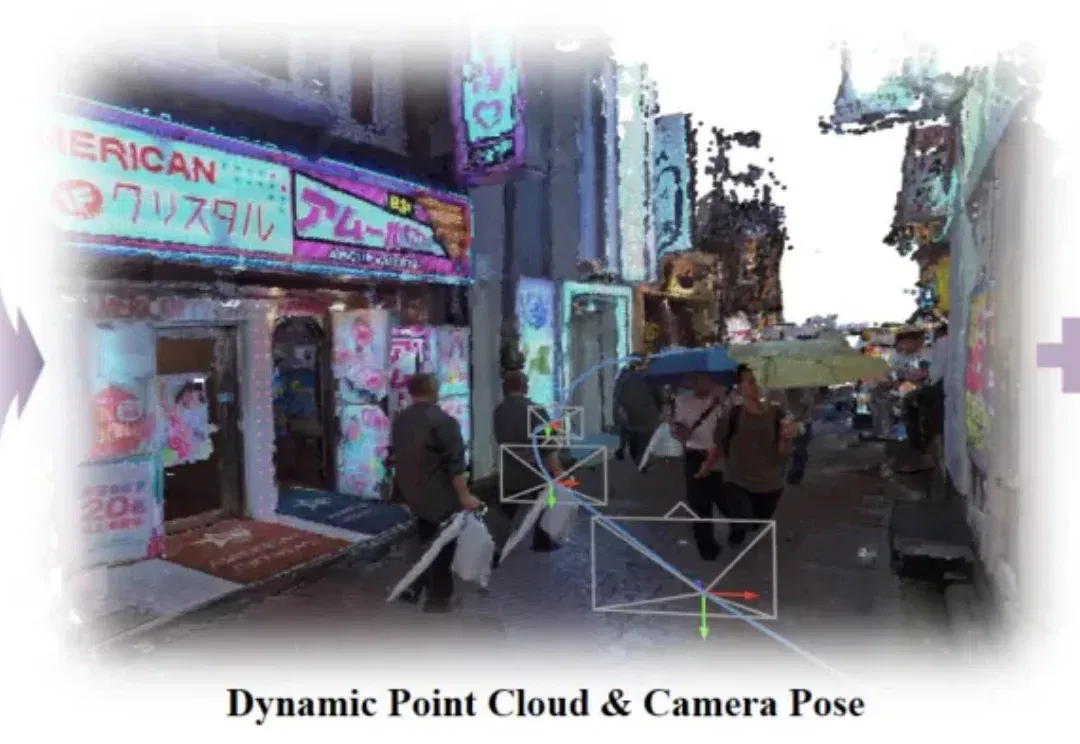
CVPR 2026|DROID-W:复杂室外动态场景,也能稳定SLAM(在新窗口打开)
SLAM 在自动驾驶、机器人、AR/VR 乃至具身智能系统中都是至关重要的环节,它决定了算法能否在一个陌生环境中一边“看懂世界”,一边“知道自己在哪”。
共 427 篇
SLAM 在自动驾驶、机器人、AR/VR 乃至具身智能系统中都是至关重要的环节,它决定了算法能否在一个陌生环境中一边“看懂世界”,一边“知道自己在哪”。
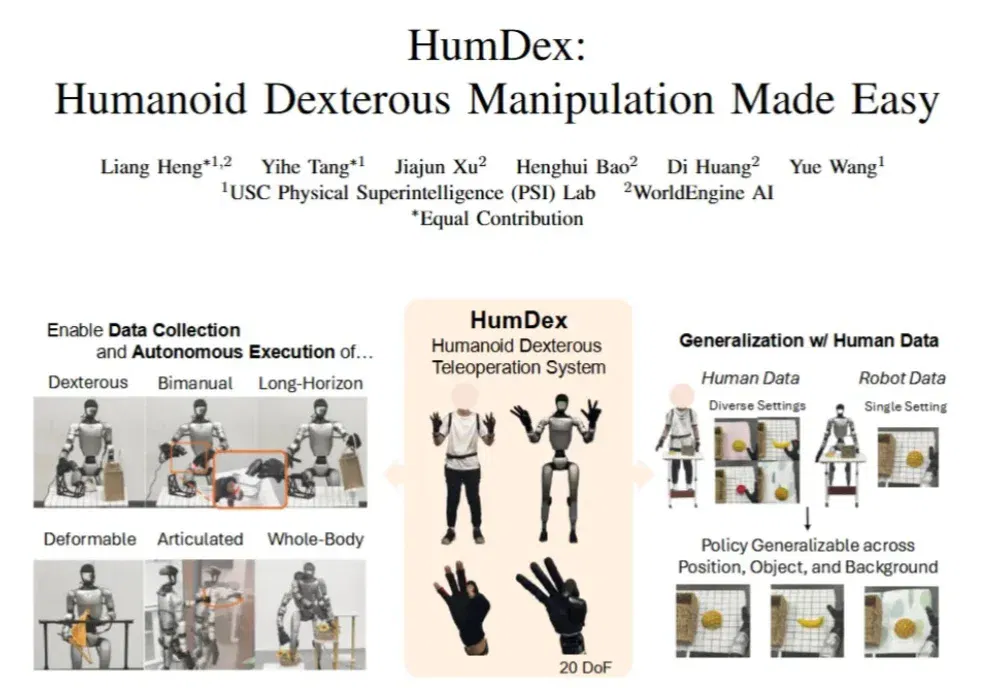
人形机器人全身灵巧操作是通向通用具身智能的核心目标之一。在这一愿景下,机器人不仅需要双臂与高自由度多指灵巧手的精细协调,还需要与全身位姿(如行走、弯腰)进行动态配合。
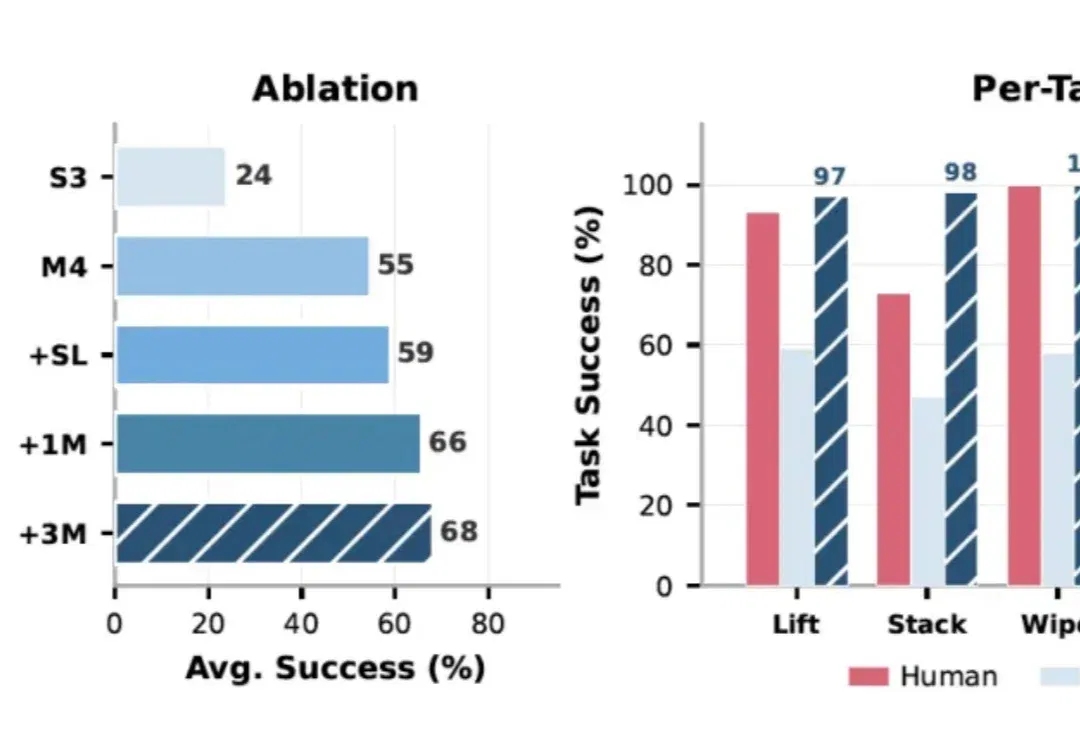
Harness(驾驭)的风,终究还是从大模型,吹到了机器人!
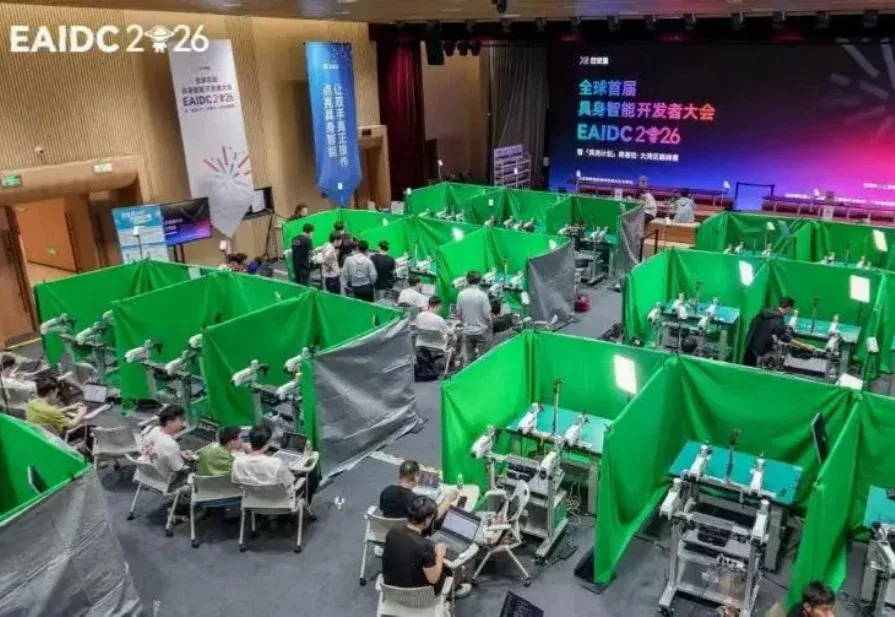
没有仿真,没有预设参数,也没有剪辑空间。
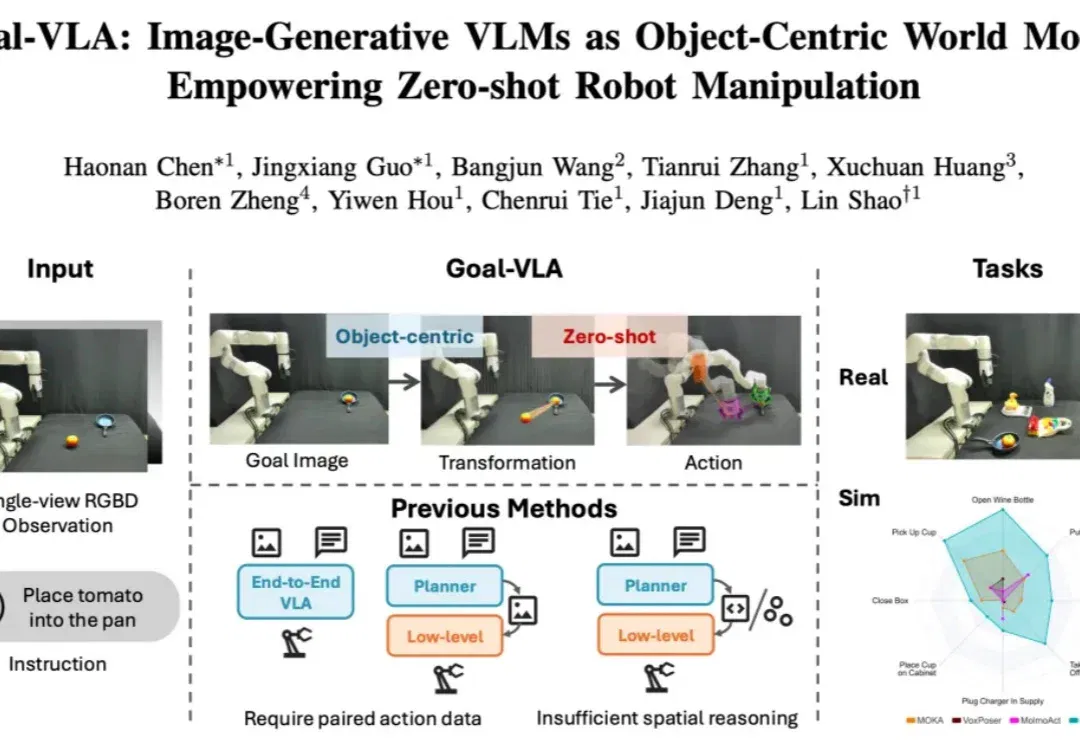
在具身智能领域,机器人操作的泛化能力一直是一个核心挑战。当前,视觉 - 语言 - 动作(VLA)模型主要分为两大范式:端到端模型与分层模型。端到端 VLA 模型(如 RT-2 [1], OpenVLA [2])严重依赖海量的 “指令 - 视觉 - 动作” 成对数据,获取成本极高,导致其在面对新任务或新场景时零样本泛化能力受限。
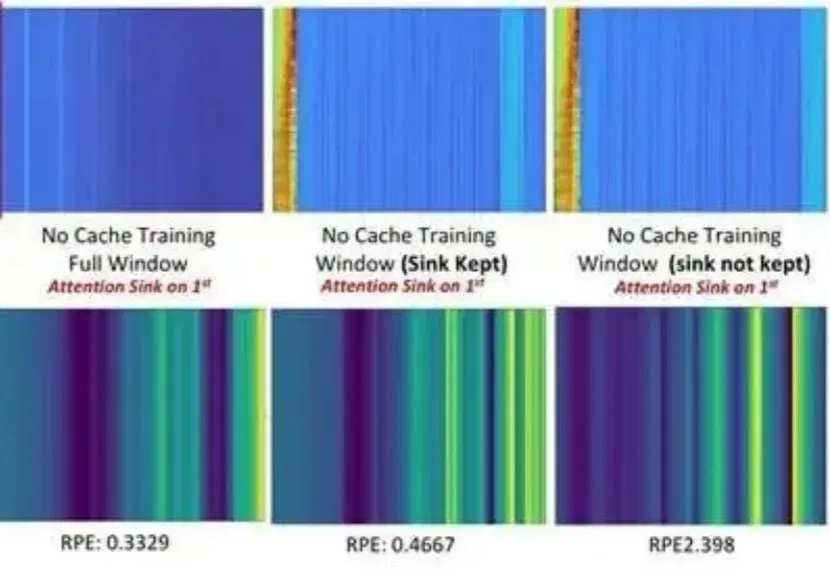
在自动驾驶、具身智能、AR/VR应用中做3D重建,大家都想解决一个终极问题: 模型能不能像人一样,一边往前看,一边持续构建三维世界?
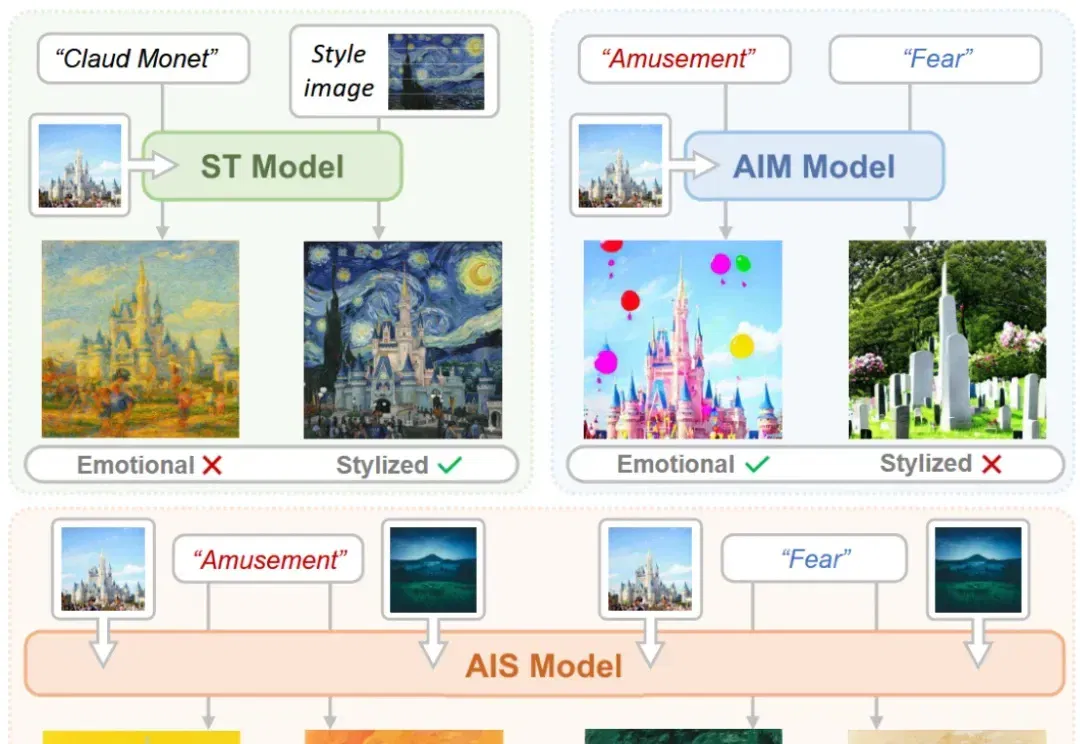
EmoStyle 由深圳大学可视计算研究中心黄惠教授课题组独立完成,第一作者为杨景媛助理教授,第二作者为研二硕士生柏梓桓。深圳大学可视计算研究中心(VCC)以计算机图形学、计算机视觉、人机交互、机器学习、具身智能、可视化和可视分析为学科基础,致力前沿探索与跨学科创新。
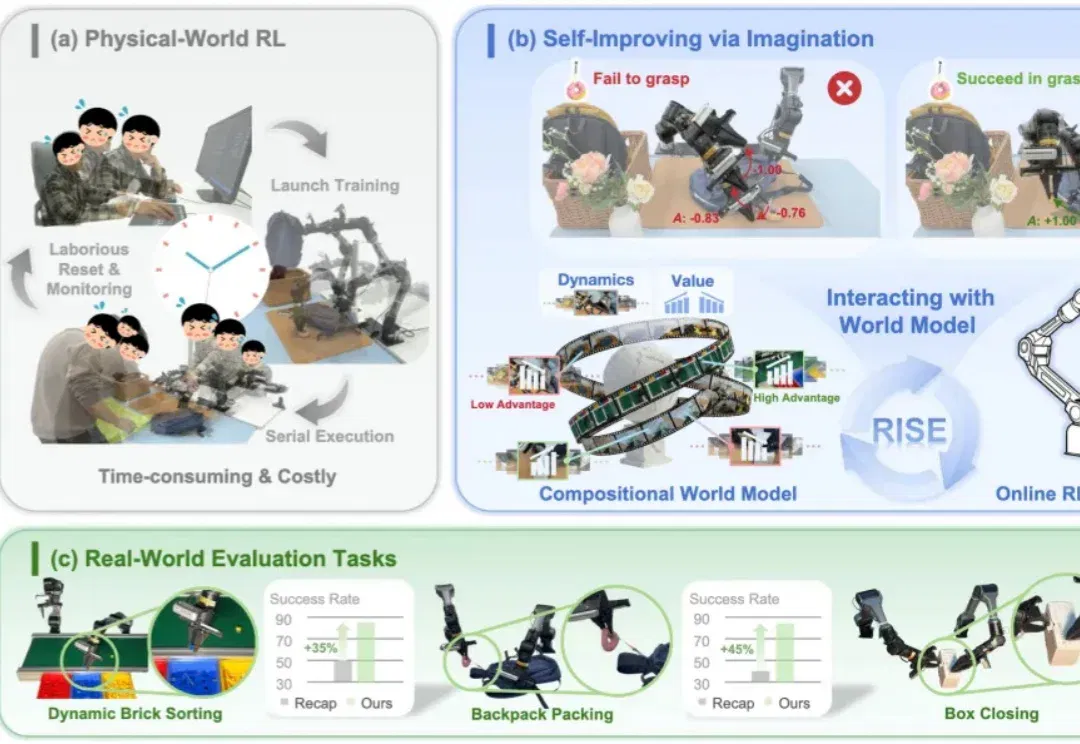
在具身智能的发展路径中,视觉 - 语言 - 动作(VLA)模型正逐步成为通用操作任务的核心框架。但当任务进入长程规划、柔性物体操作、精细双臂协同、动态交互等复杂场景时,VLA 仍然面临两个根本性挑战:
葬AI花了小几千为家人们测评了一堆没用的AI硬件,后续排上日程的还有带摄像头的AI耳机的光帆科技和带摄像头的AI健康项链OdyssLife🥵
都2026年了,一个越来越难回避的现实是:很多行业,真的在被AI重做一遍。