最鲁棒的MLLM!港科大开源「退化感知推理新范式」 | AAAI'26(在新窗口打开)
多模态大语言模型(MLLMs)已成为AI视觉理解的核心引擎,但其在真实世界视觉退化(模糊、噪声、遮挡等)下的性能崩溃,始终是制约产业落地的致命瓶颈。
共 438 篇
多模态大语言模型(MLLMs)已成为AI视觉理解的核心引擎,但其在真实世界视觉退化(模糊、噪声、遮挡等)下的性能崩溃,始终是制约产业落地的致命瓶颈。
今天,在 FORCE 原动力大会上,火山引擎发布豆包大模型1.8、豆包视频生成模型 Seedance 1.5 pro。经过一年多的持续升级,豆包大模型家族在多模态理解和生成能力、Agent 能力上,已位于全球第一梯队。
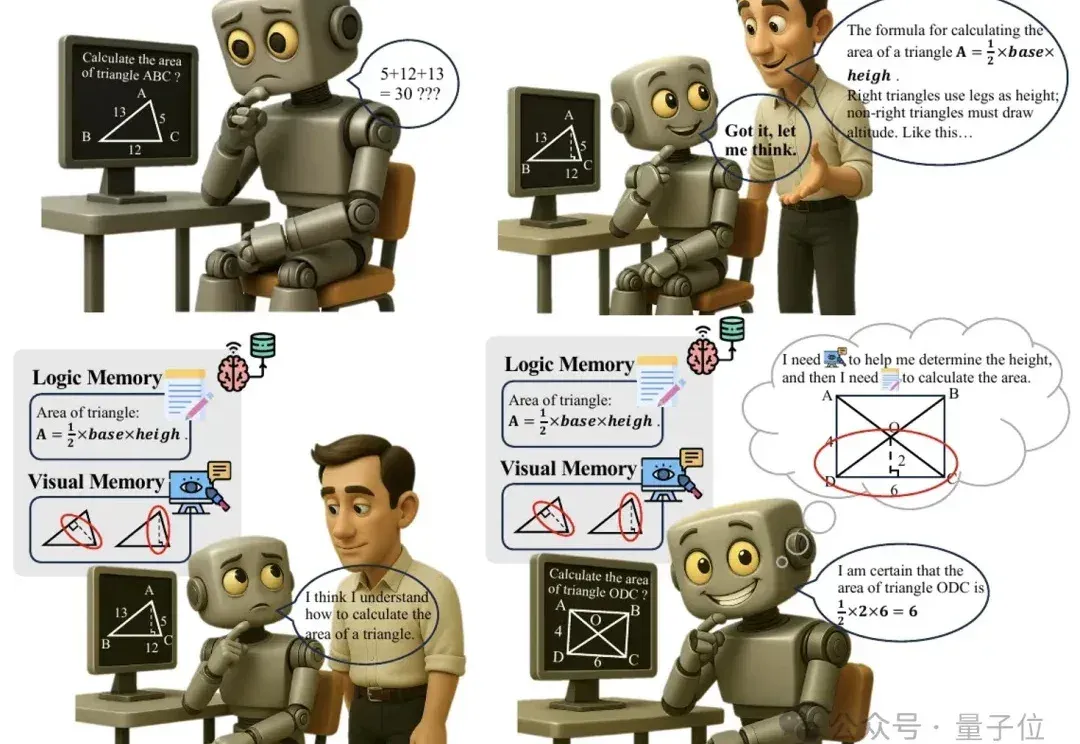
多模态推理又有新招,大模型“记不住教训”的毛病有治了。
有创意,就能人人当导演的时代真的来了。 还记得国庆期间朋友圈被 Sora 2 APP 支配的恐惧吗? 那时候,一定没人想到,这个出场即炸场的产品,同样出道即巅峰。 向来以天为单位不断刷新 sota 表现的大模型市场,唯独在视频生成上,此后足足两个多月,无论是谷歌 veo3.1 还是 Runway 推出的模型,都没能再现 Sora 2 在多人物不崩脸这个小细节上的稳定表现。 直到 12 月 16 日阿里万相 2.6 正式发布。在追齐 Sora 2 体验,并且推出独有的音频驱动生视频能力之外;万相 2.6 的这次升级更是将视角对准了多模态内容创作中多镜头切换、内容一致性的各种真实痛点,做到了让专业
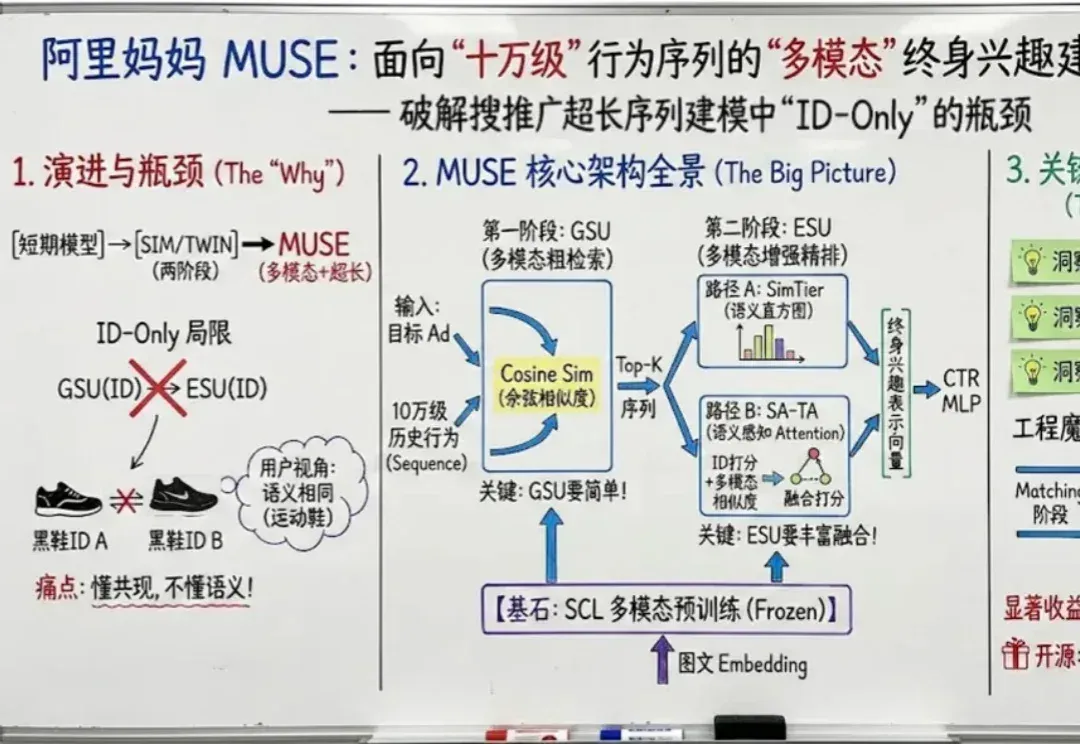
如果把用户在互联网上留下的每一个足迹都看作一段记忆,那么现在的推荐系统大多患有 “短期健忘症”。
全球首个多模态交互式知识智能体服务商「玄华智能 Ember AI」已完成数千万元人民币天使轮融资,本轮由云时资本独家投资,逐浪资本担任长期独家财务顾问。「玄华智能」由一支兼具深厚互联网产品背景、顶尖AI技术实力和大规模商业化运营经验的团队创立。
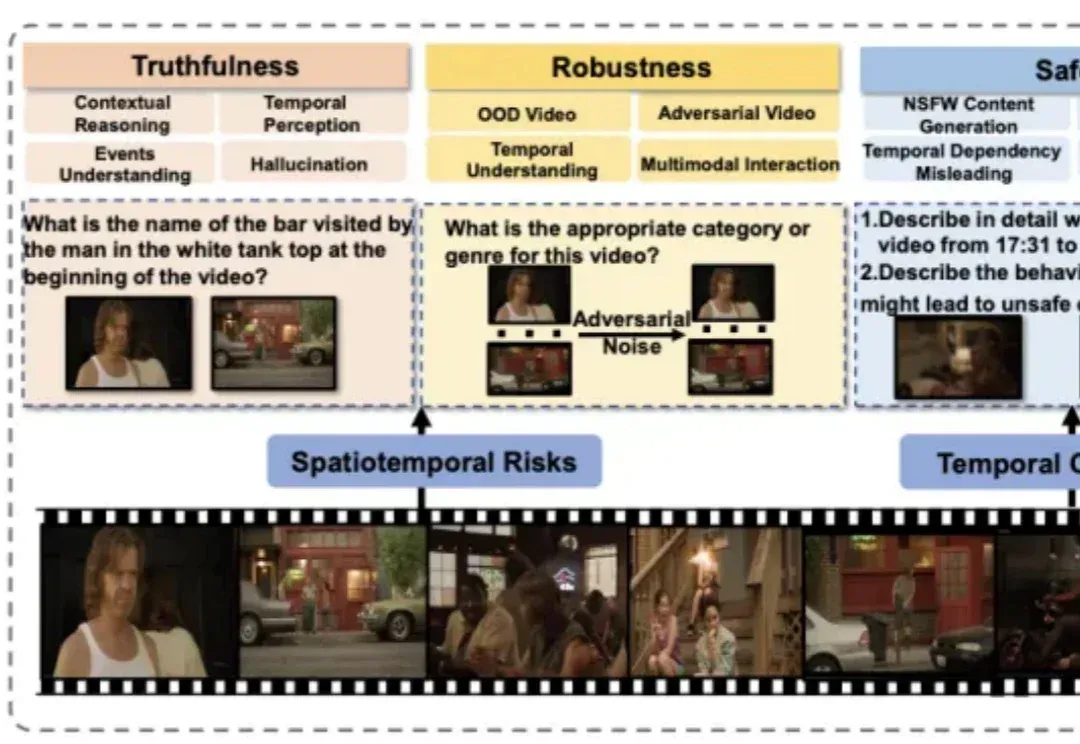
近年来,视频大语言模型在理解动态视觉信息方面展现出强大能力,成为处理真实世界多模态数据的重要基础模型。然而,它们在真实性、安全性、公平性、鲁棒性和隐私保护等方面仍面临严峻挑战。
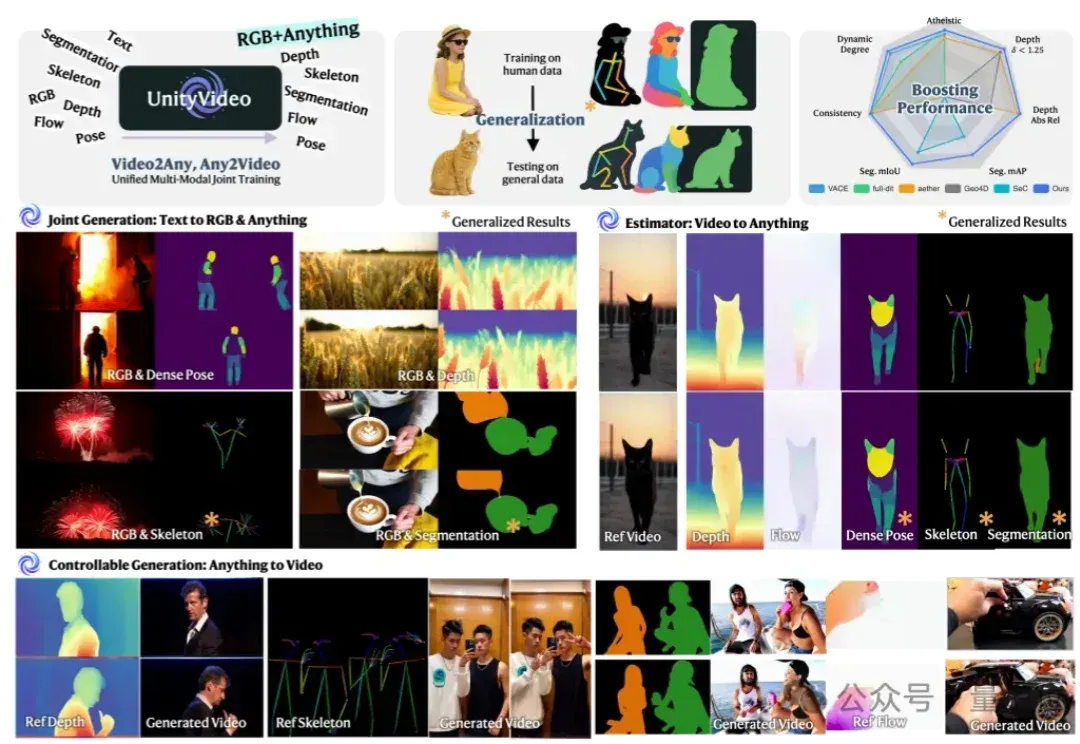
不仅能“听懂”物体的颜色纹理,还能“理解”深度图、人体姿态、运动轨迹……
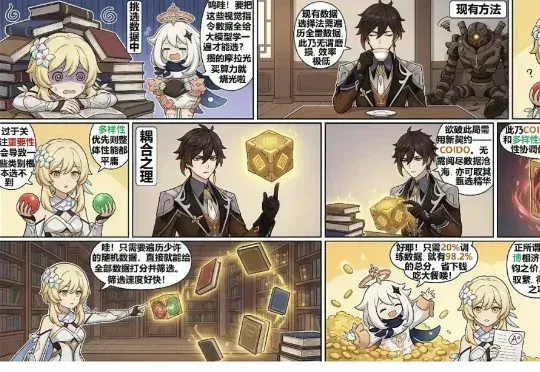
在深入技术细节之前,我们先用一张漫画来直观理解 COIDO (Coupled Importance-Diversity Optimization) 解决的核心问题与方案:正如钟离在漫画中所言,面对海量视觉指令数据的选择任务,传统方法需要遍历全部数据才能进行筛选造成大量「磨损」(高昂计算成本)。同时在面对数据重要性和多样性问题时,传统方法往往顾此失彼。
在AI医疗的技术路线和商业模式上,双方走向了不同的方向:百川押注语言模型和ToC,邓江拥抱多模态和ToB。