谷歌真急了!深夜更新Deep Research智能体,支持MCP、原生图表(在新窗口打开)
谷歌真是急了。 前脚刚传来消息,称谷歌联合创始人谢尔盖·布林重启“创始人模式”,亲自督战并组建精英“突击队”,全力提升Gemini在AI编程和自主智能体等关键能力上追赶Anthropic等对手。 后脚
共 483 篇
谷歌真是急了。 前脚刚传来消息,称谷歌联合创始人谢尔盖·布林重启“创始人模式”,亲自督战并组建精英“突击队”,全力提升Gemini在AI编程和自主智能体等关键能力上追赶Anthropic等对手。 后脚
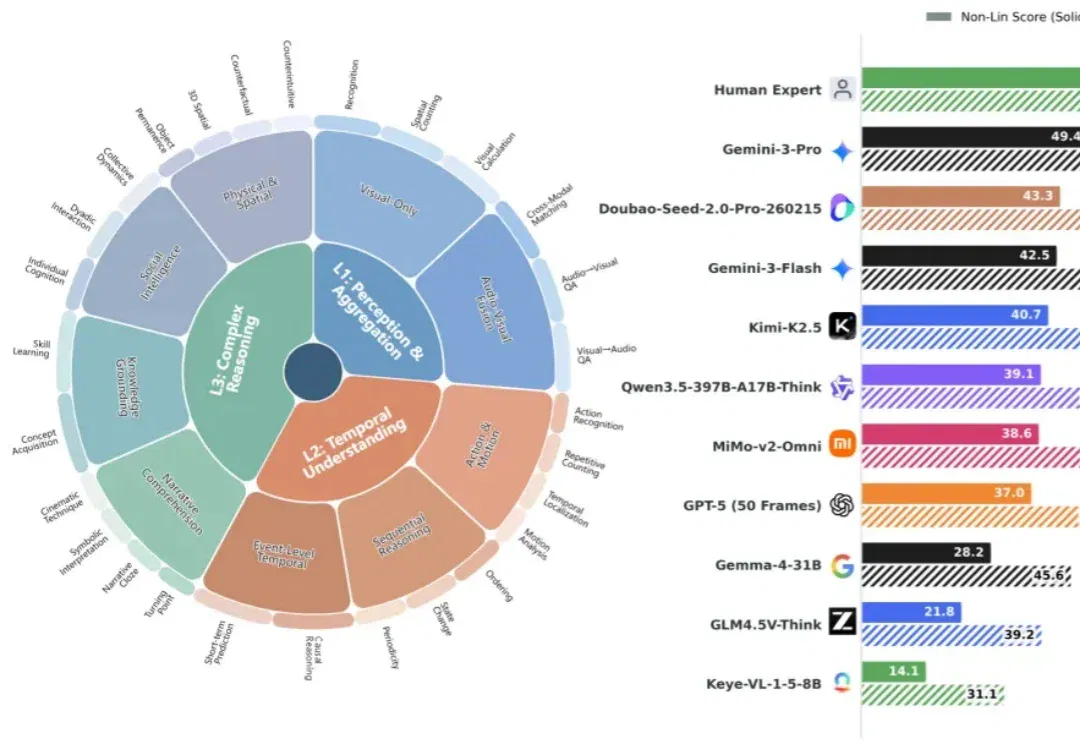
现有大模型评测分数日趋饱和,但与真实体验差距显著。南京大学傅朝友团队牵头,在 Google Gemini 评测团队邀约下推出视频理解新基准 Video-MME-v2。凭借创新的分层能力体系与组级非线性评分,以及 3300 + 人工时高质量标注,揭示模型与人类的巨大鸿沟(49 vs 90)、传统 Acc 指标虚高、以及 “Thinking” 并非总是增益等现象。
现有大模型评测分数日趋饱和,但与真实体验差距显著。南京大学傅朝友团队牵头,在Google Gemini评测团队邀约下推出视频理解新基准Video-MME-v2。凭借创新的分层能力体系与组级非线性评分,以及3300+人工时高质量标注,揭示模型与人类的巨大鸿沟(49vs90)、传统Acc指标虚高、以及「Thinking」并非总是增益等现象。
Chatbot时代结束了!Google将AI植入Android底层,让它变成一个主动规划一切的系统管家。每个月$19.99+你的全部数据,就能获得一个全天候24h的AI管家。
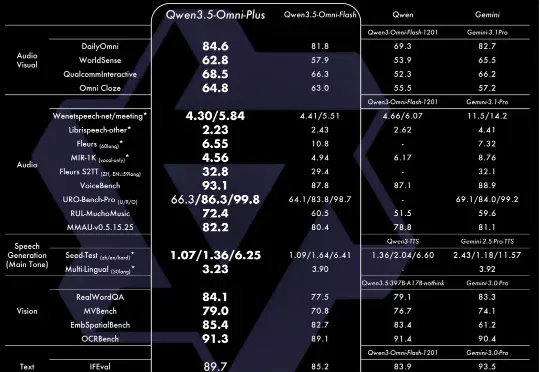
阿里刚刚发布了最新一代全模态大模型 Qwen3.5-Omni,在通用音频理解、推理、翻译和对话等维度,已全面超越 Gemini 3.1 Pro。所谓全模态,在于它拥有了接近人类的“感官”。它能听、能看、能说、能写。
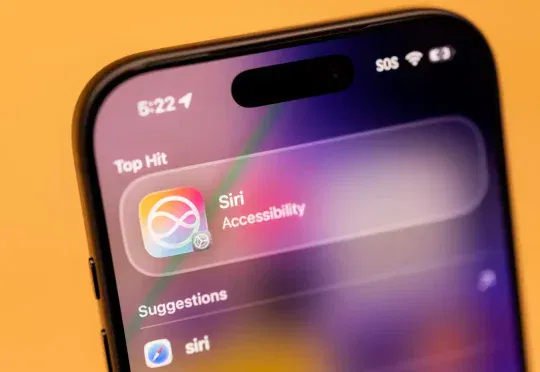
就在刚刚,据彭博社报道,iOS 27 将引入一套名为「Extensions」的新机制,允许用户通过设置面板,把 Google Gemini、Anthropic Claude 等第三方 AI 接入 Siri,就像现在调用 ChatGPT 一样直接从 Siri 发起请求。
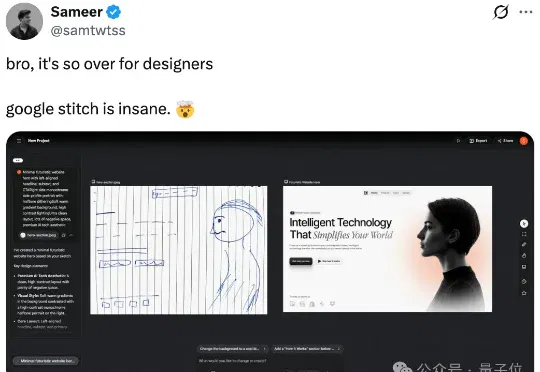
谷歌宣布旗下AI设计工具Stitch支持Vibe Design。你都不需要键盘,只需要用嘴就可以vide design出这样婶儿的UI和前端界面:不得不说,谷歌的审美是真的好。Gemini 3生成前端的艺术效果就有口皆碑。
AI 基础设施公司 Nscale 宣布完成 20 亿美元的 C 轮融资,由 Aker ASA 和 8090 Industries 领投。此次融资使公司估值达到 146 亿美元。参与本轮融资的其他投资者包括 Astra Capital Management、Citadel(城堡投资)、戴尔、Jane Street、联想、Linden Advisors、诺基亚、英伟达以及 Point72。
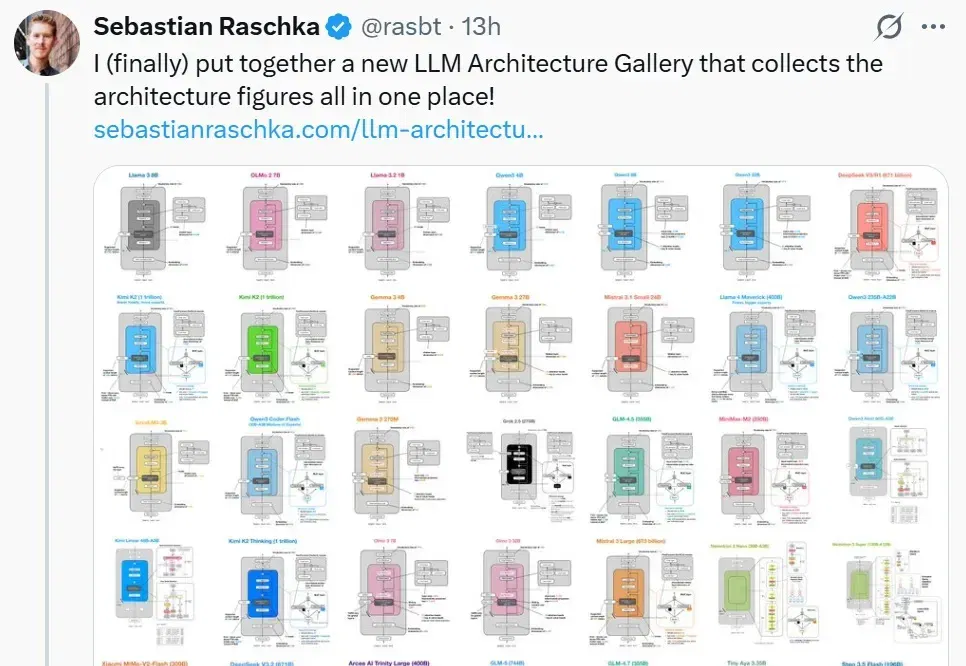
最近几年,大模型赛道好不热闹。 叫得上名字的几乎数都数不过来:从 GPT、Llama、Gemma、Mistral,到 DeepSeek、Qwen、Kimi、GLM、MiniMax 等等,新模型几乎以周更的速度出现。 但问题是,当架构创新越来越多时,理解它们反而变得越来越困难。不同论文里的模型结构图风格各异、模块命名不统一,即便是研究者,也很难快速看清一个模型究竟在哪些地方做出了关键改动。 如果把过去几年主流模型的架构放在一起,你会发现一个明显的空白:我们拥有大量模型,却缺少一张清晰的大模型架构图。 最近,AI 研究者 Sebastian Raschka 就尝试给了这样一张图,他将过去几年主流大
多模态模型代码写得像老司机,却在数手指、量柱子时频频翻车?UniPat AI用五百行代码打造的SWE-Vision,让模型「掏出Python尺子」自我验证,一举拿下五大视觉相关基准SOTA。