ChatGPT 与 Codex 将共享额度:12月调整及 Instant 聊天例外(在新窗口打开)
OpenAI 帮助文档称,12月起 Plus、Pro 等套餐的 ChatGPT 与 Codex 将共享按 Token 衡量的使用额度,消耗随模型和任务变化,Instant 聊天不计入。作者从重度使用者角度讨论计量带来的顾虑;实际可用任务量尚不能仅凭共享规则推算,也不等同于订阅统一改为逐次付款。
共 619 篇
OpenAI 帮助文档称,12月起 Plus、Pro 等套餐的 ChatGPT 与 Codex 将共享按 Token 衡量的使用额度,消耗随模型和任务变化,Instant 聊天不计入。作者从重度使用者角度讨论计量带来的顾虑;实际可用任务量尚不能仅凭共享规则推算,也不等同于订阅统一改为逐次付款。
不准联网,也没有共享可写文件,隔离的 AI 还是传上了话。
Kimi K3.1 Pro 正式发布,具备3万亿级参数和100万 token 上下文,官方评测显示其在代码、Agent及金融等任务取得多项领先,完整权重将于11月4日前开放。
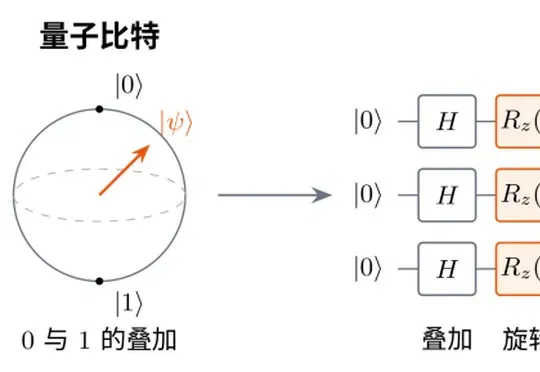
加拿大蒙特利尔大学、Mila 人工智能研究所和麦吉尔大学团队提出 HyperQ,以逐 Token 自适应量子电路增强扩散语言模型,使 11 亿参数模型在六项零样本测试中超过 Qwen3-8B 等 80 亿参数模型,并在 IBM 156 量子比特量子集群完成验证。
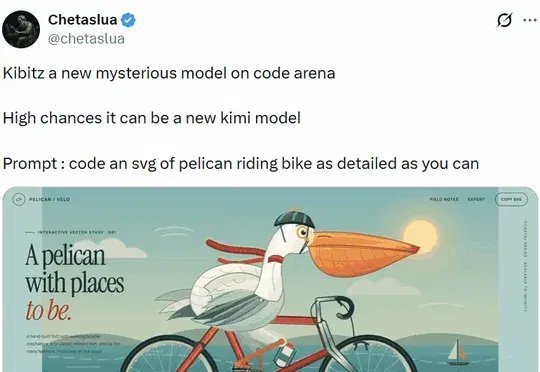
月之暗面正式推出 Kimi K3.1 Pro,认领匿名模型 Kibitz,以3万亿参数和100万token上下文强化Agent、前端与3D创作,并同步上线高速版,完整权重将于11月4日前发布。
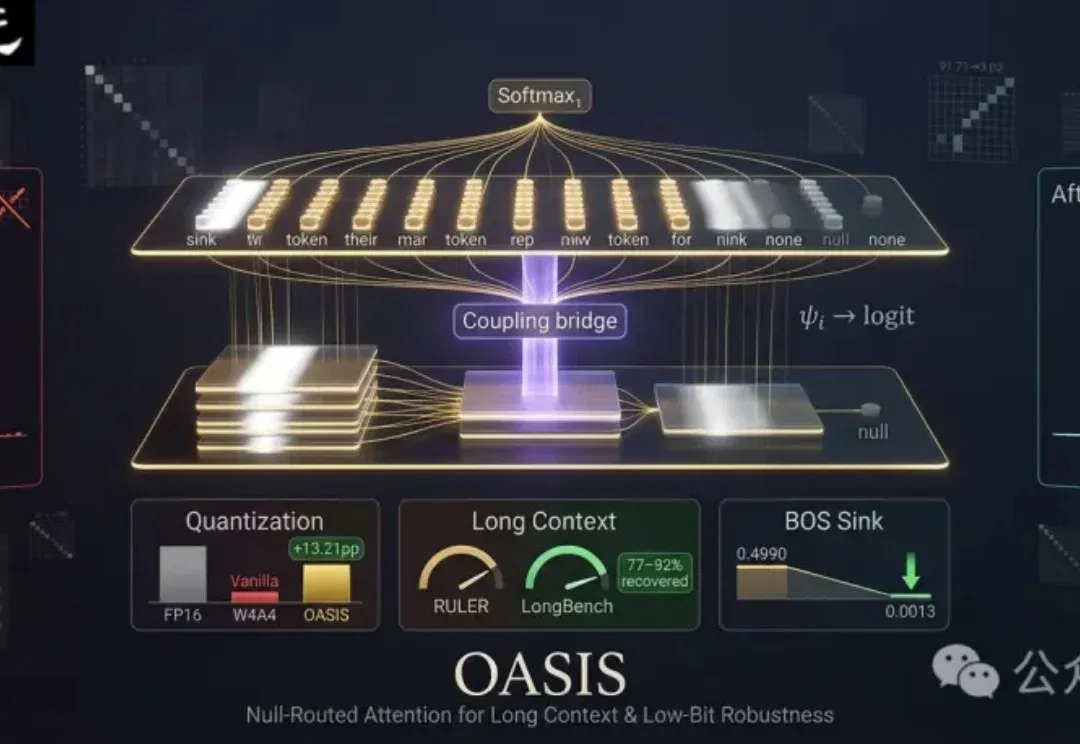
增强模型的表达能力,可以让Transformer更灵活地读取和整合信息。Attention Residuals(AttnResidual)沿着这个方向,将注意力从token之间的信息交互扩展到网络深度,让每个子层学习选择哪些历史层输出。
MiniMax 更新 MiniMax M3.1 Flash,并确认此前处理超200万亿 Token 的匿名模型 Space Bunny 为其早期版本;官方称新模型线上推理速度提升近3倍,Agent 类任务综合使用成本较前代降低70%。
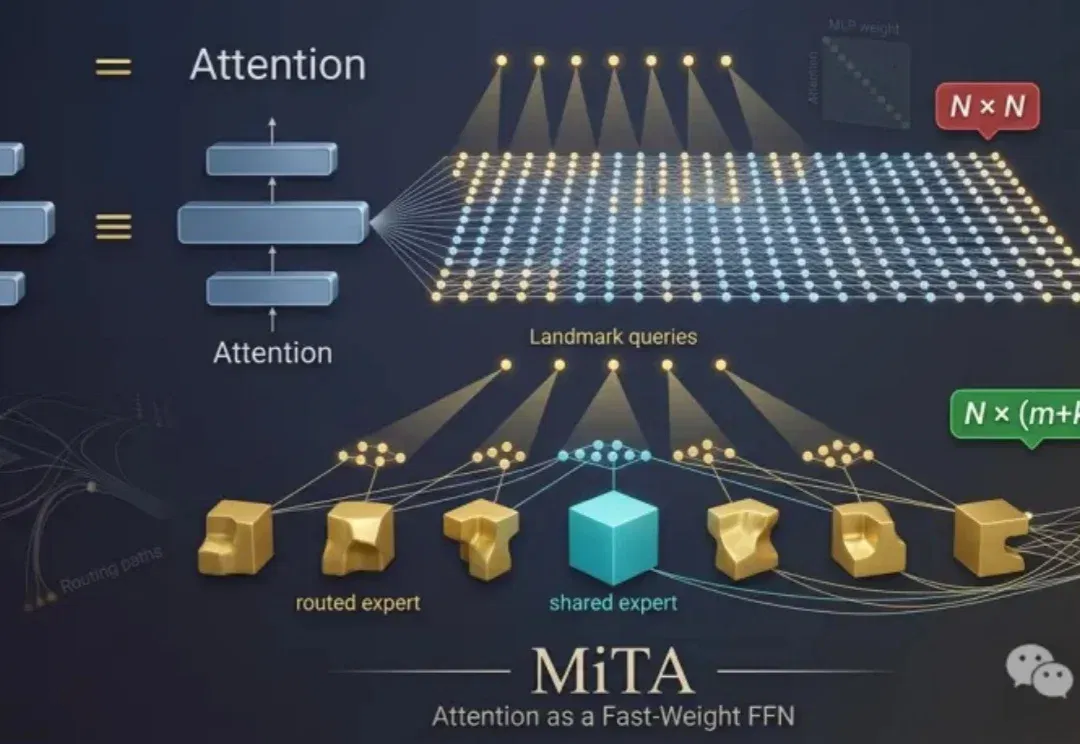
一直以来,在Transformer架构中,注意力(Attention)与前馈网络(Feed-Forward Network,FFN)被认为是两个功能不同且互补的模块: 前者让词元(Token)彼此交互,后者对每个词元进行非线性变换。
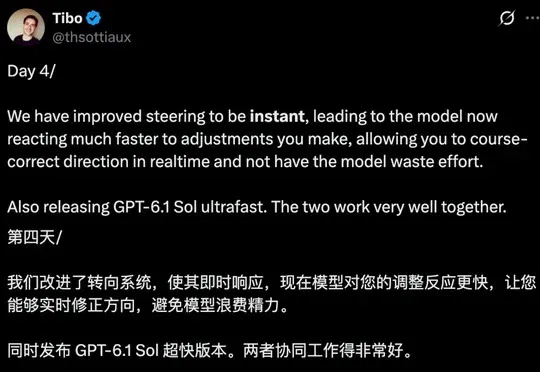
OpenAI推出GPT-6.1 Sol Ultrafast,智能水平接近Astra、最高速度为Sol标准版8倍,API定价为每百万输入token 12美元、输出60美元,Codex和ChatGPT Work仅向特定高阶用户开放。
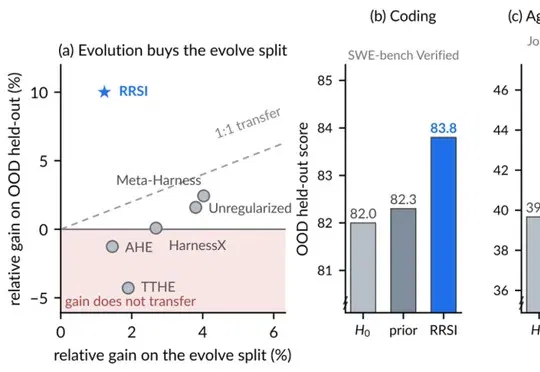
Google等提出RRSI,通过正则化Agent Harness自我改进中的Proposal与Selection,减少过拟合与复杂度累积,并提升未见基准上的迁移表现、降低Token成本。