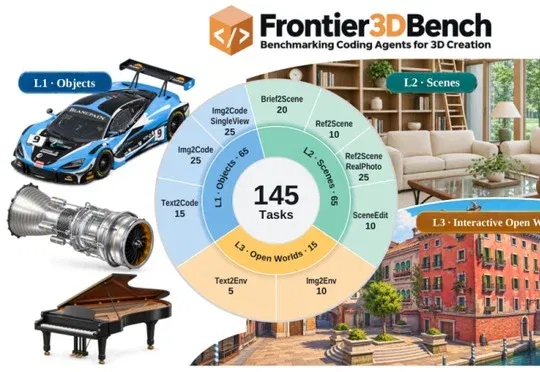
Frontier3DBench 测量智能体制作 3D 物体、场景与开放世界的能力(在新窗口打开)
Einsia AI 用 Blender 和 Unreal Engine 中的 145 项任务比较 11 种模型与工具组合。评测发现连续移动、避障和状态管理比局部交互更容易失分。
共 887 篇
Einsia AI 用 Blender 和 Unreal Engine 中的 145 项任务比较 11 种模型与工具组合。评测发现连续移动、避障和状态管理比局部交互更容易失分。
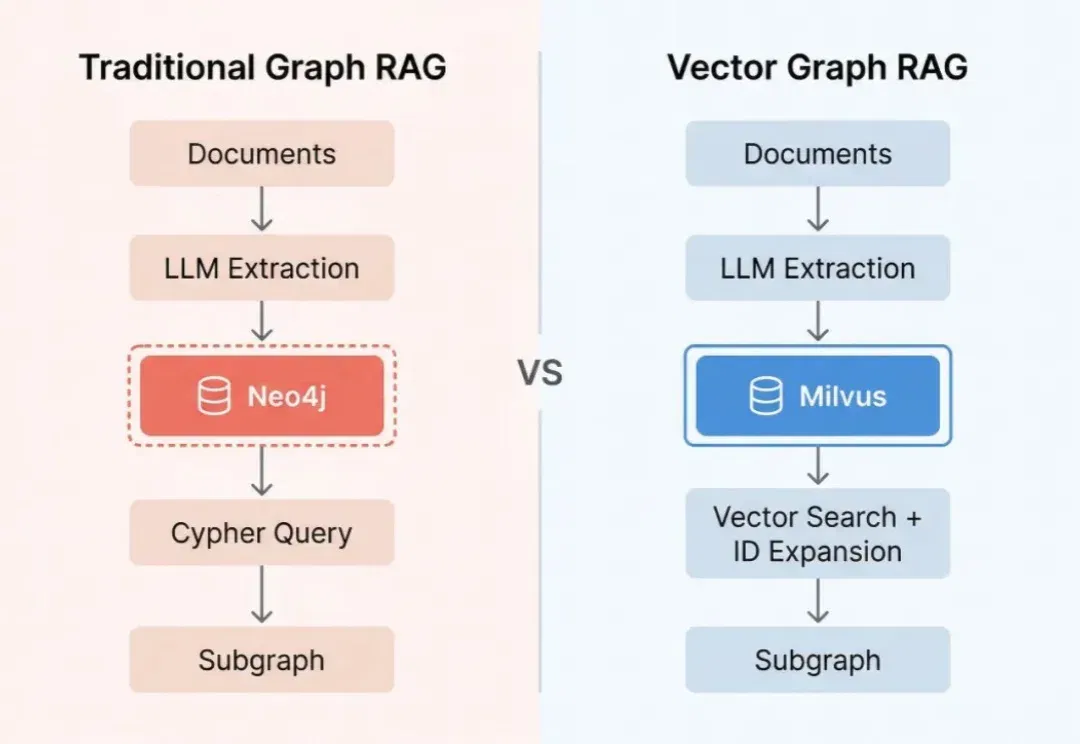
Zilliz 在 Vector Graph RAG 中先用 Jev 筛选关系,再重排关联的原文片段。在 MuSiQue 和 2Wiki 共 2,000 题的对比中,Jev 1.14 两阶段方案的平均 Recall@5 为 86.61%。
RSI 论文共同牵头作者解释,一年半十倍提速建立在完全自动化和既有回报率等假设之上。访谈还讨论研究选题能力、算力与反馈限制,以及用 AI 辅助监督的研究。
报道整理奥特曼访谈中关于超级智能控制权、研发速度及权力集中的讨论,并回顾模型监测与人类复核机制。软件任务时长、IQ测验和科学验证是不同尺度,不能直接换算智力差距,也不能据此确认完全自主RSI已经实现。
无涯智远创始人张牧涵在访谈中介绍参数内学习:先训练超网络,再以前向传播生成基座更新,探索把新经历持久写入参数。受访者也谈到长期稳定性、遗忘及大规模写入仍待研究;秒级写入不等于超网络训练没有成本。
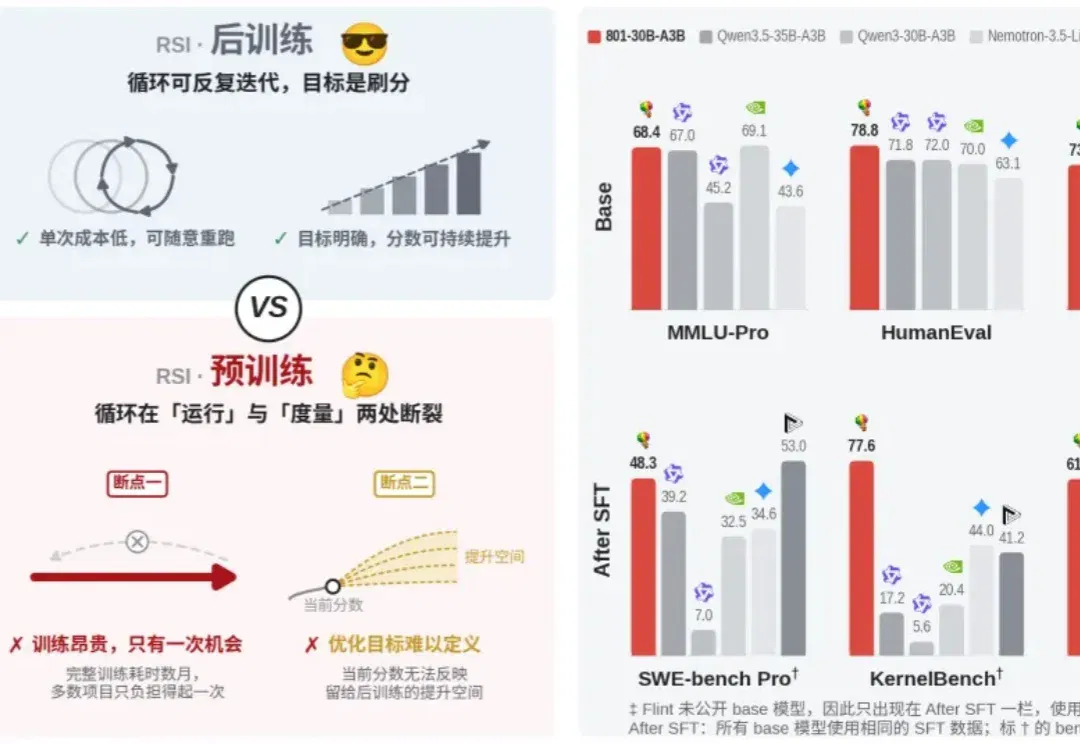
上海创智学院与新序智能发布801-30B基座、技术报告及轻量SFT数据,介绍通过调试、潜力评估和共享经验改进预训练流程。报告分别比较base、同数据微调及完整后训练模型;全球仅两家等表述属于团队观察范围。
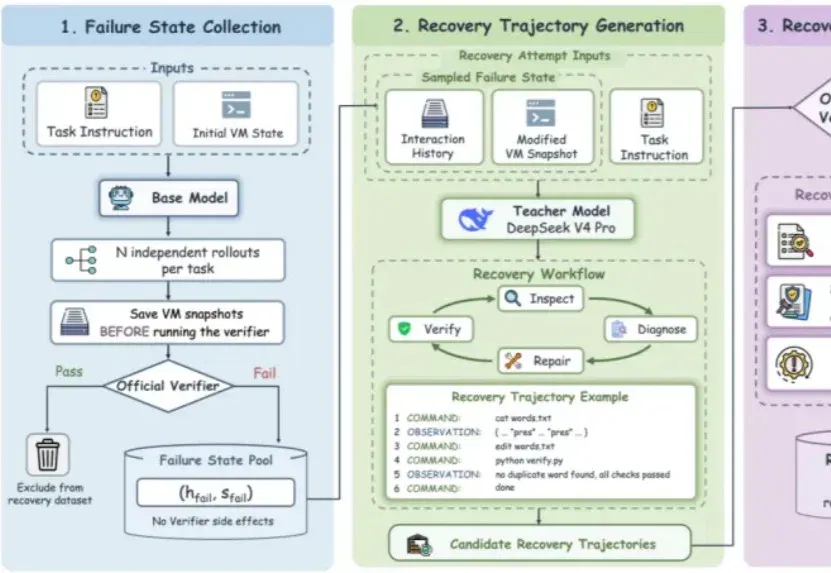
ReTerm 让终端智能体保留自身失败后的环境,尝试多种恢复办法,再用验证结果训练策略。研究发布约万条恢复轨迹,并报告9B模型在终端与软件工程基准上的提升;多数错误类别的恢复率仍不高,改进有明确边界。
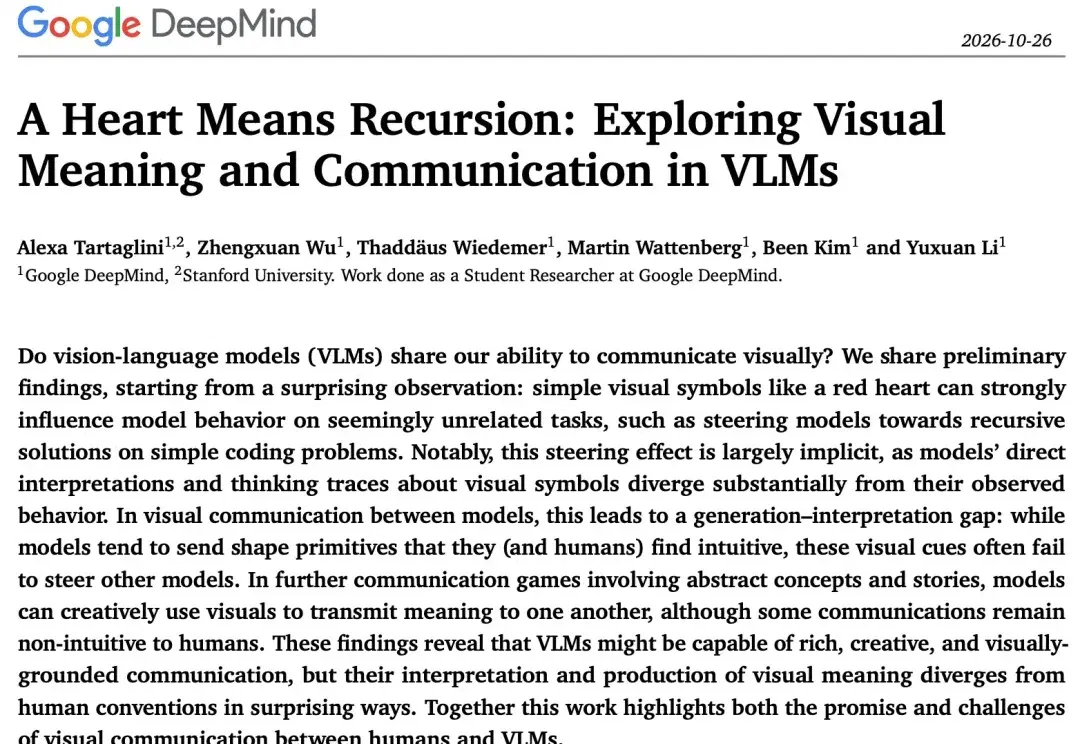
A Heart Means Recursion 研究发现,部分颜色与形状组合会影响受测模型选择递归等代码策略,而模型给出的解释未必承认这种影响。文章讨论截图型智能体的视觉干扰与行为对照测试,结论仍受模型、任务和实验样本限制。
科理新序创始人张载熙讨论 scientific token、科学基座模型与干湿实验闭环。他分享STELLA靶点候选和蛋白设计案例,也强调计算结果与湿实验间的差距。SSI是团队设定的后续目标,自动化实验室及更大模型能力仍在规划和验证。
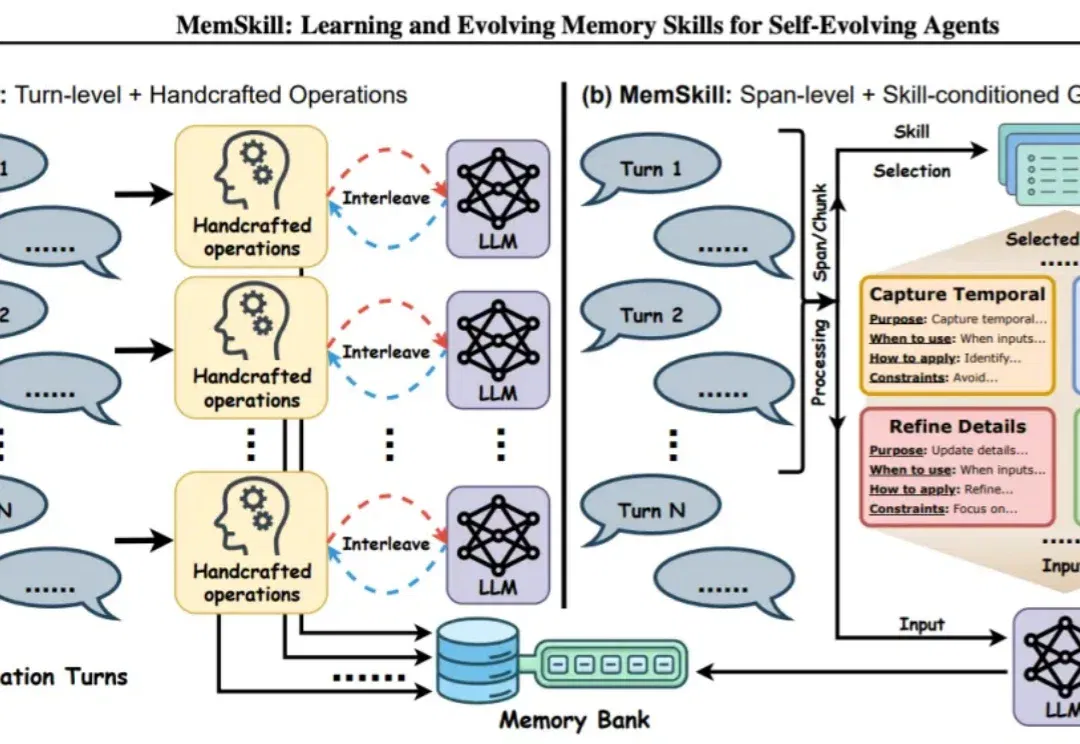
MemSkill 将智能体记忆操作封装为可复用的技能,由 Controller 学习选择,Executor 构建记忆,Designer 根据失败案例改进技能库。论文在长期对话、具身任务和迁移问答中评估表现;持续利用真实用户反馈适配偏好仍是后续研究方向。