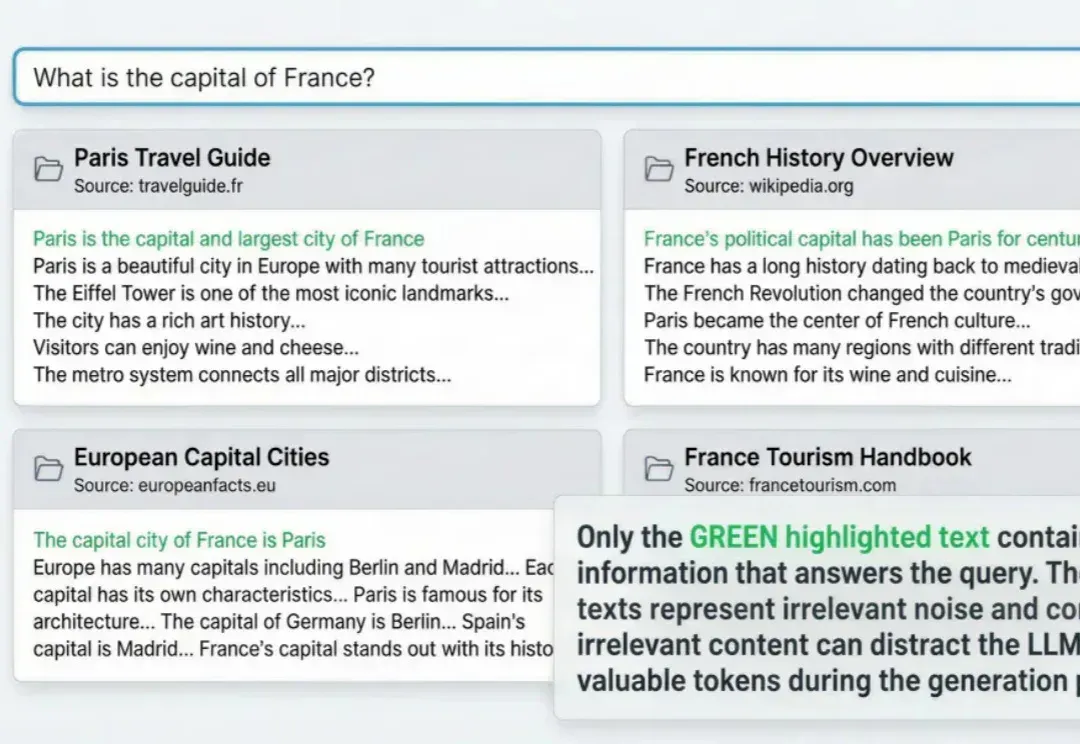
官宣,Milvus开源语义高亮模型:告别饱和检索,帮RAG、agent剪枝80%上下文(在新窗口打开)
RAG与agent用到深水区,一定会遇到这个问题: 明明架构很完美,私有数据也做了接入,但项目上线三天,不但token账单爆了,模型输出结果也似乎总差点意思。
共 619 篇
RAG与agent用到深水区,一定会遇到这个问题: 明明架构很完美,私有数据也做了接入,但项目上线三天,不但token账单爆了,模型输出结果也似乎总差点意思。
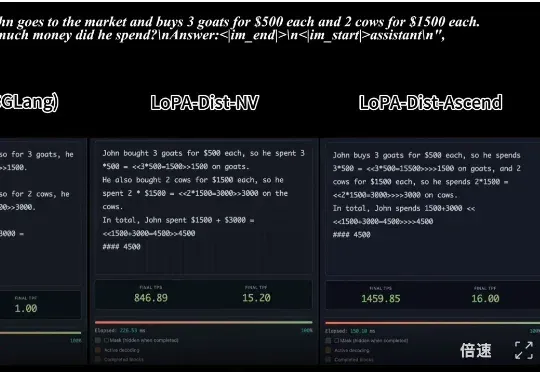
,时长 00:20 视频 1:单样例推理速度对比:SGLang 部署的 Qwen3-8B (NVIDIA) vs. LoPA-Dist 部署 (NVIDIA & Ascend)(注:NVIDIA 平台
Metronome成立于2019年的旧金山,专注于为AI与软件公司提供实时计费基础设施,解决从传统按Seat收费转向按用量、Token等复杂定价的工程难题。目前其融资总额达1.28亿美元,已服务OpenAI、NVIDIA、Databricks等头部企业,终端用户超1.5亿,成为AI时代“按价值收费”的关键基础设施。
一直以来,传统 MAS 依赖自然语言沟通,各个 LLM 之间用文本交流思路。这种方法虽然可解释,但冗长、低效、信息易丢失。LatentMAS 则让智能体直接交换内部的隐藏层表示与 KV-cache 工作记忆,做到了:
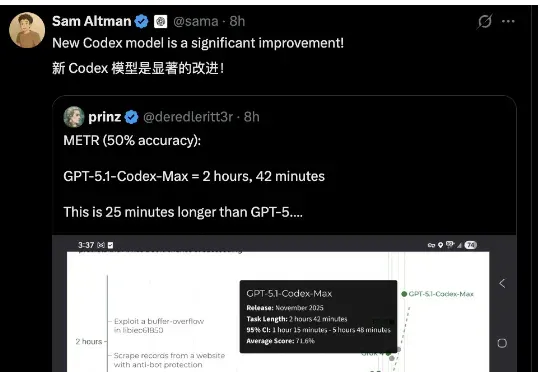
Gemini 3力压全场,OpenAI坐不住了。发布Codex新版本——GPT-5.1-Codex-Max,突破上下文窗口限制,实现跨越数百万token的长时间连续工作,最长超过24小时的那种。
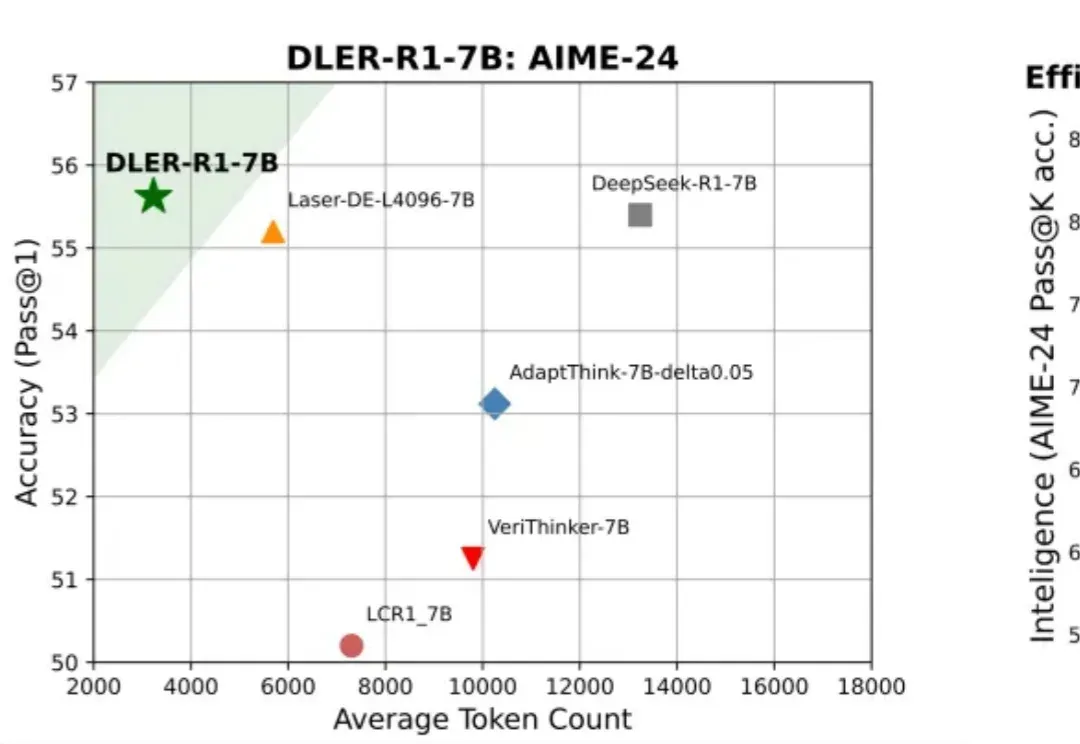
大模型推理到底要不要「长篇大论」?过去一年,OpenAI o 系列、DeepSeek-R1、Qwen 等一系列推理模型,把「长链思维」玩到极致:答案更准了,但代价是推理链越来越长、Token 消耗爆炸、响应速度骤降。
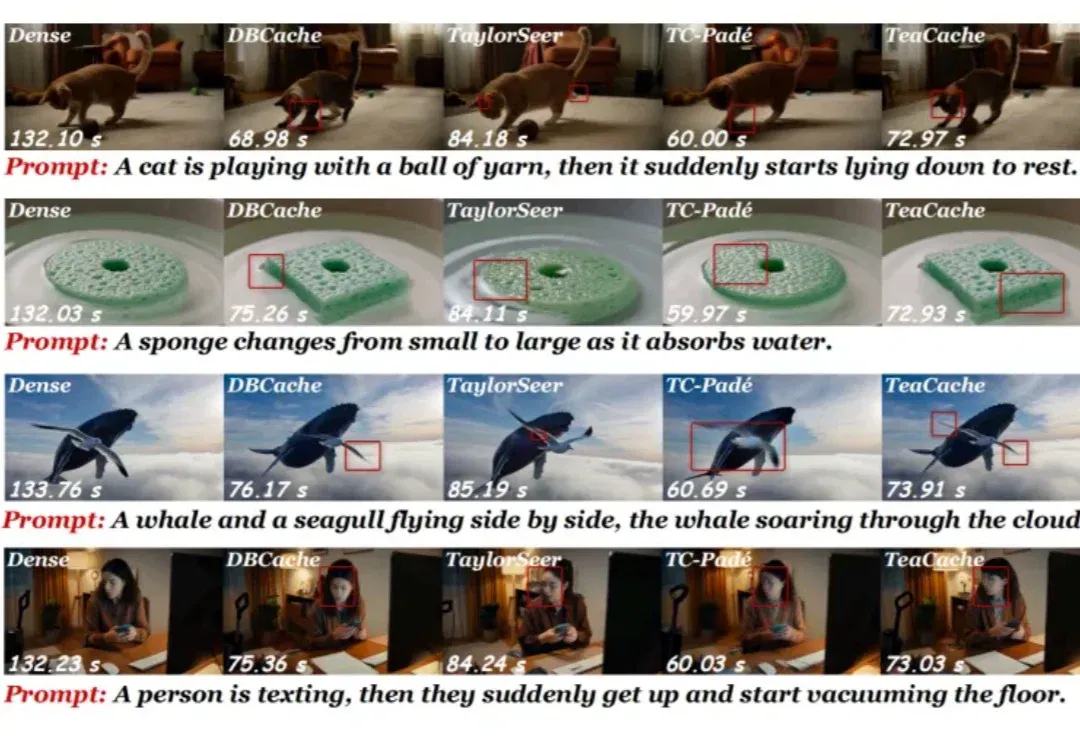
公司在发布测试中报告视频推理相对Dense平均2.48倍加速,并介绍显存调度、素材理解和生成上下文衔接方案。
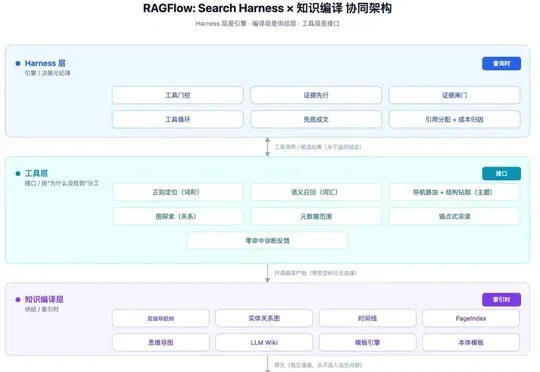
文章拆解 RAGFlow 的证据链、导航、引用和有状态检索流程,说明哪些证据可以预先加工、哪些仍需查询原文。相关 Token 节省来自报告所用测试。
科理新序创始人张载熙讨论 scientific token、科学基座模型与干湿实验闭环。他分享STELLA靶点候选和蛋白设计案例,也强调计算结果与湿实验间的差距。SSI是团队设定的后续目标,自动化实验室及更大模型能力仍在规划和验证。
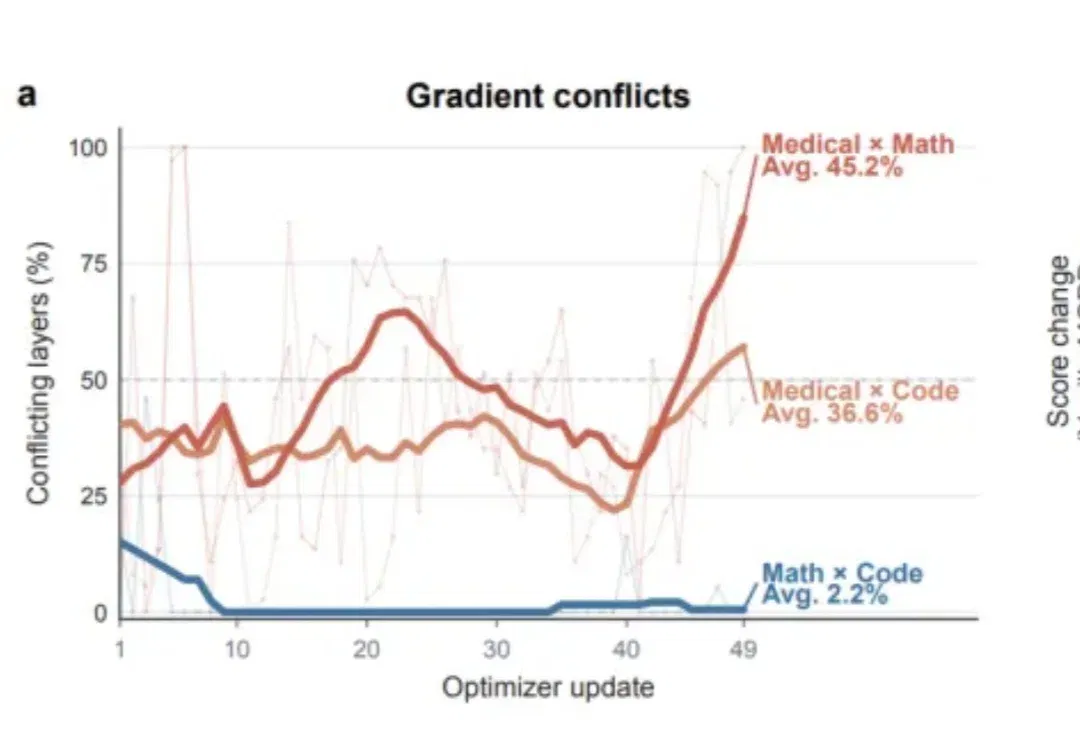
京东与南京大学提出 Road MOPD,在学生的同一份回答上收集多教师反馈,先调整 token 级监督,再削减冲突梯度并保留学习力度。Qwen3-4B 的数学、代码与医学文本基准显示联合训练收益;较小模型的部分领域仍有取舍。