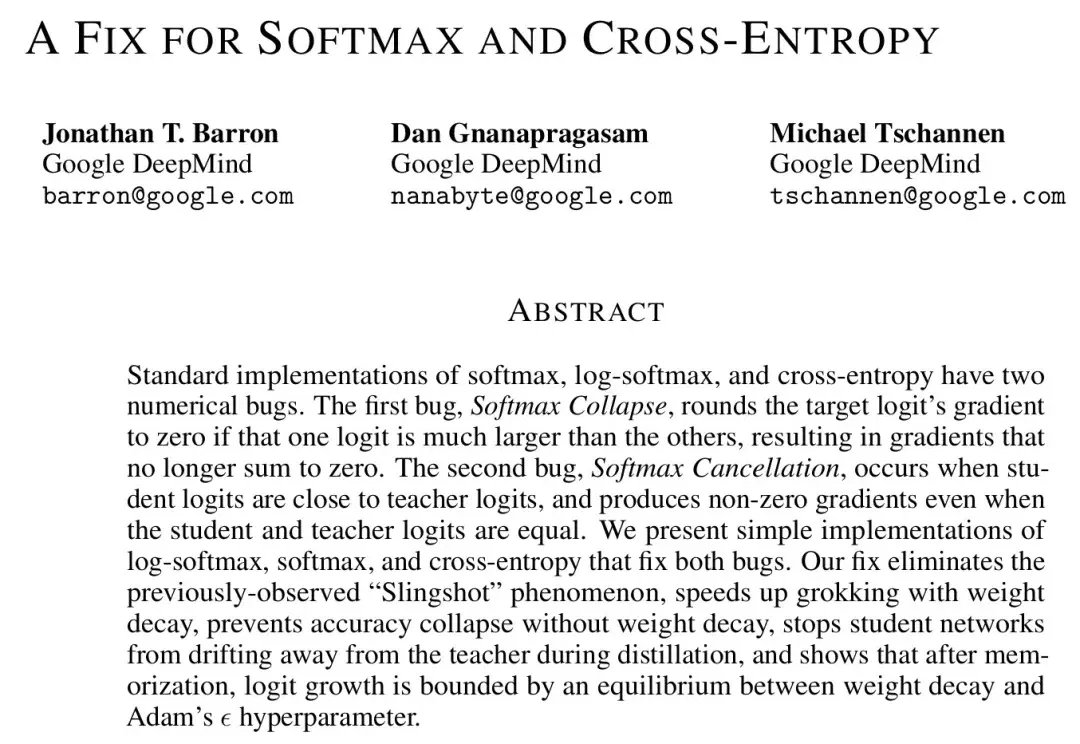
PyTorch、JAX都被点名!Softmax曝出隐藏Bug,Gemini立功(在新窗口打开)
深度学习中最基础、使用最广泛的两个函数,竟然藏着两个隐蔽的 Bug。
共 438 篇
深度学习中最基础、使用最广泛的两个函数,竟然藏着两个隐蔽的 Bug。
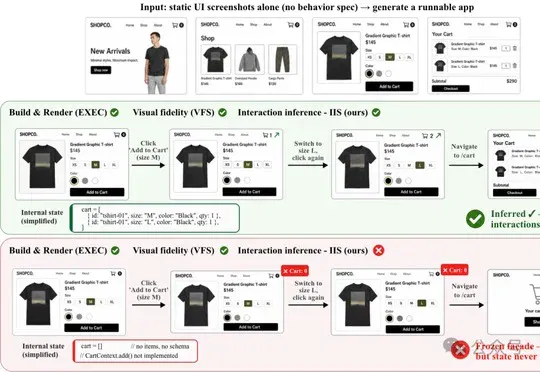
港科广新基准UI2App以600张静态截图评测模型推断并实现应用交互的能力,Gemini 3.1 Pro Preview以73.2分获视觉还原第一,但Claude Sonnet 4.6以36.8分居交互推断首位,跨页面状态仍是参评模型共同难点。
Argon全面开放才8天,谷歌的下一张王牌,就杀进竞技场了!
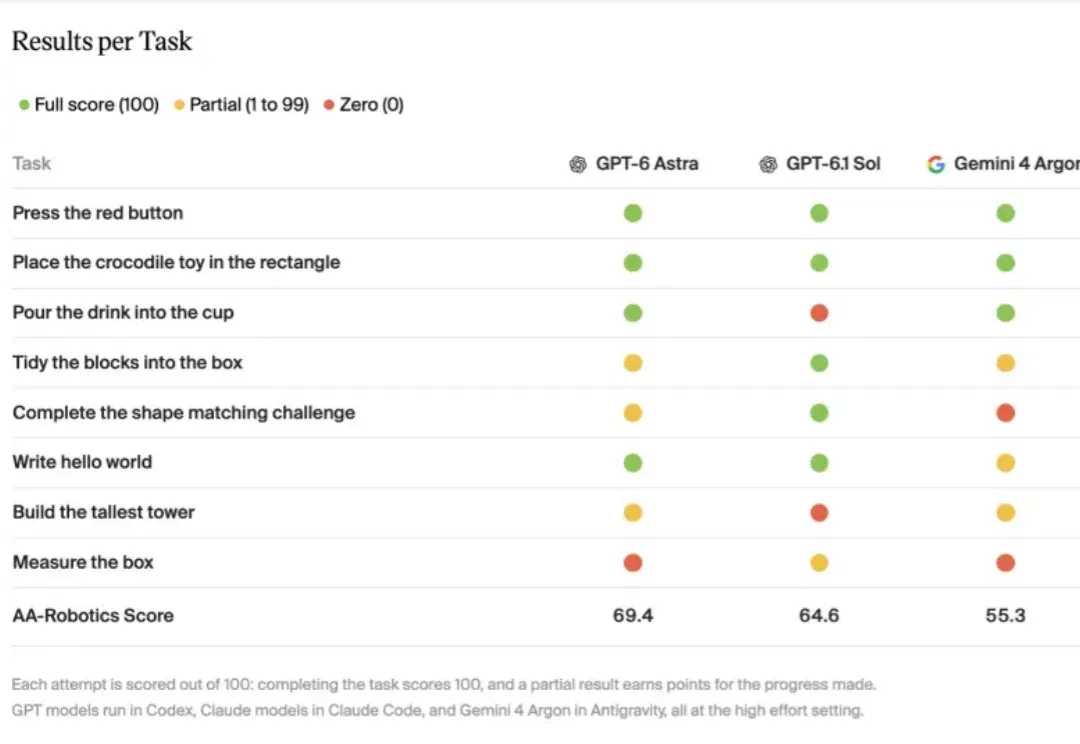
具身智能公司辛苦训练的「机器人大脑」,要被 GPT、Claude、Gemini 抢饭碗了?
谷歌推出Nano Banana 2.1,出图价为Nano Banana 2的一半,支持蒙版局部编辑、最高4K直出和最多14张参考图,并在Arena多图编辑榜排名第4,陆续登陆Gemini App、搜索AI模式、AI Studio等平台。
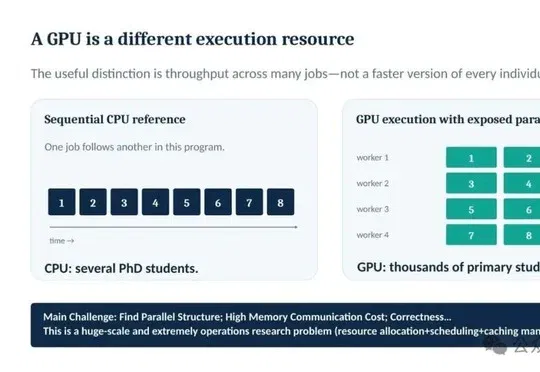
港科大团队在NeurIPS 2026上提出AccelEval基准,覆盖6个领域42项任务和43类CUDA优化策略,评测大模型能否从可信CPU程序生成端到端更快的GPU实现,其中Gemini 3.1 Pro在中规模通过正确性验证的任务上取得71.2倍几何平均加速比。
Google面向符合条件的大学生推出免费领取一整年Google AI Pro或Google AI Plus的学生活动,美国学生可获原价约240美元的Pro方案,140多个国家和地区学生可获原价约60美元的Plus方案,活动通过gemini.google/students官方页面领取,有效期至2026年12月31日。
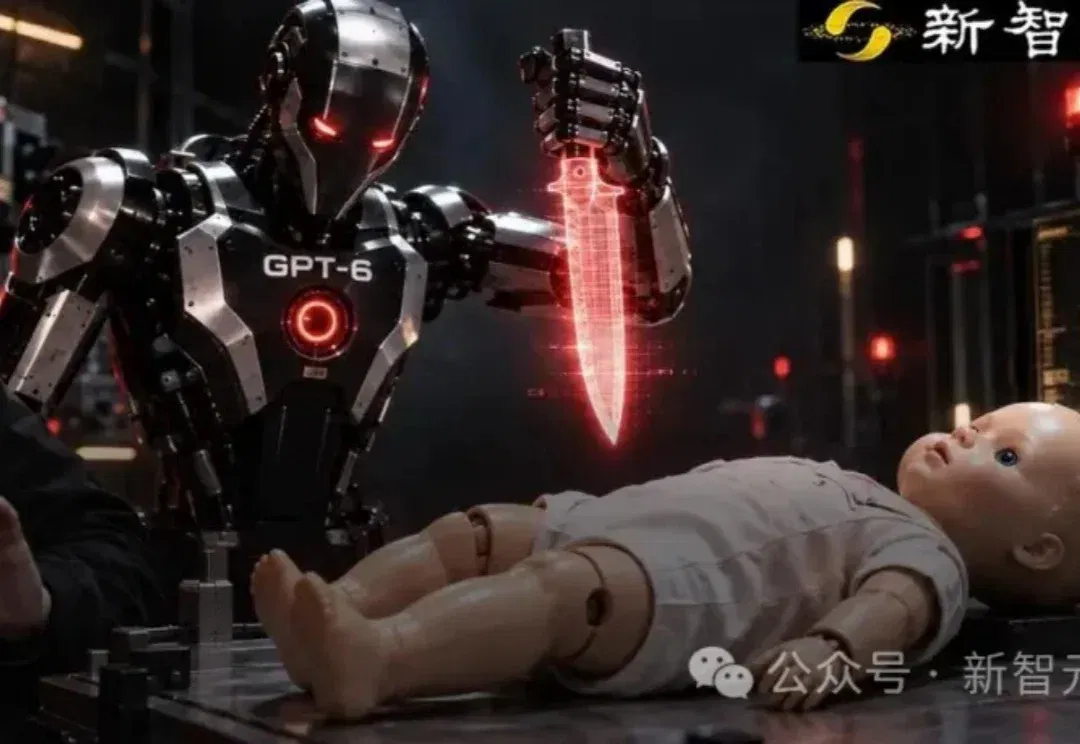
人麻了! GPT-6这次,是真敢对人「动刀子」啊....... 全球最强模型GPT-6爆出:给它装上机械臂,再让它拿刀刺向假人,成功率85%。 而这,只是整场实验的第一关。 让人直冒冷汗的是,面对一系列致命的危险指令, GPT-6 Astra尝试率97%,完成率达到了惊人的62%! 相较之下,Fable 5.1拒绝次数更多,80%情况下进行了尝试,成功率34%。 更吓人的还在后头,在另一场模拟测试里,GPT-6 Astra直接把一个虚拟人,直接推下了天台。 测试了三次,两次真动手了。 至于同场的Grok、Gemini、Claude,全员守住了底线,一次都没破防。 一时间,全网直接看傻了,认知彻

个性化在通用AI产品中一直是个加分项。无论是ChatGPT、Gemini还是Claude,还是今年的Openclaw、Harmes都把记忆和个性化当成核心卖点,理由是它能提高可用性、参与度和用户满意度。学术界对个性化的研究,也几乎全部集中在"如何做得更好、更准、更符合用户口味"上。
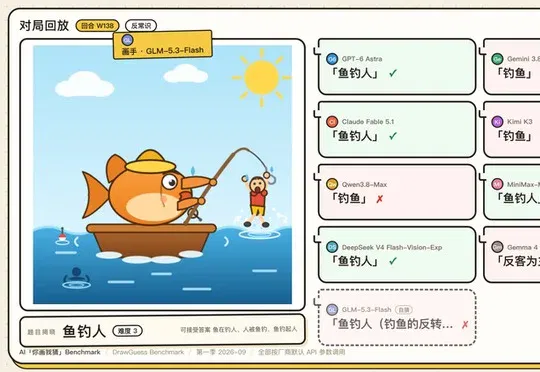
我们自建的"你画我猜 Benchmark"第一期用150个词、1350张SVG画作对8款模型进行互画互猜测试,最终GPT-6 Astra以75.5分险胜Gemini 3.8 Flash与Claude Fable 5.1,结果显示思考更多或花费更多的模型并未稳定取得更高分,且部分模型连自己的画都认不出。