内存直降50%,token需求少56%!用视觉方式处理长文本(在新窗口打开)
在NeurIPS 2025论文中,来自「南京理工大学、中南大学、南京林业大学」的研究团队提出了一个极具突破性的框架——VIST(Vision-centric Token Compression in LLM),为大语言模型的长文本高效推理提供了全新的「视觉解决方案」。值得注意的是,这一思路与近期引起广泛关注的DeepSeek-OCR的核心理念不谋而合。
共 530 篇
在NeurIPS 2025论文中,来自「南京理工大学、中南大学、南京林业大学」的研究团队提出了一个极具突破性的框架——VIST(Vision-centric Token Compression in LLM),为大语言模型的长文本高效推理提供了全新的「视觉解决方案」。值得注意的是,这一思路与近期引起广泛关注的DeepSeek-OCR的核心理念不谋而合。
这世上有太多 AI benchmark 了,但没有一个 benchmark 能让你心跳加速。 直到近日,AlphaArena 出现了。 这是由初创团队 NOF1 推出的一个「AI 炒币实盘竞技场」,现在已开放全网围观:竞技场地址:https://nof1.ai/
Claude,竟然排在最后? PhAI Labs 最新公布了一项 AI 研究能力对照,结合后续发表的科学文献,考察不同模型提出的研究假设能否为未来的研究思路与探索方向提供启发。报告所列的 Claude Opus 5 组对应比例为 2.3%,排在图中五个模型组的末位。GPT 组为 2.5%,GLM 为 2.8%,DeepSeek 为 5.4%。 排在最前面的,是 DiscoveryRSI:6.3%,约为 GPT 组的 2.5 倍、Claude 组的 2.7 倍。 图 1|五个模型组对未来研究的启发:DiscoveryRSI 总体比例为 6.3%。 这项比较观察的是:AI 提出的研究假设,能否在后
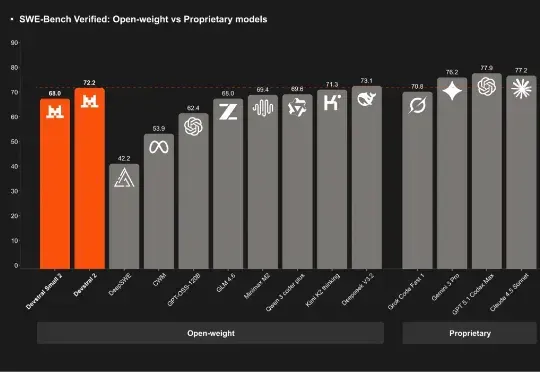
刚刚,「欧洲的 DeepSeek」Mistral AI 再次开源,发布了其下一代代码模型系列:Devstral 2。该系列开源模型包含两个尺寸:Devstral 2 (123B) 和 Devstral Small 2 (24B)。用户目前也可通过官方的 API 免费使用它们。
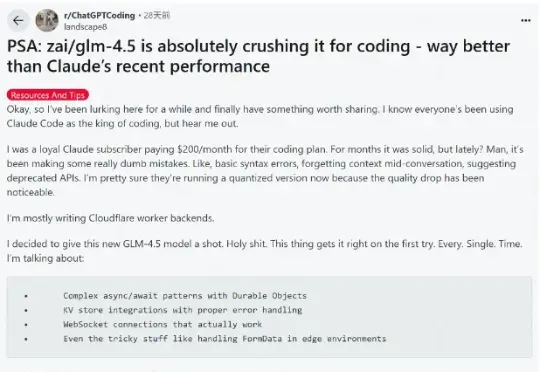
这段时间 AI 编程的热度完全没退,一个原因是国内接连推出开源了不少针对编程优化的大模型,主打长上下文、Agent 智能体、工具调用,几乎成了标配,成了 Claude Code 的国产替代,比如 GLM-4.5、DeepSeek V3.1、Kimi K2。
可能是全球首家「AI 原生金融组织」。 如果梁文锋掌管的幻方量化,没有去做大模型,而是去做了投资,会有怎样的结果? 这是个很有意思的问题,华尔街一家量化交易公司 Jane Street,不仅净收益高达 396 亿美元,而且在几年前就持有 Anthropic 的大量股权,现在已经爆赚 50 倍。 当 a16z 通过变身 KOL,喊出了投资机构转型媒体的新变革时,Jane Street 则通过押注 AI 模型和 AI 基建,探索成为「AI 原生金融组织」的新形态。 01All in AI Jane Street 是华尔街一家有点神秘的量化交易公司,以数学天才密度高、薪酬离谱、低调到几乎不做公关著称
深朴智能24岁首席科学家王家伟在播客对话中回顾了从中科大少年班、MSRA、DeepSeek到字节Seed的经历,阐述放弃大模型舒适区转向具身智能创业的原因,认为具身系统既需要通用大模型承担理解与规划,也需要能毫秒级快速反应的动作模型,并介绍了深朴智能在开源HiFi-UMI数据集、自研高精度UMI手套及构建Agentic OS方面的全栈研发进展。
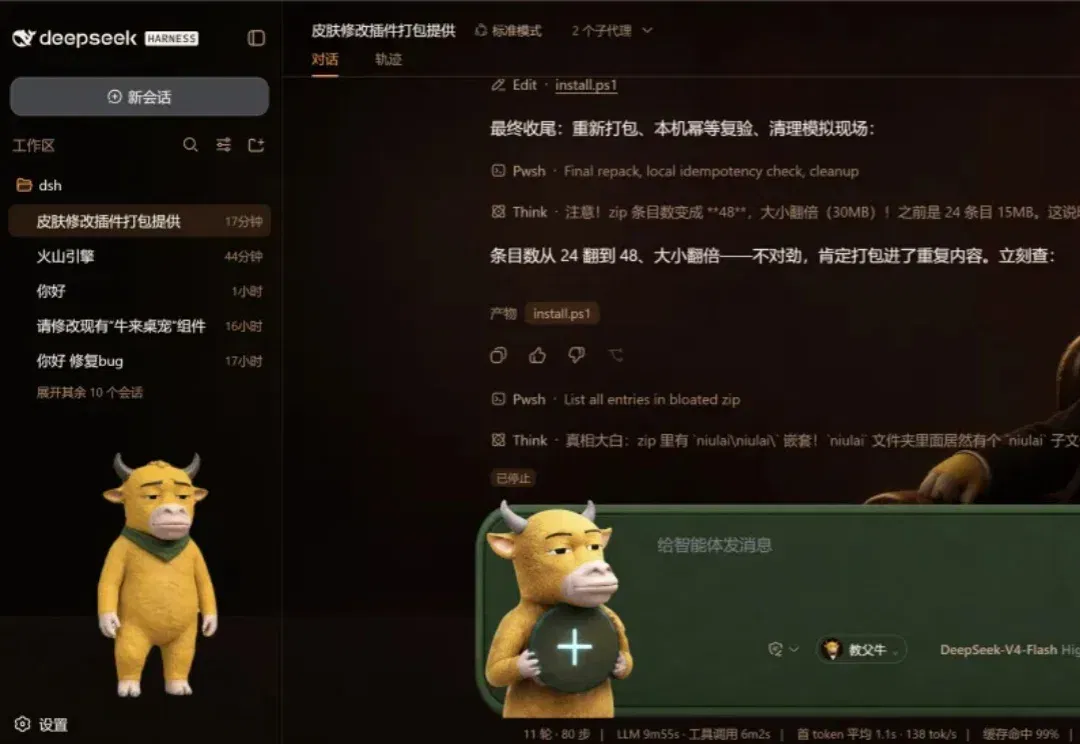
上两天肝的视频上了热搜 + 热门,使用插件,针对 ds 模型可以提升不小的性能。
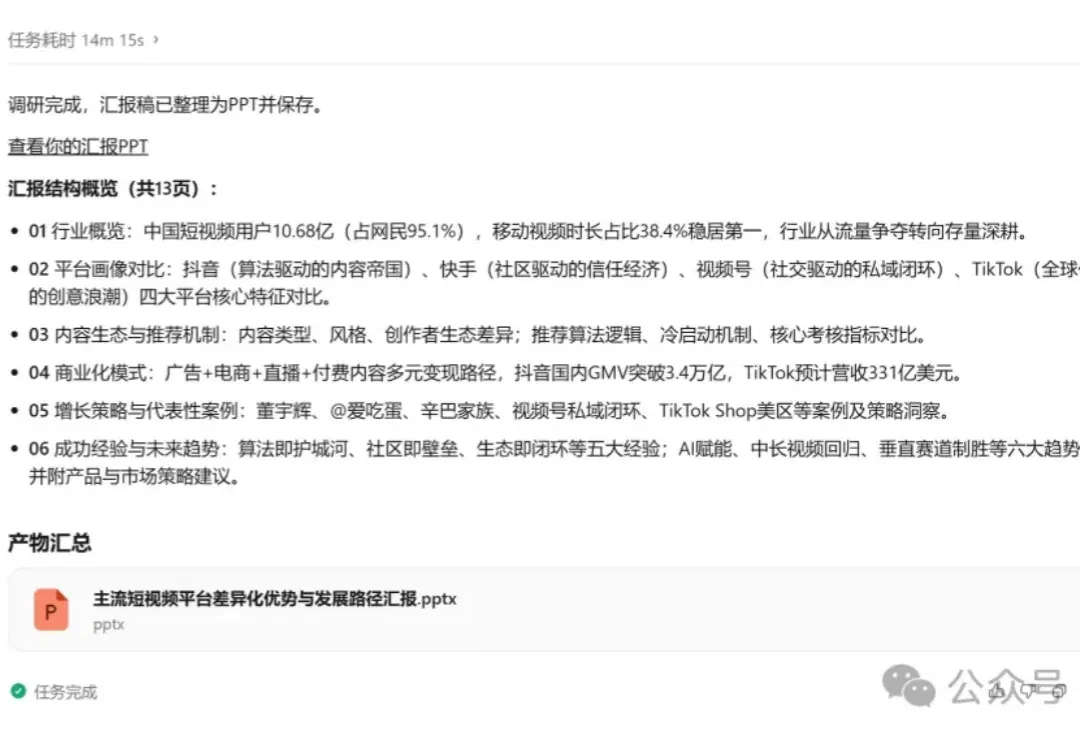
最近这段时间,国内外模型更新得很快。 如果只看发布会和榜单,大家都会觉得每个模型都很强。参数更大、上下文更长、推理更强、价格更低,听起来都挺猛。 但真正用到工作流里,会发现另一件事:模型强不强,不只看它会不会回答问题,还要看它能不能把一个任务完整跑完。 尤其是 Agent 场景。 一个复合任务需要大模型去调用多个工具,比如让模型做一份 PPT,它并不是简单写几页文字。中间要先理解需求,再去搜索资料,阅读网页,提取关键信息,整理成汇报结构,必要时还要生成代码或调用插件,最后产出一个可以正常使用的PPT文件。 下面测试两个Agent任务,使用同样的提示词,相同的Agent工具-Trae Work。
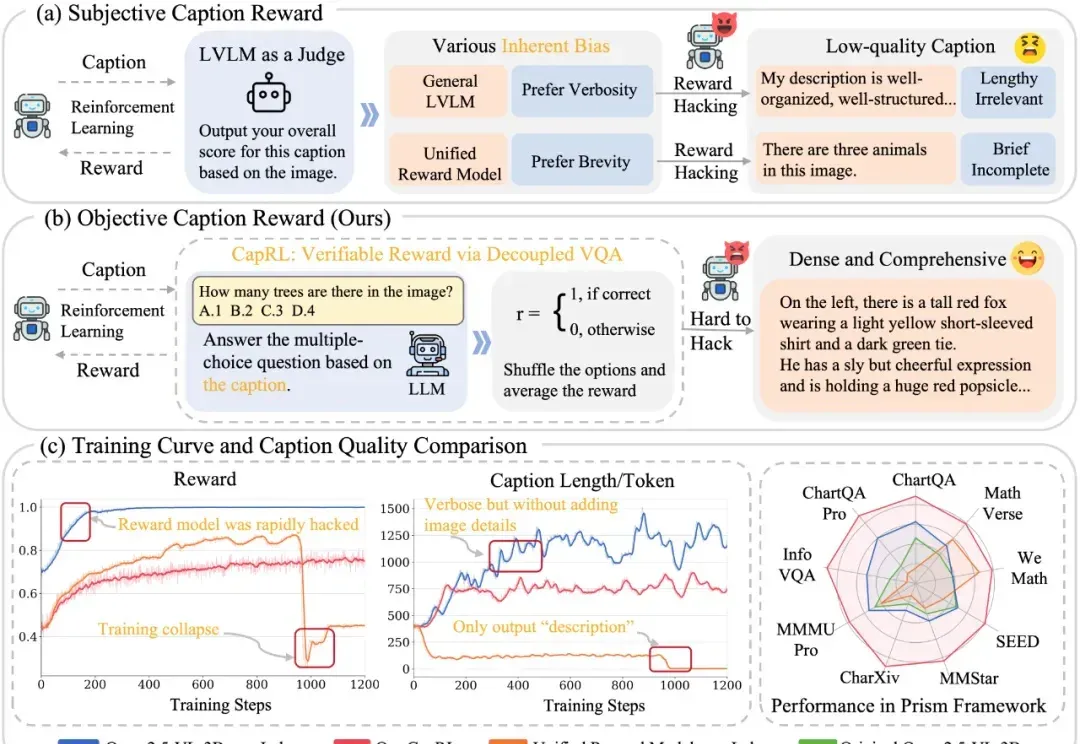
今天推荐一个 Dense Image Captioning 的最新技术 —— CapRL (Captioning Reinforcement Learning)。CapRL 首次成功将 DeepSeek-R1 的强化学习方法应用到 image captioning 这种开放视觉任务,创新的以实用性重新定义 image captioning 的 reward。