将 600 亿参数大模型装进手机的瓶颈,终于被中国 AI 公司突破了(在新窗口打开)
一个 8B 参数的大模型,通常需要约 16GB 显存。参数越多,越吃显存,这就是为什么,内存价格一天比一天高。
共 1517 篇
一个 8B 参数的大模型,通常需要约 16GB 显存。参数越多,越吃显存,这就是为什么,内存价格一天比一天高。
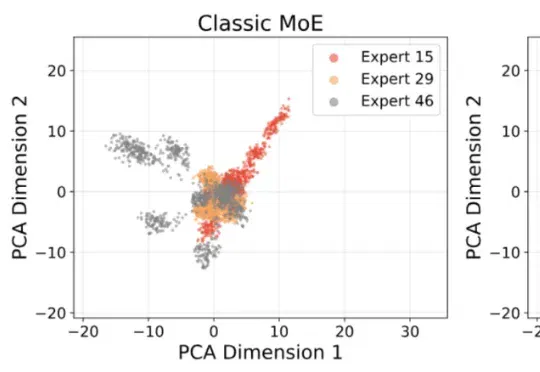
近年来,Mixture-of-Experts(MoE)已经成为大模型扩展的重要架构之一。相比稠密 Transformer,MoE 通过稀疏激活机制,在每个 token 上只调用少量专家,从而在控制计算成本的同时扩大模型容量。然而,一个长期存在的问题是:专家越多,并不意味着专家真的学得越 “专”。
刚刚,Cohere放出2180亿参数的MoE大模型Command A+,单张B200可跑,支持48种语言,还带原生引用能力。但这次发布最炸的,不在参数表上,而在那一个许可证:Apache 2.0。
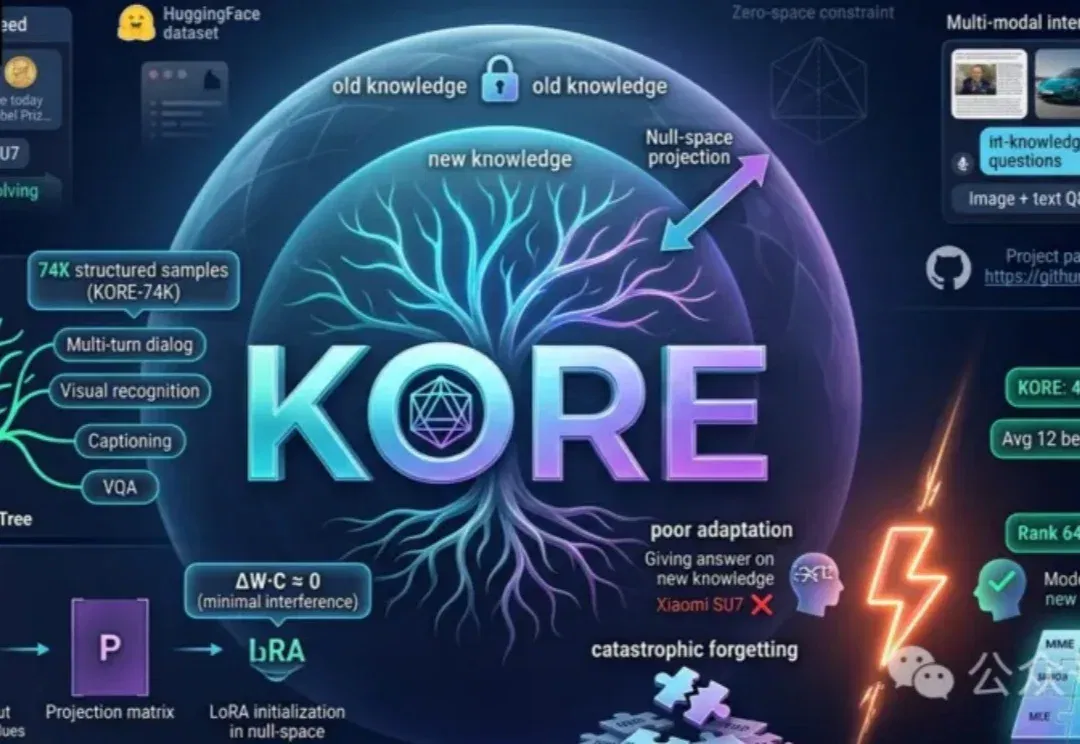
中科大团队首先推出动态多模态知识注入基准MMEVOKE,解构遗忘机制,并在此基础上提出全新双阶段框架KORE。通过「知识树」自动增强与「零空间」协方差约束微调,为大模型终身学习开辟了全新路径。
数据标注正成为一项更有技术含量的工作。 在公众的传统认知里,AI数据标注始终带着某种“数字流水线”的色彩。 它通常意味着坐在电脑前,重复处理着图片、语音或文本,比如给自动驾驶图像逐一框出行人与车辆,为语音系统一句句校对字幕,或者按照既定规则为数据打上标签。其低门槛、低薪资、机械性的特质,堪比AI时代的“电子厂”。 但当大模型浪潮席卷AI行业之后,数据标注行业开始出现一种出人意料的变化。虽然传统数据标注工作仍有庞大需求,但越来越多AI企业,尤其是头部大模型厂商,正在寻找一种更有技术含量的新型标注员。 如今,阿里、字节、DeepSeek、MiniMax等企业的一些相关岗位,不再冠以“数据标注”的名
最近几天,中国电信、中国移动、中国联通接连推出Token套餐及相关AI服务,面向个人、家庭、开发者、中小微企业等用户销售大模型调用量。这是三大运营商首次正式入局Token生意,而此前相关业务由大模型厂商、互联网大厂和云服务商主导。
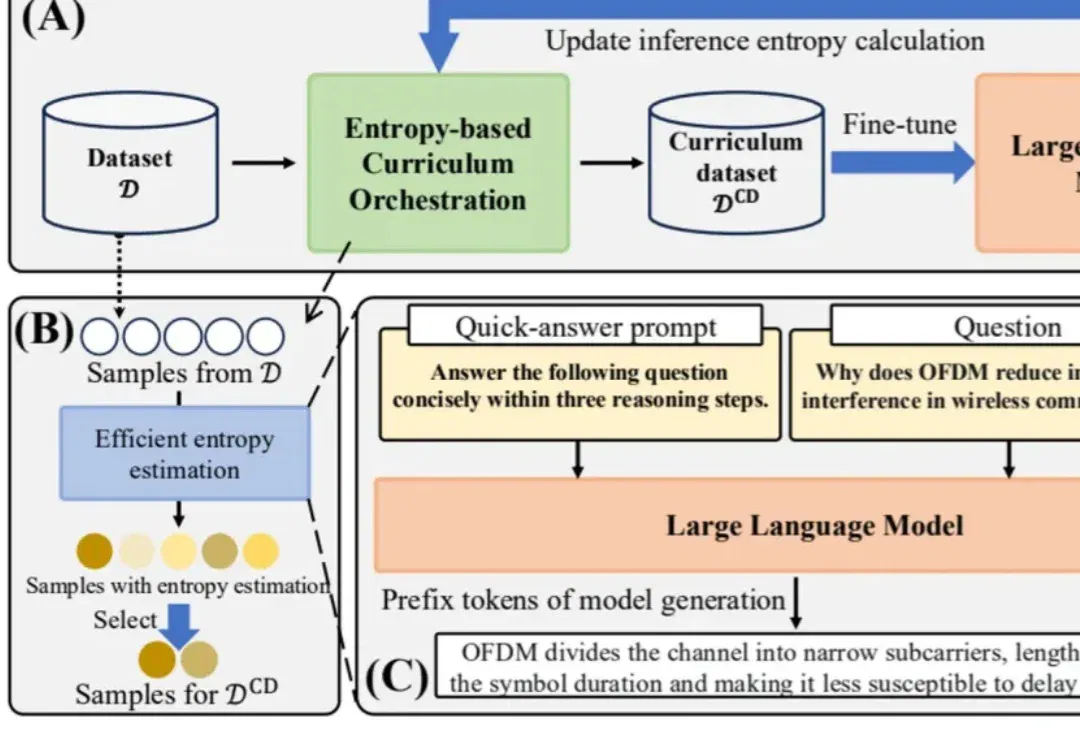
在大模型后训练中,数据不再只是 “越多越好”,而是要像人类学习一样,动态选择最合适难度的样本。华为提出的 EDCO 方法,将样本难度估计与动态课程编排引入领域大模型微调;数月后,由 Rutgers、Amazon、Google 等作者参与的 DARE 论文即引用 EDCO,并将其作为难度感知强化学习训练的重要对比基线。
5月15日,米哈游在北京举办了一场AI基础大模型相关的技术分享会与顶尖校招生招募活动,米哈游创始人刘伟在此次招聘会上分享了部分他对AI业务的看法和愿景。
原力灵机释放商业化信号。 AI科技评论独家获悉,原智谱 AI 副总裁陈雪松已正式加盟具身智能公司原力灵机(Dexmal),或将继续负责企业、公共业务(To B)。此次加盟,也成为原力灵机加码商业化布局的重要信号。 陈雪松的履历几乎完整覆盖了过去十年中国 AI 商业化的三个关键周期:早年任职旷视科技,担任高级副总裁、城市业务负责人,主导智慧城市与政务行业方案落地;其后加入阿里云任副总裁,负责数字政府业务;此后加入智谱 AI,以副总裁身份推动大模型在大型企业、政务场景的规模化应用。从 AI 视觉、云计算到大模型,他三度参与了 To G 商业化从零到规模化的完整过程。 原力灵机成立于 2025 年
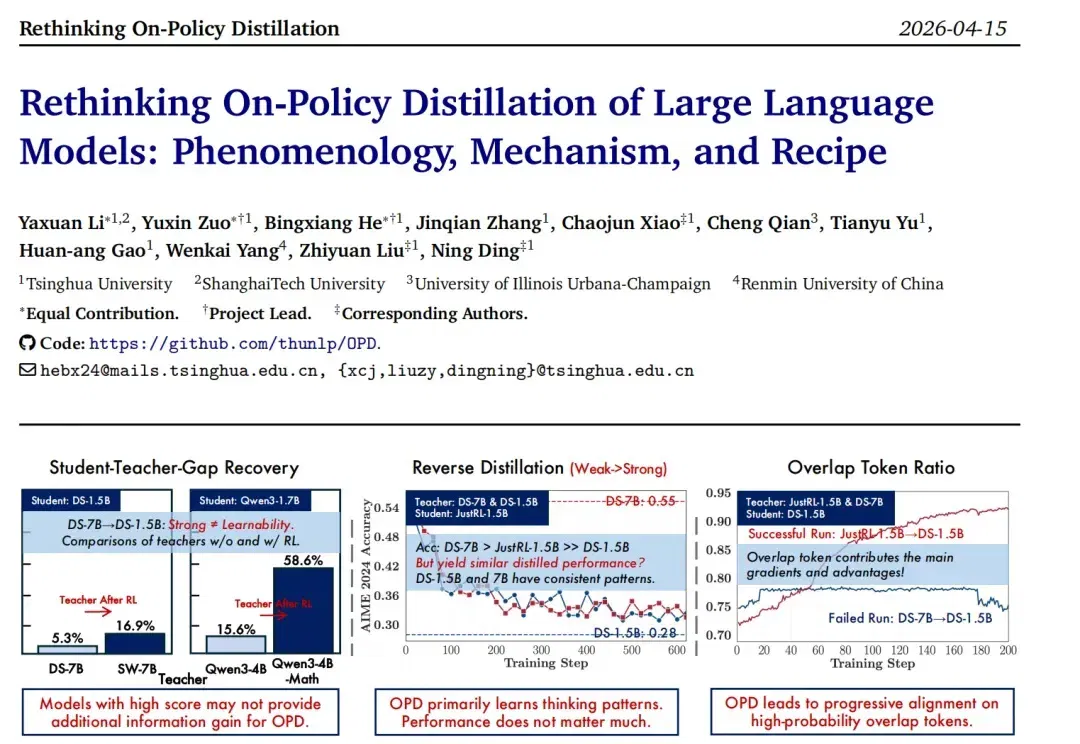
当下的大模型后训练(Post-training)pipeline 中,On-Policy Distillation(OPD)已经成为了明星技术。从 Qwen3、MiMo 到 GLM-5,业界纷纷采用 OPD 并报告了巨大的性能提升。相比于强化学习(RL)稀疏的结果奖励,OPD 提供了密集的 Token 级别监督信号,看起来就像是一顿「免费的午餐」。