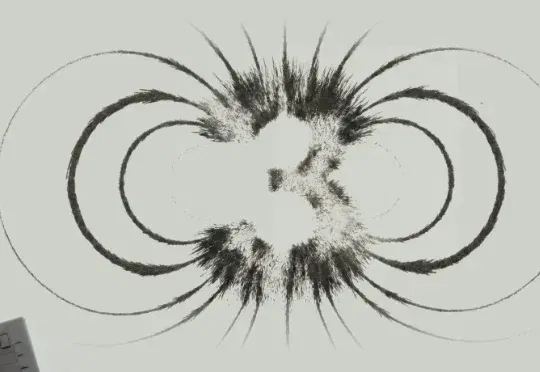
Kimi K3:智能的新前沿(在新窗口打开)
Kimi K3 是一个 2.8 万亿参数模型,基于 KDA 混合线性注意力机制(Kimi Delta Attention)和注意力残差(Attention Residuals)技术构建,原生支持视觉理解,并拥有 100 万 token 上下文窗口。它是全球首个开源的 3 万亿级别模型,面向长程编程、知识工作和推理等前沿智能场景而设计。
共 619 篇
Kimi K3 是一个 2.8 万亿参数模型,基于 KDA 混合线性注意力机制(Kimi Delta Attention)和注意力残差(Attention Residuals)技术构建,原生支持视觉理解,并拥有 100 万 token 上下文窗口。它是全球首个开源的 3 万亿级别模型,面向长程编程、知识工作和推理等前沿智能场景而设计。
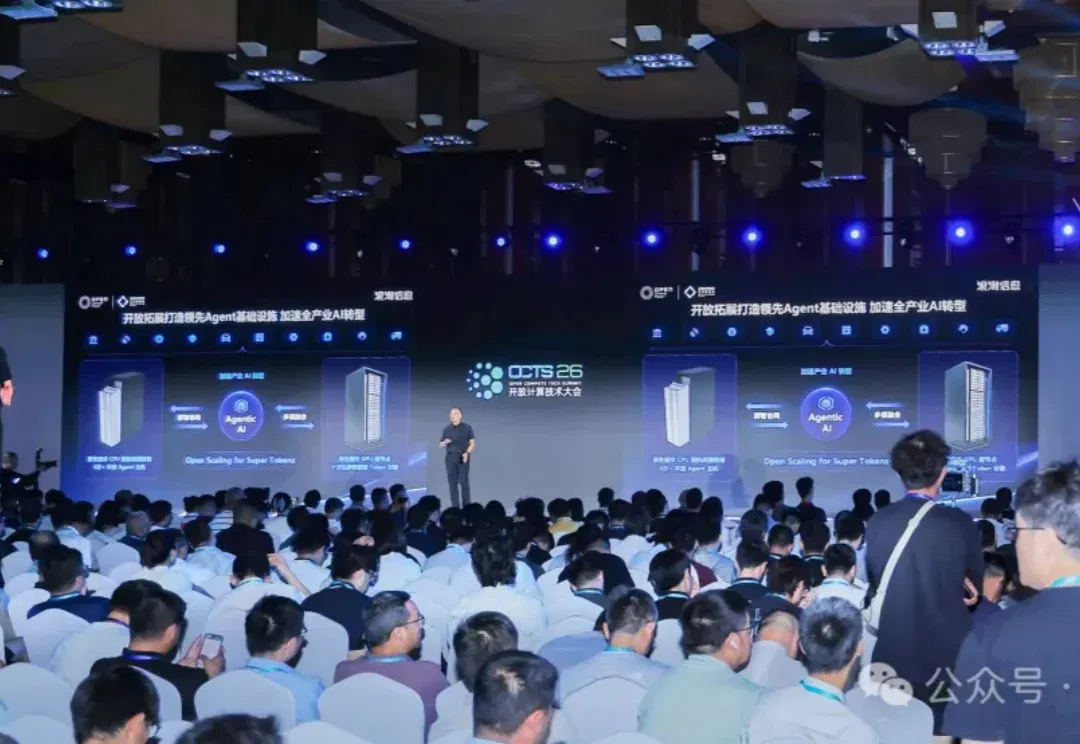
AI基础设施的核心任务,已经从支撑大模型推理,转向支撑海量智能体的规模化运行与高质量Token的持续生产。
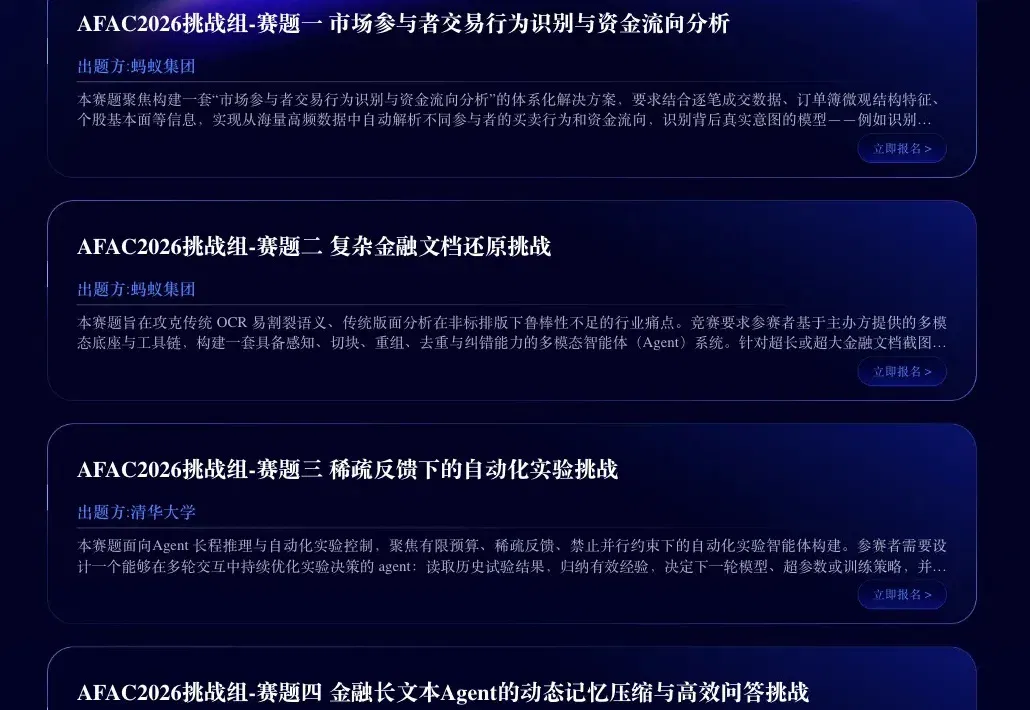
好久没看到这么神清气爽的AI比赛了。 名为AFAC2026金融智能创新大赛,总算不是单纯刷分的「乏味Benchmark」。四道赛题,全部从真实金融场景中生长出来: 看盘面:识别机构交易行为与资金流向;啃文档:将复杂保险PDF还原为结构化Markdown;做实验:在稀疏反馈下完成自动化实验设计;读长文:控制Token成本,对金融长文本精准问答。 是的,专挑金融这个最「地狱级」的训练场。 很多人可能不知道,模型发展到今天,金融垂直任务依然没能被啃下来。 以保险文档还原Markdown为例,一旦碰到大图片、大文档场景,模型在相关Benchmark上的平均分甚至会掉到0.1以下,即便是GPT、Gemi
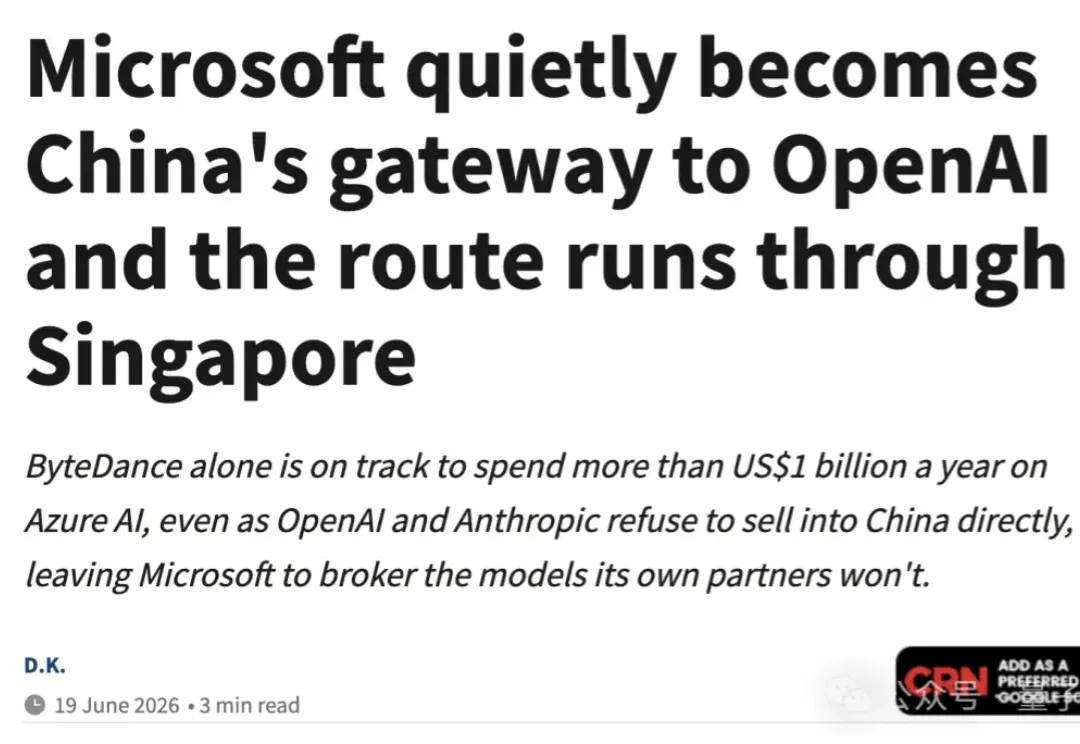
好你个微软,当起大模型“倒爷”来了?! 彭博社报道,微软正在向国内客户倒卖GPT模型,科技媒体CRN更是把微软说成了“中国通向OpenAI的门户”。 另外在“进口”的同时,微软也没忘做“出口”生意,正在把DeepSeek卖给外国用户。 总之大模型跨境中间商这套路数,也算是被微软给玩明白了。 这才是最高端的Token中转。 字节腾讯蚂蚁都是客户 根据彭博社的说法,在微软这场倒卖生意中,最大的客户是字节跳动。 而且字节在买GPT上砸钱砸得很壕,每年在微软AI和云服务上的花销,正奔着10亿美元去。 除了字节跳动,腾讯和美团也是微软Azure上的AI大客户,同样在通过微软采购OpenAI的模型。 字节
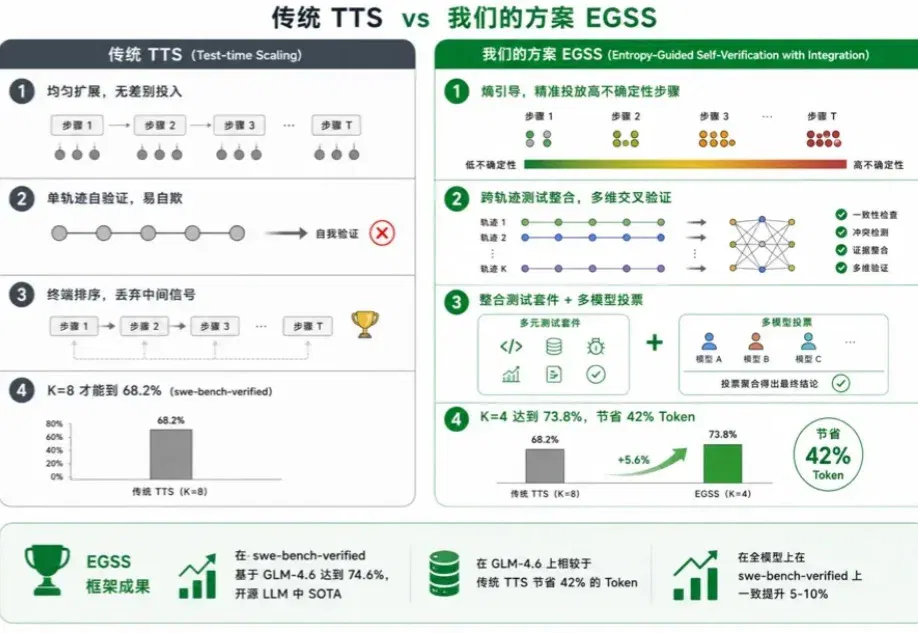
更聪明的计算远比更多的计算更有效。 这正是蚂蚁集团CodeFuse团队,用一篇ACL 2026主会论文验证的核心结论。 Test-Time Scaling(TTS)是通过在推理阶段投入更多计算资源,让Agent多次尝试、探索不同推理路径再选最优的关键范式,是当前LLM在复杂任务上取得SOTA的核心方法。 然而业界主流TTS方法对所有推理步骤一视同仁地投入计算,大量Token浪费在确定性操作上,且多轨迹选择仅靠“谁得票多”,Agent自我验证通过率88%中却有35.7%是错的—— 投入翻倍,收益边际递减。 针对这一现状,蚂蚁集团CodeFuse团队提出EGSS: 通过“工具熵”指标精准识别高不确
某天,老板让你用 Agent 手搓个自动化流程的小工具,你袖子一撸,信心满满地开干。
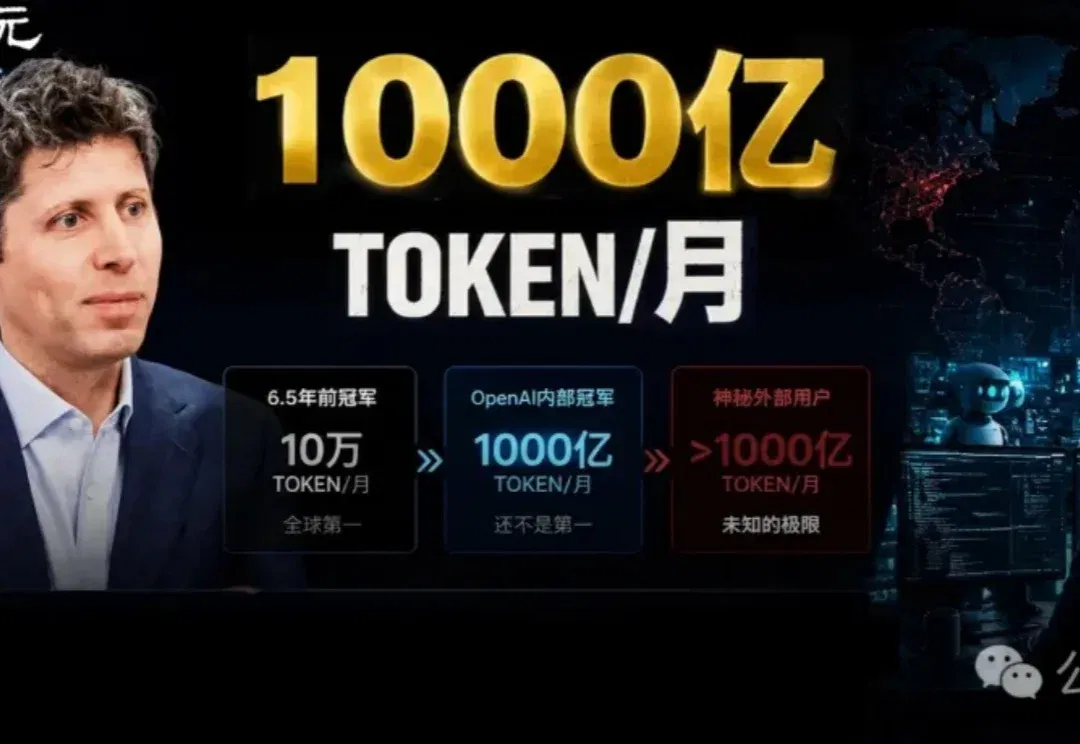
奥特曼亲口承认,OpenAI内部token消费冠军月烧1000亿个,还不是全球第一。
让 AI 来管理代码的话,每次读 500 行反而比读 1000 行更费 Token,而且人工编排流程真不如让大模型自己定,「很多的事儿,还是很反直觉的」
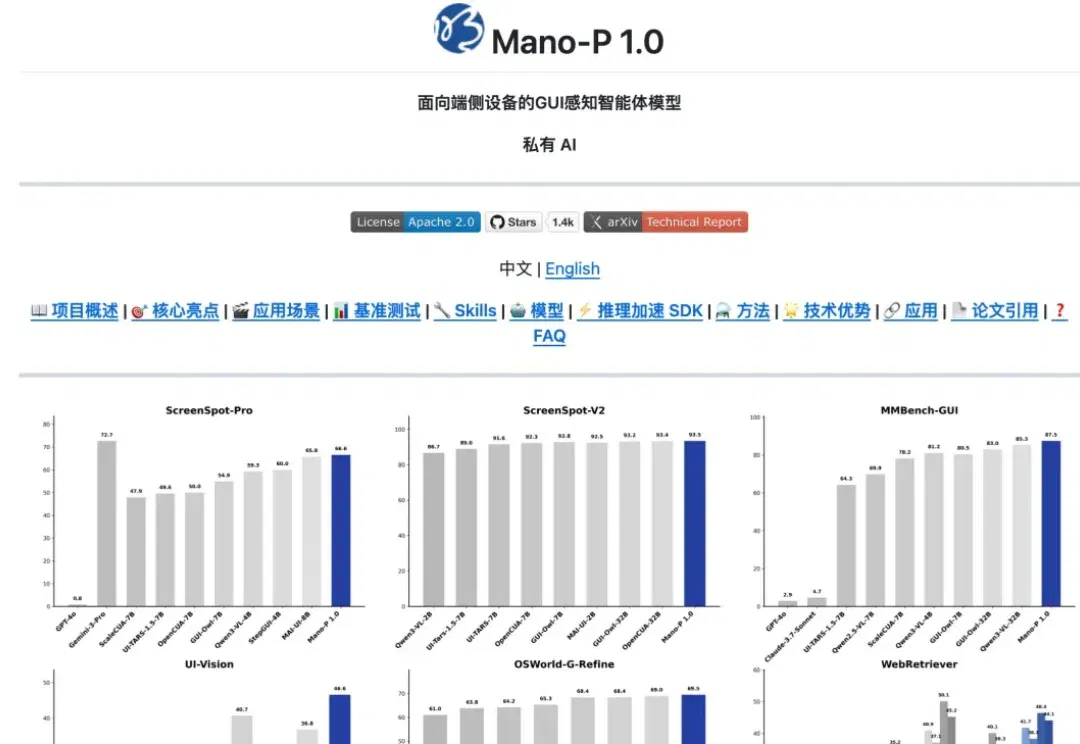
上次给大家分享了一个 CUA 的开源项目,能让 AI Agent 直接操控电脑界面,相当于把任何 App 都变成 Agent 的 Skill。反响还不错。
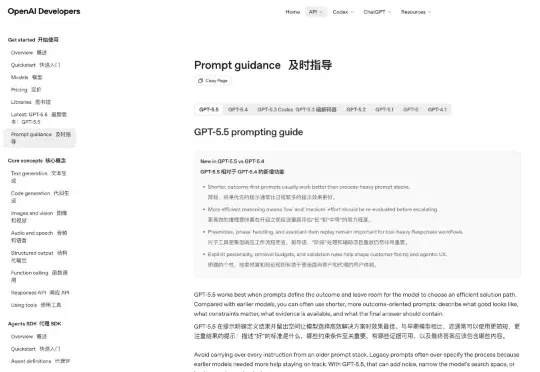
OpenAI 和 Anthropic 几乎在同一时间发布自己的提示词文档,在 OpenAI 官网,从 GPT-4.1 到 GPT 5.5,每次新模型发布都有一份完整的提示词指南,告诉我们怎么用新的模型。