搜索

关于“大模型”的结果

共 1517 篇

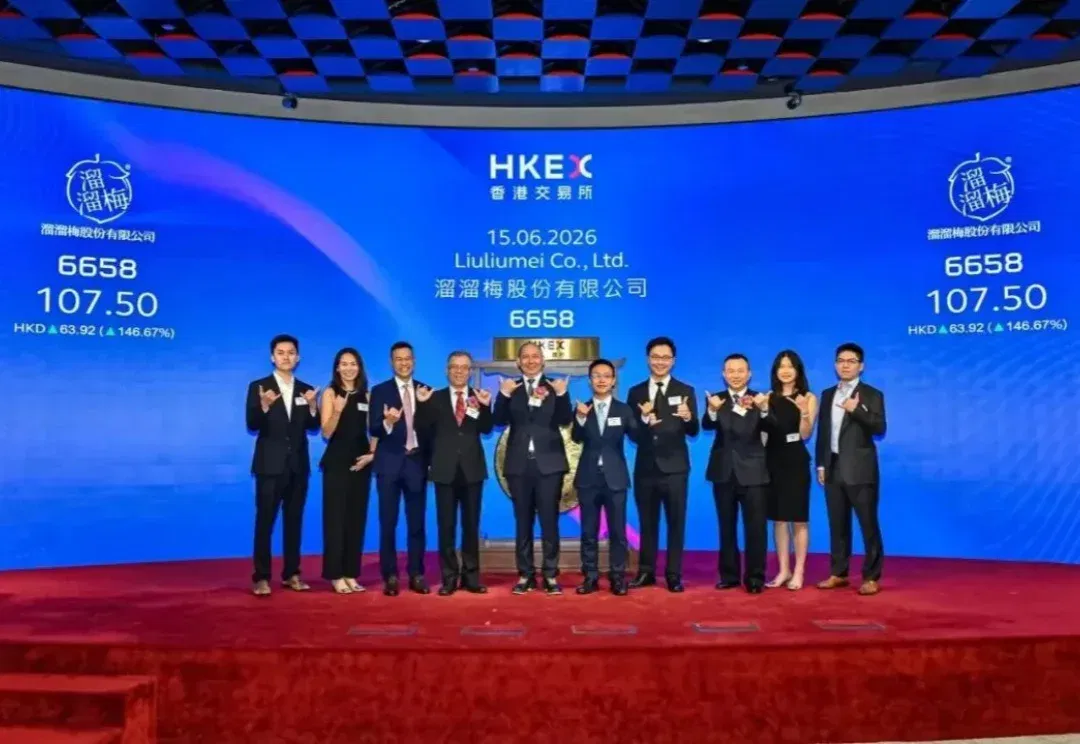
离谱!溜溜梅撞名 LLM,被炒成AI概念股,上市首日暴涨 186%

离谱!溜溜梅撞名 LLM,被炒成AI概念股,上市首日暴涨 186%(在新窗口打开)

卧槽,这事真的太抽象了。 谁能想到,2026 年港股第一只被当成“AI 大模型概念股”疯炒的票,既不是烧掉几百亿算力的大模型公司,也不是哪个贴着英伟达概念的代工厂,而是一家卖酸梅子的,溜溜梅。。。 对,就是你晕车时妈妈塞给你的那个溜溜梅。 这个荒诞剧情,是这样的: 6 月 15 日,“青梅零食第一股”溜溜梅正式在港交所主板挂牌,代码 06658.HK。 这家公司其实来头不小:1999 年起家于安徽芜湖,创始人杨帆当年顶着“青梅太酸没人买”的质疑硬是把酸梅做成了生意,2013 年砸两千多万签下杨幂代言出圈,一句“你没事吧”的广告词洗了一代人的脑。 到今天,它已经是国内青梅零食赛道的绝对龙头,三度
AI资讯
0
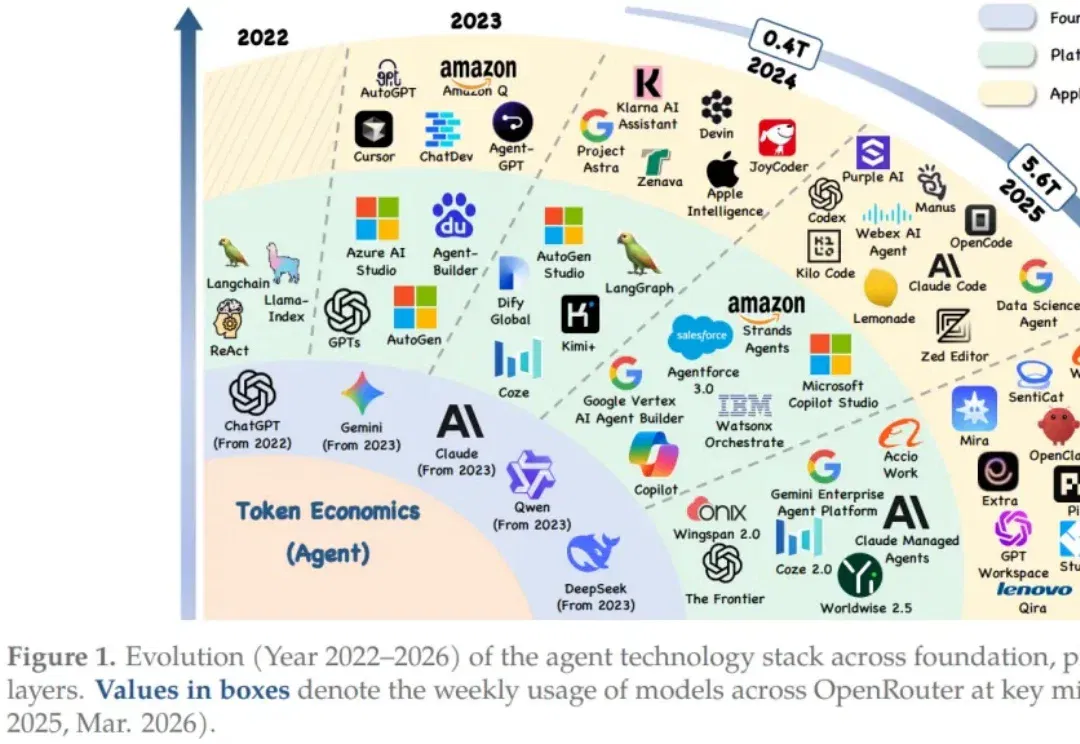
首次系统定义「Token经济学」,浙大&阿里联合发布大模型Agent资源分配新范式

首次系统定义「Token经济学」,浙大&阿里联合发布大模型Agent资源分配新范式(在新窗口打开)

当大模型 Agent 从实验室加速走向金融、医疗、代码开发等高价值场景,一个隐秘却致命的瓶颈正在浮现:Token 的指数级消耗正引发算力、协作与安全的系统性危机。传统 “堆算力、加参数” 的线性优化已触及天花板,我们该如何在 “输出质量” 与 “经济成本” 之间找到可持续的最优解?

AI技术文章
0
Z Tech|对话Andrew Dai:14年DeepMind生涯,见证PaLM到Gemini,下一站押注视觉推理

Z Tech|对话Andrew Dai:14年DeepMind生涯,见证PaLM到Gemini,下一站押注视觉推理(在新窗口打开)

过去十年,大模型世界里很多最关键的技术路线背后,都能看到Andrew Dai的身影。从早期预训练与监督微调,到后来主流的MoE(Mixture of Experts)架构;从Google Brain最初只有几十人的研究时代,到后来支撑Gemini的大规模数据体系,这位在 Google 工作超过14年的研究科学家,几乎站在了大模型时代每一次关键转折的现场。

AI资讯
0
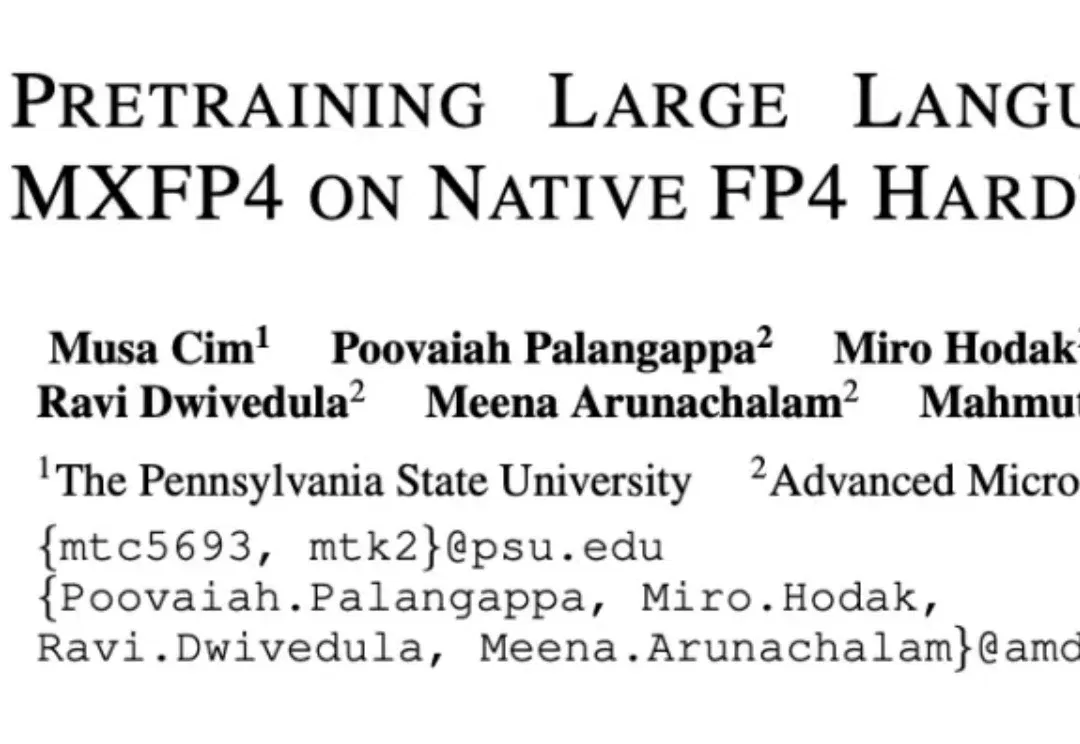
AMD新论文颠覆认知:FP4训练不稳定,原因不是随机性不足

AMD新论文颠覆认知:FP4训练不稳定,原因不是随机性不足(在新窗口打开)

众所周知,大模型训练成本极高。 但大家又知道,降低训练精度能够显著降低训练成本。DeepSeek-V3 用 FP8 训练把成本打到了 560 万美元,已经让全行业侧目。 在 FP8 成功后,行业仍然在不断探索低精度的边界:从 FP8 降到 FP4,训练成本还能再降多少? 理论上,FP4 的计算吞吐可以是 FP8 的两倍。NVIDIA Blackwell 和 AMD MI350 系列都已经在硬件层面原生支持了 FP4 运算,前者在 B200 上标称 FP4 算力可达 4500 TOPS(稀疏)。硬件已经准备好了,但软件和算法那一侧,一直卡在一个问题上: 用 FP4 从头训练大模型,训练过程非常不

AI技术文章
0