开启Benchmark的Harness时代:15家学术机构联合发布HarnessEval(在新窗口打开)
8 月 13 日,DeepSeek 开源 Agent Harness dsh,将 “Harness” 这个原本更偏工程语境的概念,推到了整个 AI 行业讨论的中心。
共 63 篇
8 月 13 日,DeepSeek 开源 Agent Harness dsh,将 “Harness” 这个原本更偏工程语境的概念,推到了整个 AI 行业讨论的中心。
想象一下:你精心调教了两周的 OpenClaw,自信满满地跑了一组 Benchmark——结果发现全球排名 387 位,前面那位用的模型跟你一样,但分数比你高 40%。你想不想知道他到底配了什么 Skill?
答案或许渐渐清晰。李飞飞团队与斯坦福 AI 实验室正式官宣:首届 BEHAVIOR 挑战赛将登陆 NeurIPS 2025。这是一个为具身智能量身定制的 “超级 benchmark”,涵盖真实家庭场景下最关键的 1000 个日常任务(烹饪、清洁、整理……),并首次以 50 个完整长时段任务作为核心赛题,考验机器人能否在逼真的虚拟环境中完成真正贴近人类生活的操作。
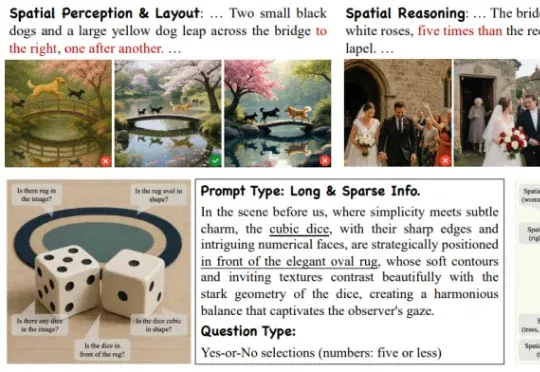
来自阿里高德的一篇最新 ICLR 2026 中稿论文《Everything in Its Place: Benchmarking Spatial Intelligence of Text-to-Image Models》提出了面向文生图空间智能的系统性评估基准 SpatialGenEval,旨在通过长文本、高信息密度的 T2I prompt 设计,以及围绕空间感知
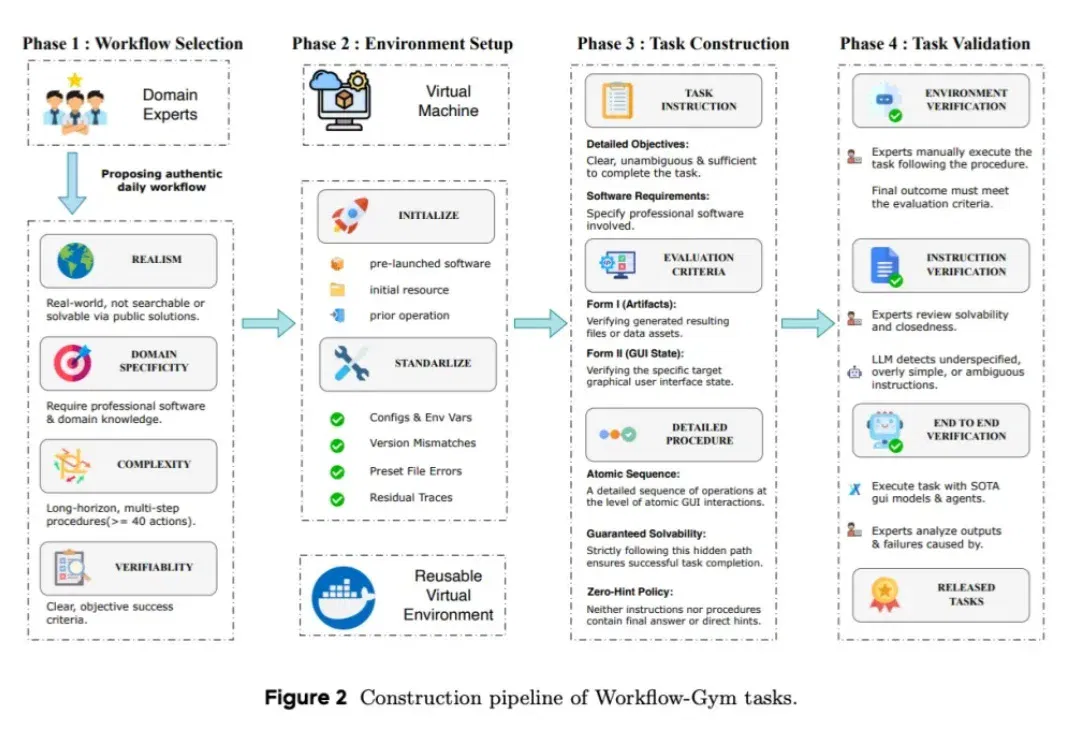
你可能已经在各种 benchmark 榜单上看过 GUI Agent 的 "大胜" 了。
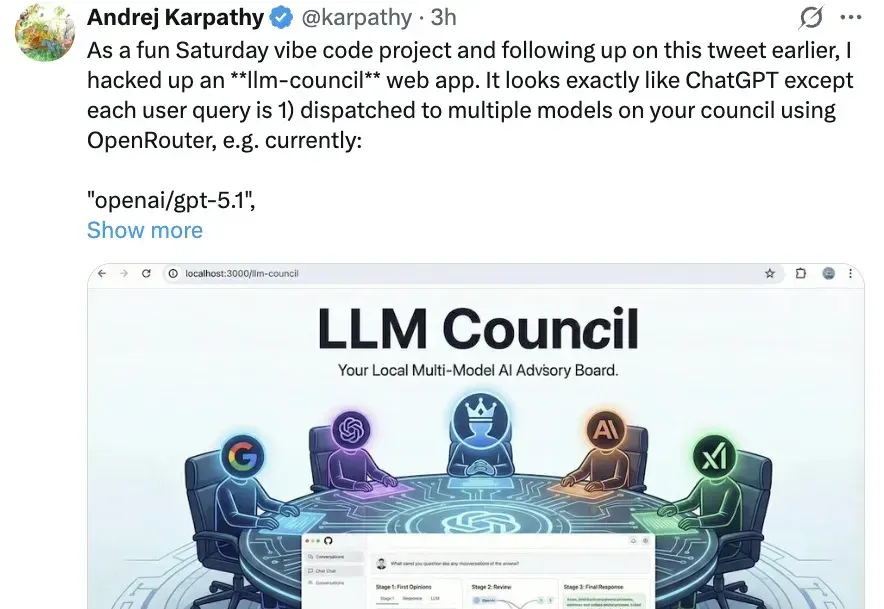
卡帕西又来发布趣味编程项目了~ 这次直接整了一个“大模型议会”(LLM Council)web app。 界面看起来和ChatGPT的聊天形式别无二致,但实际上当用户输入问题后,系统会通过OpenRouter调起多个大模型开会商议。 有意思的是,它们不仅会一起答题,而且还会互相评分、排序,最终将由主席模型给出一个统一答案。 卡帕西刚把这个应用的安装部署教程分享出来,就立马被不少网友码住: 更有甚者表示,或许以后模型自己评价模型本身就能变成一种新的“自动benchmark”: 畅销书《Python机器学习》作者也很看好这个思路: LLM议会怎么玩 具体来说,卡帕西的这个LLM议会系统,主要可分为
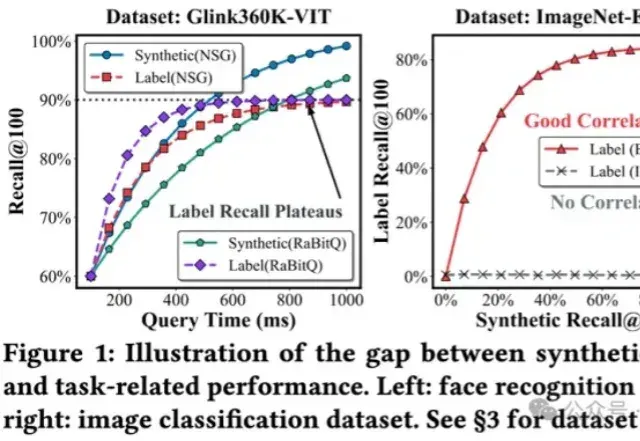
将多模态数据纳入到RAG,甚至Agent框架,是目前LLM应用领域最火热的主题之一,针对多模态数据最自然的召回方式,便是向量检索。
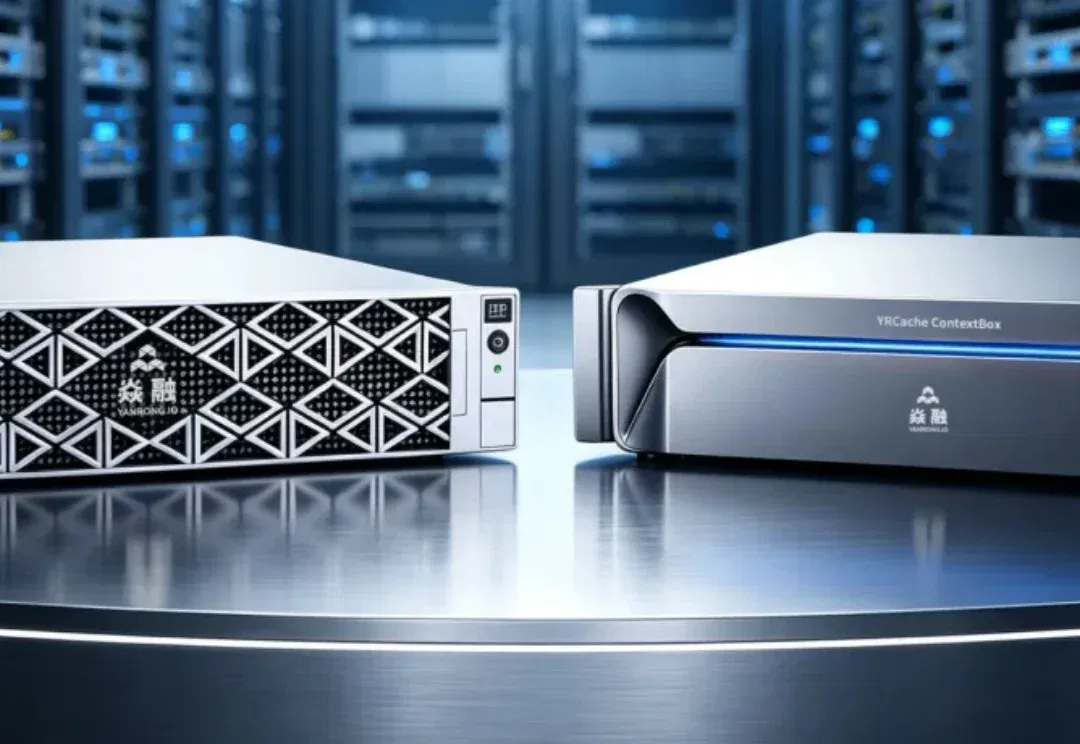
AI存储进入全流程竞争。 智东西9月17日报道,9月1日,全球权威AI性能评测组织MLCommons发布MLPerf Storage v3.0基准测试榜单。焱融全闪AI存储F9000X在多项基准测试中拿下第一,充分验证其在极限AI训练负载下对高速网络带宽的高效利用能力。 ▲数据引用:MLPerf Storage Benchmark v3.0 Suite Results 2026 随着AI产业从模型训练走向规模化推理,存储系统需要处理的数据和承担的任务也在增加。训练阶段,存储要持续向GPU供给海量数据,还要快速保存和恢复模型 Checkpoint;推理阶段,系统又要管理不断膨胀的KV Cache
BAI资本成员企业Humanlaya(原壤智能)宣布完成由鼎晖香港基金领投的数亿元Pre-A轮融资,公司聚焦大模型后训练数据与评测,通过专家网络、高质量数据生产与Benchmark体系帮助模型提升在金融、法律、医疗等复杂专业任务中的能力。
2026 年 3 月,轨道数据中心公司 Starcloud 宣布完成 1.7 亿美元 A 轮融资,由 Benchmark 与 EQT Ventures 领投,估值达到 11 亿美元,累计融资额达到 2 亿美元。