ACL 2026 | LCA:DeepSeek 长文本加速神器,90% KV 缓存缩减 + 2.5 倍推理提速(在新窗口打开)
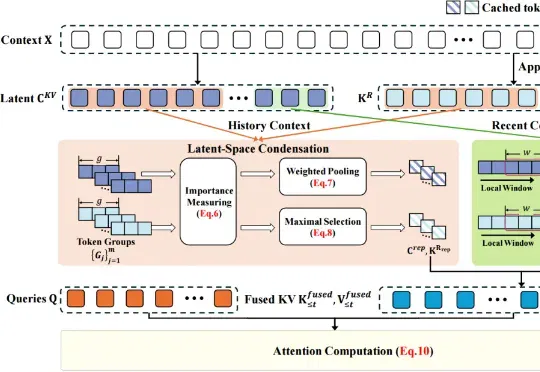
近日,琶洲实验室、华南理工大学、蔻町(AIGCode)等单位科研团队联合提出潜在空间压缩注意力(Latent-Condensed Attention,LCA),研究成果入选 ACL 2026。
共 39 篇
近日,琶洲实验室、华南理工大学、蔻町(AIGCode)等单位科研团队联合提出潜在空间压缩注意力(Latent-Condensed Attention,LCA),研究成果入选 ACL 2026。
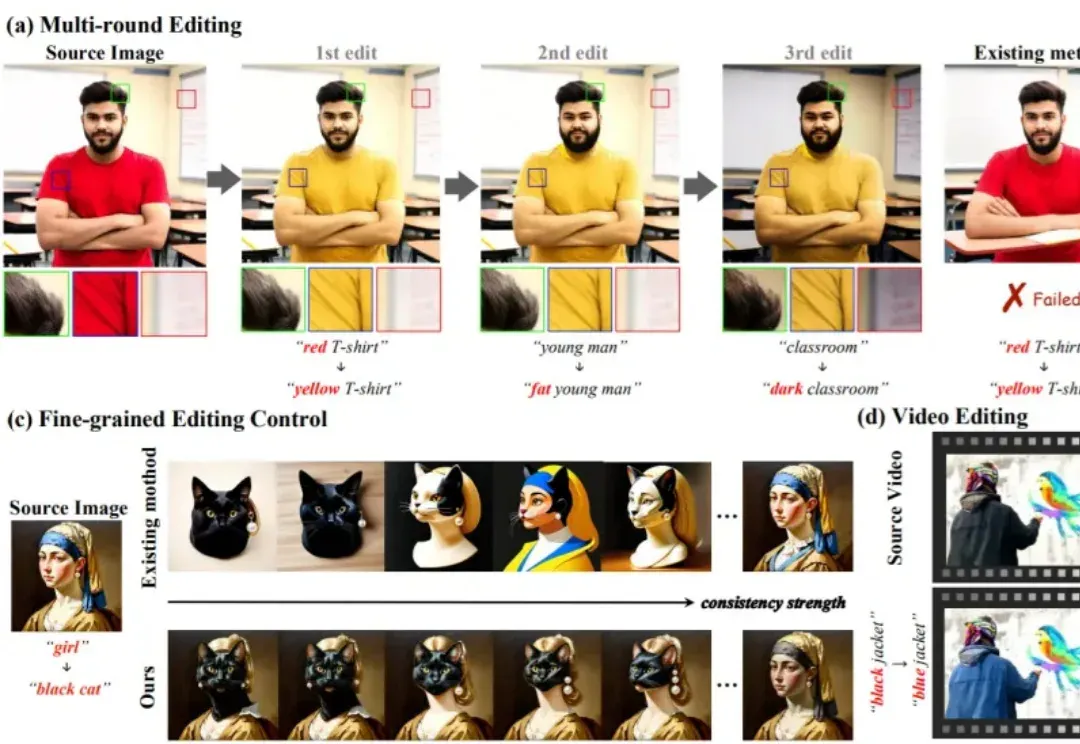
无需额外训练即可适配预训练生成模型的编辑方法,凭借灵活、高效的特性,已成为视觉生成领域的研究热点。这类方法通过操控 Attention 机制(如 Prompt-to-Prompt、MasaCtrl)实现文本引导编辑,但当前技术存在两大核心痛点,严重限制其在复杂场景的应用
刚发V3.1“最终版”,DeepSeek最新模型又来了!DeepSeek-V3.2-Exp刚刚官宣上线,不仅引入了新的注意力机制——DeepSeek Sparse Attention。还开源了更高效的TileLang版本GPU算子!
今天,曾因 Attention Residuals 论文走红的 AI 少年陈广宇(Nathan Chen),宣布离开 Kimi。
就在刚刚,Moonshot AI(月之暗面)发布了一项足以撼动 Transformer 底层的研究:《Attention Residuals》。海外科技大 V,谷歌高级AI产品经理 Shubham Saboo 直接开启了“高赞”模式:“他们触碰了那个十年没人敢碰的部分。”
图片不只被编码,还直接参与 Attention、MoE 与 Agent 推理。
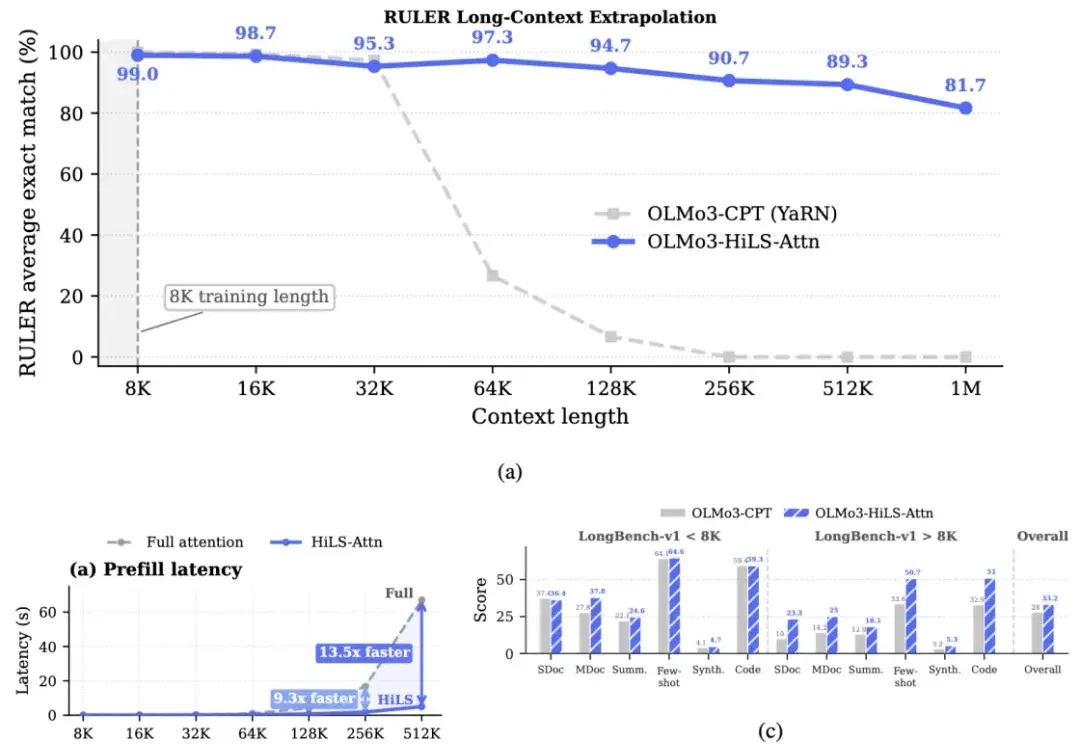
让大模型 "读得更长" 一直是 Agent、深度推理和海量资料整合等场景的刚需,但标准全注意力机制的计算量随序列长度呈平方级增长,始终是横亘在长上下文建模面前的三座大山。
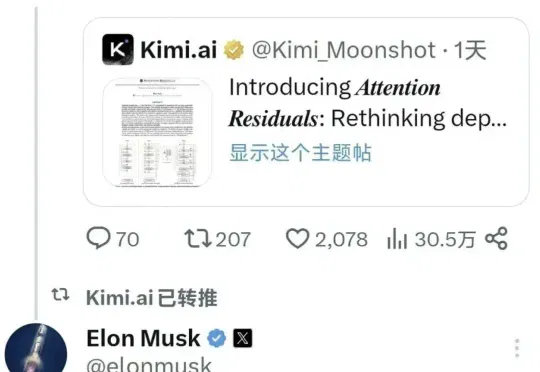
前几天,一篇来自Kimi的论文「ATTENTION RESIDUALS」在 AI 圈引发了激烈讨论——马斯克罕见地发出评价:"Impressive work from Kimi"。同时,两位前Openai大佬也同样发出了高度评价,OpenAI 「推理模型之父」Jerry Tworek表示“深度学习2.0时代即将到来”。
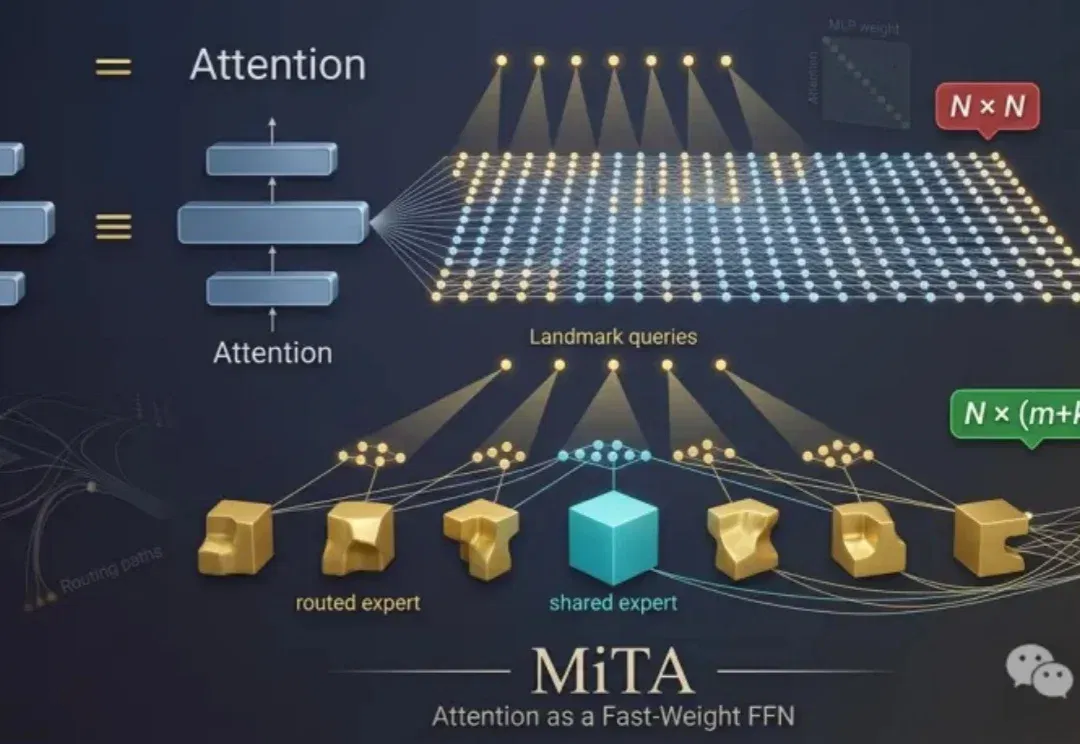
一直以来,在Transformer架构中,注意力(Attention)与前馈网络(Feed-Forward Network,FFN)被认为是两个功能不同且互补的模块: 前者让词元(Token)彼此交互,后者对每个词元进行非线性变换。
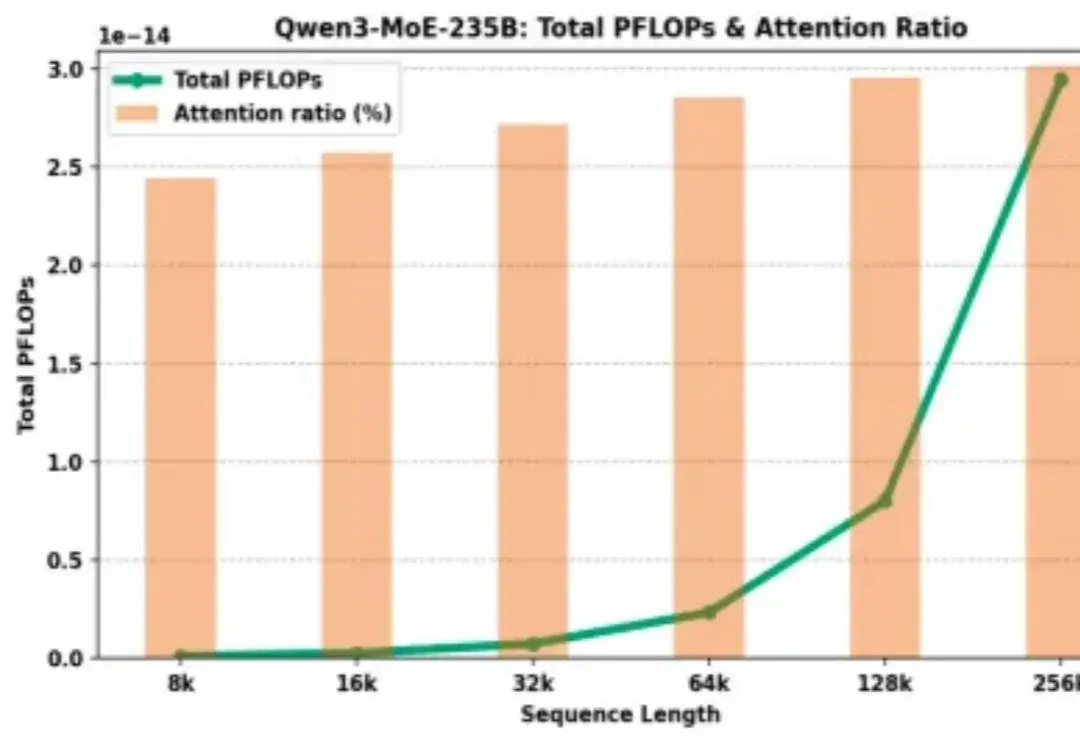
为什么大模型厂商给了 128K 的上下文窗口,却在计费上让长文本显著更贵?