搜索

关于“VLA”的结果

共 122 篇

0.9B跑出90%真机成功率!上海交大为VLA补上空间感

0.9B跑出90%真机成功率!上海交大为VLA补上空间感(在新窗口打开)

机器人看得见,但不一定看得准。 大量VLA模型仍然主要依赖二维视觉,一旦遇到精定位、细摆放、遮挡判断这类需要空间感知的任务,成功率就会明显下滑。 补空间信息的路有两条,但都有代价。 显式3D路线靠深度传感器和点云重建,硬件链路长、对标定误差敏感;隐式3D路线从RGB学几何,省了硬件,但不少方案依赖较重的基础模型,训练和推理成本偏高。 现在,上海交大MINT团队提出了一条中间路线: Evo-Depth,约0.9B参数,不额外增加硬件负担,用紧凑的隐式深度编码把空间感写进VLA策略里,仿真与真机同时兼顾性能与部署效率。 仿真端,Meta-World 84.4%、LIBERO 95.4%;真机平均成
AI技术文章
0
CVPR 2026 | 突破短视,理解变化!HiF-VLA:以motion为中心打造「边想边做」的世界动作模型

CVPR 2026 | 突破短视,理解变化!HiF-VLA:以motion为中心打造「边想边做」的世界动作模型(在新窗口打开)

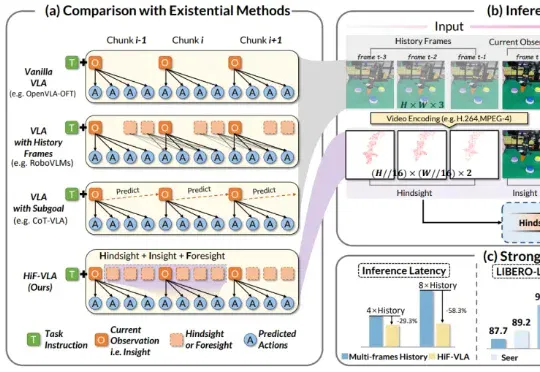
来自西湖大学、浙江大学、西湖机器人等机构的研究团队提出了一种以运动(Motion)为中心的全新双向时空推理框架 HiF-VLA。抛弃冗余的像素级输入,HiF-VLA 巧妙提取低维紧凑的 Motion 向量作为动态先验,在一个创新的「联合专家」模块中,同步完成未来视觉运动的预测与高精度动作序列的生成。

AI技术文章
0
ICLR 2026|新版「图灵测试」:当VLA走进生物实验室

ICLR 2026|新版「图灵测试」:当VLA走进生物实验室(在新窗口打开)

现有 VLA 模型的研究和基准测试多局限于家庭场景(如整理餐桌、折叠衣物),缺乏对专业科学场景(尤其是生物实验室)的适配。生物实验室具有实验流程结构化、操作精度要求高、多模态交互复杂(透明容器、数字界面)等特点,是评估 VLA 模型精准操作、视觉推理和指令遵循能力的理想场景之一。

AI技术文章
0
突破视觉-语言-动作模型的瓶颈:QDepth-VLA让机器人拥有更精准的3D空间感知

突破视觉-语言-动作模型的瓶颈:QDepth-VLA让机器人拥有更精准的3D空间感知(在新窗口打开)

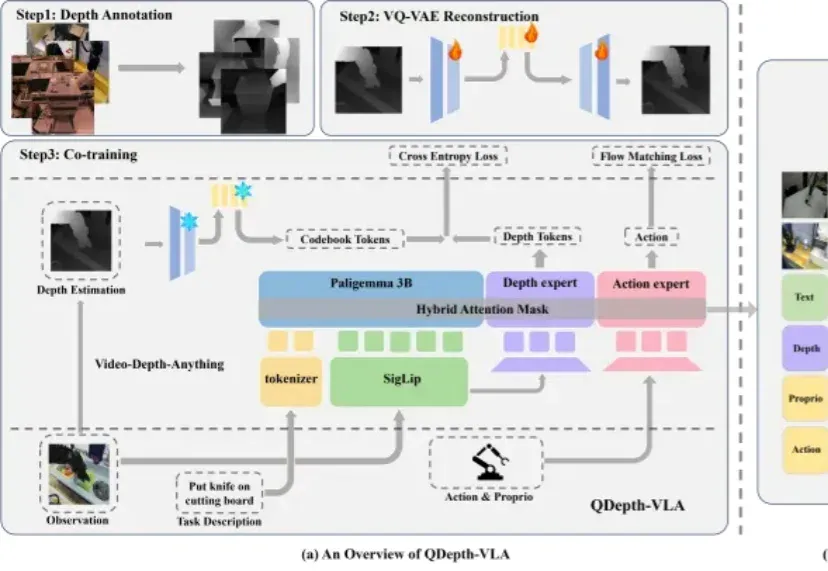
视觉-语言-动作模型(VLA)在机器人操控领域展现出巨大潜力。通过赋予预训练视觉-语言模型(VLM)动作生成能力,机器人能够理解自然语言指令并在多样化场景中展现出强大的泛化能力。然而,这类模型在应对长时序或精细操作任务时,仍然存在性能下降的现象。

AI技术文章
0
机器人「看片」自学新技能:NovaFlow从生成视频中提取动作流,实现零样本操控

机器人「看片」自学新技能:NovaFlow从生成视频中提取动作流,实现零样本操控(在新窗口打开)

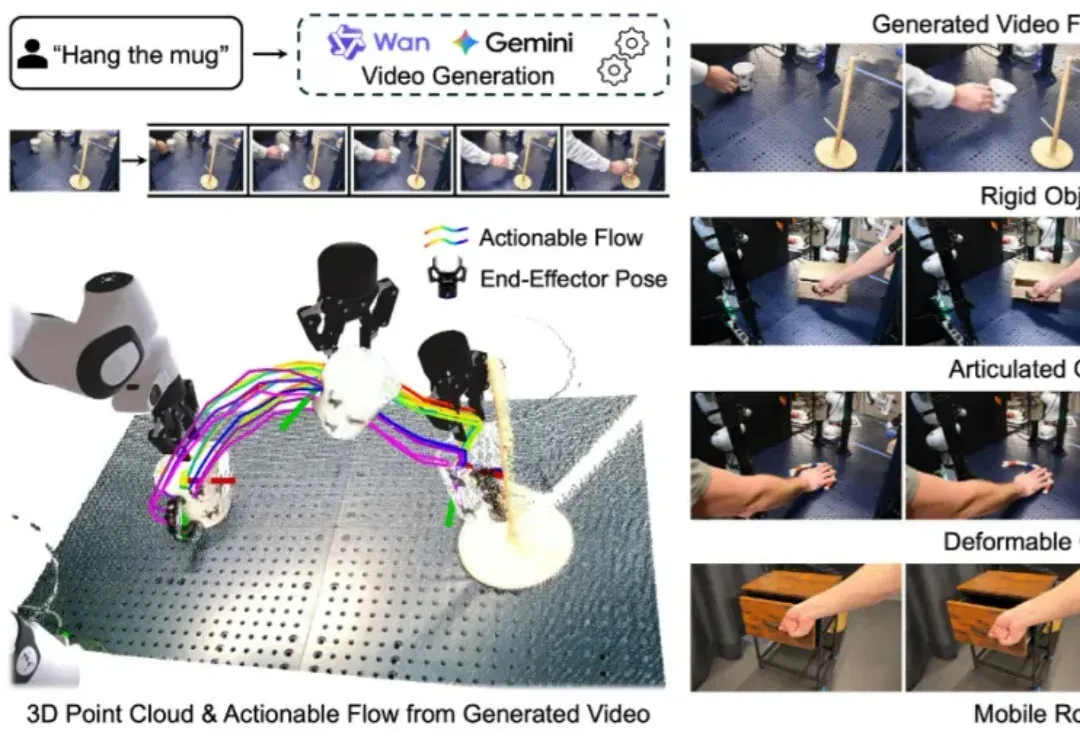
构建能够在新环境中、无需任何针对性训练就能执行多样化任务的通用机器人,是机器人学领域一个长期追逐的圣杯。近年来,随着大型语言模型(LLMs)和视觉语言模型(VLMs)的飞速发展,许多研究者将希望寄托于视觉 - 语言 - 动作(VLA)模型,期望它们能复刻 LLM 和 VLM 在泛化性上取得的辉煌。

AI技术文章
0