刚刚,翁荔博客上新:谨慎对待Scaling Law(在新窗口打开)
刚刚,翁荔(Lilian Weng)的博客 Lil'Log 终于更新了!要知道,自从她联合创立了 Thinking Machines Lab 之后,她那让许多人受益良多的博客就鲜少更新了——距离她上一次更新,已经过去了 13 个月。
共 67 篇
刚刚,翁荔(Lilian Weng)的博客 Lil'Log 终于更新了!要知道,自从她联合创立了 Thinking Machines Lab 之后,她那让许多人受益良多的博客就鲜少更新了——距离她上一次更新,已经过去了 13 个月。
刚刚,翁荔(Lilian Weng)又更新博客了!距离她上一次更新《谨慎对待 Scaling Law》还不到 10 天。这一次,她书写的主题是当前大热的 Harness Engineering,聚焦的正是当下 AI 研究最前沿一个环节:当模型本身的智能已经足够强大时,真正决定它能走多远的,或许是包裹在模型外面的那层「Harness」也就是负责编排模型思考、调用工具、管理上下文、评估结果的那套系统。
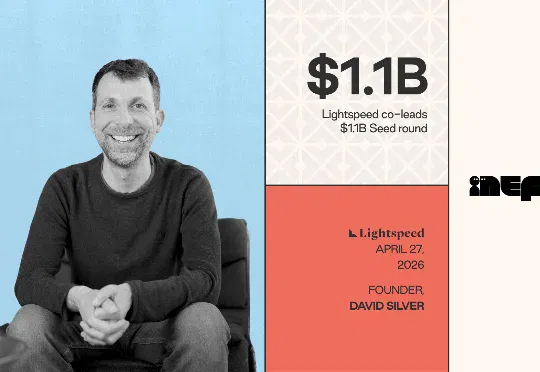
AlphaGo 之父 David Silver 创办的 Ineffable Intelligence 获 11 亿美元种子轮,创欧洲融资纪录,估值达 51 亿美元。这家公司押注强化学习和自我经验学习,试图挑战依赖 Scaling Law 的大模型主线。
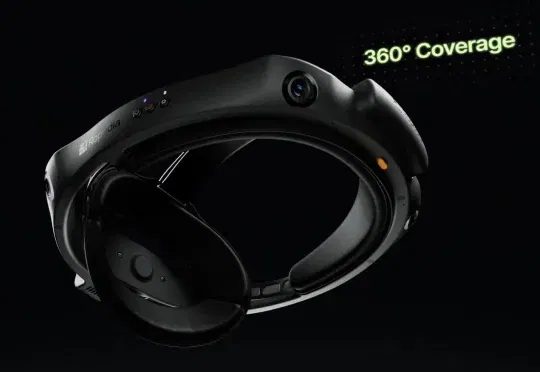
新加坡Physical AI公司Ropedia正式发布新一代多模态采集系统HOMIE Gen2,以4目全景360°、十余种模态同步采集与开箱即用的高精度训练级数据,将人类经验规模化为机器人可直接学习的训练数据,推动Physical AI的经验规模化落地。
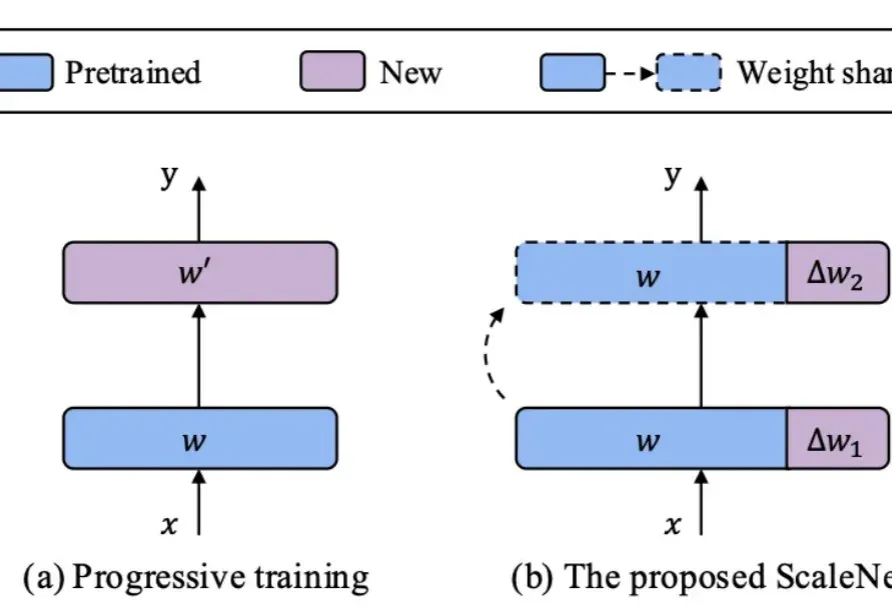
在基础模型领域,模型规模与性能之间的缩放定律(Scaling Law)已被广泛验证,但模型增大也伴随着训练成本、存储需求和能耗的急剧上升。如何在控制参数量的前提下高效扩展模型,成为当前研究的关键挑战。
MiniMax 海螺视频团队「首次开源」了 VTP(Visual Tokenizer Pre-training)项目。他们同步发布了一篇相当硬核的论文,它最有意思的地方在于 3 个点:「重建做得越好,生成反而可能越差」,传统 VAE 的直觉是错的
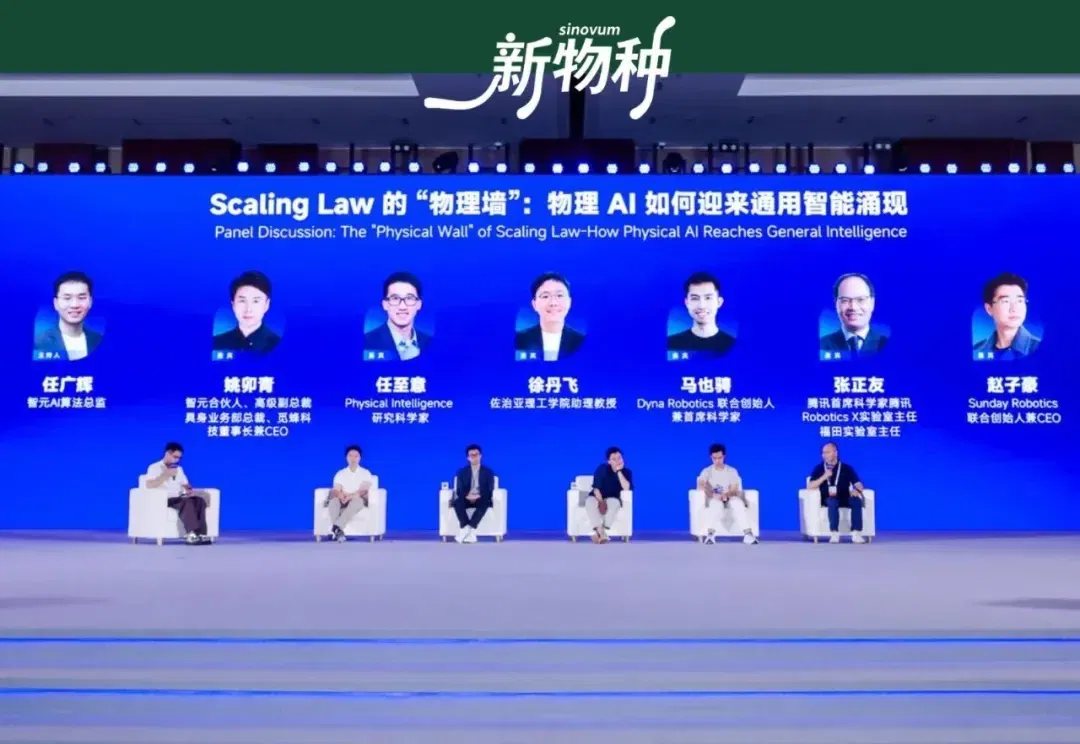
模型决定起点,数据定义终局。 2026年盛夏,上海世博中心,世界人工智能大会(WAIC)如约而至。如果说前几届大会的焦点是数字世界中的大模型参数竞赛,那么今年,聚光灯无疑打向了一个更富挑战性的领域:物理AI。 大会期间,中国向全球宣布支持人工智能发展与国际合作的重要举措,释放出进一步推动AI开放创新的信号。随着人工智能从实验室走向产业,全球AI竞争也正在进入一个新的阶段:从单纯追求模型能力突破,转向探索如何让智能真正进入现实世界。 7月19日,一场名为“智启具身”的论坛,汇聚了来自Physical Intelligence(PI)、Genesis AI、Dyna Robotics、腾讯Robo
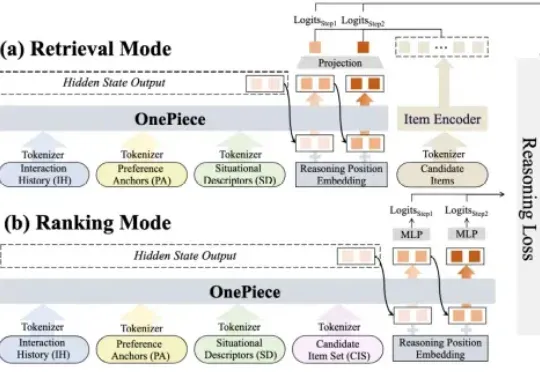
2025 年,生成式推荐(Generative Recommender,GR)的发展如火如荼,其背后主要的驱动力源自大语言模型(LLM)那诱人的 scaling law 和通用建模能力(general-purpose modeling),将这种能力迁移至搜推广工业级系统大概是这两年每一个从业者孜孜不倦的追求。
这几天,一篇关于向量嵌入(Vector Embeddings)局限性的论文在 AlphaXiv 上爆火,热度飙升到了近 9000。

If I Had One Bet on Robot Learning, I’d Bet on Cross-Entropy. 大语言模型的成功揭示了一个适用于一维序列数据的清晰 Scaling Law:通过自回归训练,并采用交叉熵(cross-entropy)目标函数预测下一个 token 的概率分布,模型能够建模非常复杂的语义概率分布,并随着数据规模和模型规模的增长持续提升性能。