让搜索Agent不「傻等」:人大团队依托扩散模型实现「一心二用」,边等搜索结果边思考,加速15%性能不减(在新窗口打开)
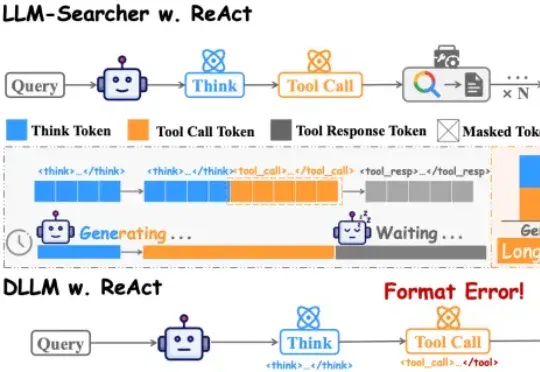
中国人民大学团队在论文DLLM-Searcher中,第一次让扩散大语言模型(dLLM)学会了这种“一心二用”的本事。目前主流的搜索Agent,不管是Search-R1还是R1Searcher,用的都是ReAct框架。这个框架的执行流程是严格串行的:
共 224 篇
中国人民大学团队在论文DLLM-Searcher中,第一次让扩散大语言模型(dLLM)学会了这种“一心二用”的本事。目前主流的搜索Agent,不管是Search-R1还是R1Searcher,用的都是ReAct框架。这个框架的执行流程是严格串行的:
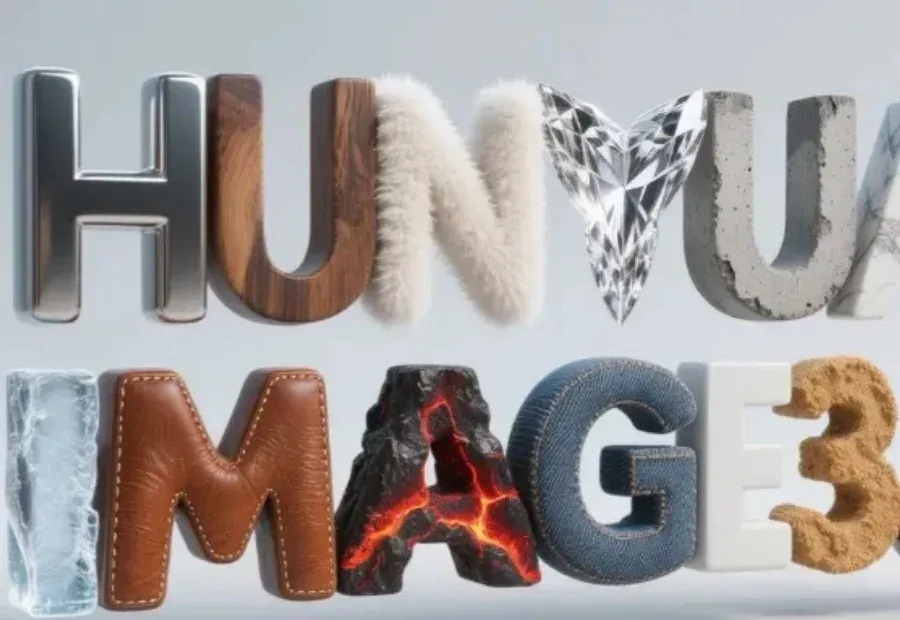
一句话P电商海报、一键换装滑冰。 智东西1月28日报道,今天,腾讯混元图像3.0图生图版本正式开源。在最新的LMArena图片编辑榜单上,腾讯混元图像3.0图生图位列全球第七,也是前七名里面唯一开源的模型。 ▲LMArena图片编辑榜单(来源:LMArena) LMArena官方X祝贺混元图像3.0图生图“在图片编辑榜单中与Nano-Banana和Seedream-4.5等表现相当”。 ▲LMArena官方祝贺推文(来源:X) 混元图像3.0图生图支持增、删、改、风格变换、老照片修复、人物与文字修改等图片编辑功能,还可以将多张照片中的元素提取出来合成新图片。 1月26日,该模型在元宝上线,已经

前OpenAI Sora负责人比尔·皮布尔斯(Bill Peebles)与DreamWorks联合创始人杰弗里·卡岑伯格(Jeffrey Katzenberg)及Dropbox前CFO苏杰伊·贾斯瓦(Sujay Jaswa)共同创办AI视频创业公司,将自主训练视频模型,并与Andreessen Horowitz等投资人洽谈融资。
斯坦福和MIT的研究团队推出了一种新的AI智能体推理框架ReCAP,在长上下文任务中全面超越了现有的主流框架ReAct,性能提升显著。ReCAP通过独特的递归树结构和三大机制,解决了大语言模型在复杂任务中常见的目标漂移、上下文断层和成本爆炸等问题。
最近读到a16z合伙人Olivia Moore的一篇分析文章《 The Great Expansion: A New Era of Consumer Software》,她把这种现象称为"Great Expansion"(大扩张),我觉得她抓住了一个非常关键的趋势。
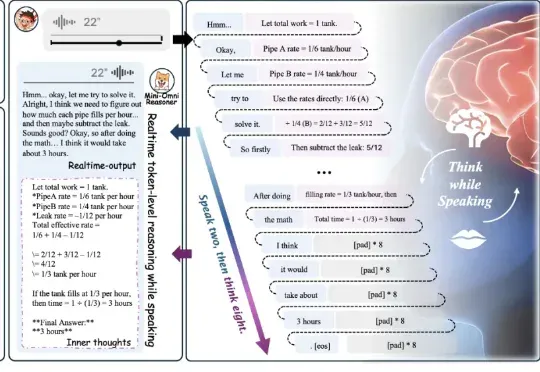
基于这一挑战,我们提出了 Mini-Omni-Reasoner——一种专为对话场景打造的实时推理新范式。它通过「Thinking-in-Speaking」实现边思考边表达,既能实时反馈、输出自然流畅的语音内容,又能保持高质量且可解释的推理过程。
这两天,GitHub 上一个叫 REA(Reverse Engineer Anything)的项目狂揽了近 7 万颗星!
UiT 架构探路者,底牌还没亮。 2026 年 5 月,智象未来开源了文生图模型 HiDream-O1-Image(8B),直接登顶 Artificial Analysis 开源模型全球第一,Elo 1187 的分数力压 Qwen Image(27B)和 FLUX.2 dev。值得注意的是,这也是 Artificial Analysis 榜单前十中唯一的开源模型。 但消息一出,有人说最强一代开源文生图模型“实至名归”,却也有人直接骂“生成质量一坨”。Artificial Analysis 可不是随便哪里冒出来的野生榜单,盲测 Arena 里都是用户实时投票打出来的结果。 两极分化的评价让我们感
核心观点:由前Apple Vision Pro两位技术负责人联合创办的Reactor,近期完成5900万美元种子轮及A轮融资,由Lightspeed Venture Partners领投,WndrCo
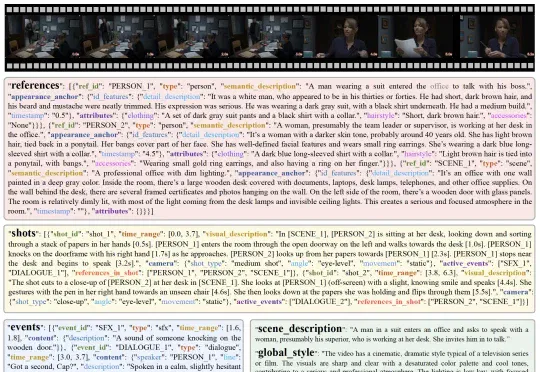
腾讯混元团队提出了 Multi-Stream Scene Script(MTSS),一种全新的视频描述范式 —— 将传统的 "一段话描述整个视频" 升级为 "多流结构化剧本",通过 Stream Factorization 和 Relational Grounding 两大核心原则,让视频描述既忠实又可扩展,在视频理解和生成任务中均取得显著提升。