DeepSeek-V3.2被找出bug了:疯狂消耗token,答案还可能出错,研究人员:GRPO老问题没解决(在新窗口打开)
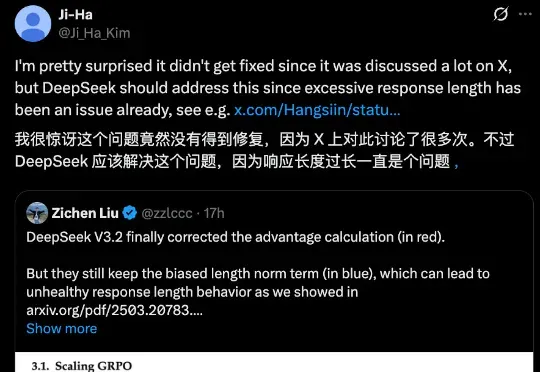
DeepSeek-V3.2很强很火爆,但随着讨论的深入,还是有bug被发现了。 并且是个老问题:浪费token。不少网友都提到,DeepSeek-V3.2的长思考增强版Speciale,确确实实以开源之姿又给闭源TOP们上了压力,但问题也很明显:
共 25 篇
DeepSeek-V3.2很强很火爆,但随着讨论的深入,还是有bug被发现了。 并且是个老问题:浪费token。不少网友都提到,DeepSeek-V3.2的长思考增强版Speciale,确确实实以开源之姿又给闭源TOP们上了压力,但问题也很明显:
就在刚刚,DeepSeek 又悄咪咪在 Hugging Face 上传了一个新模型:DeepSeek-Math-V2。顾名思义,这是一个数学方面的模型。它的上一个版本 ——DeepSeek-Math-7b 还是一年多以前发的。当时,这个模型只用 7B 参数量,就达到了 GPT-4 和 Gemini-Ultra 性能相当的水平。相关论文还首次引入了 GRPO,显著提升了数学推理能力。
强化学习能力强大,几乎已经成为推理模型训练流程中的标配,也有不少研究者在探索强化学习可以为大模型带来哪些涌现行为。
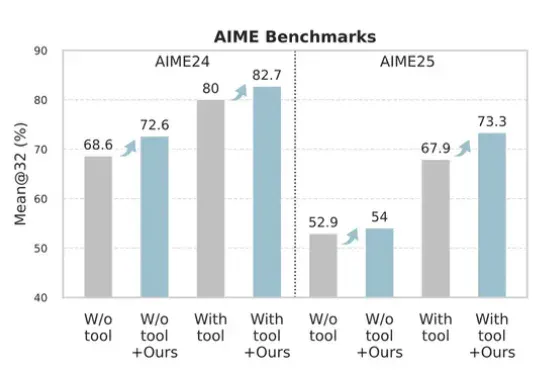
只花120元,效果吊打70000元微调!腾讯提出一种升级大模型智能体的新方法——无训练组相对策略优化Training-Free GRPO。无需调整任何参数,只要在提示词中学习简短经验,即可实现高性价比提升模型性能。
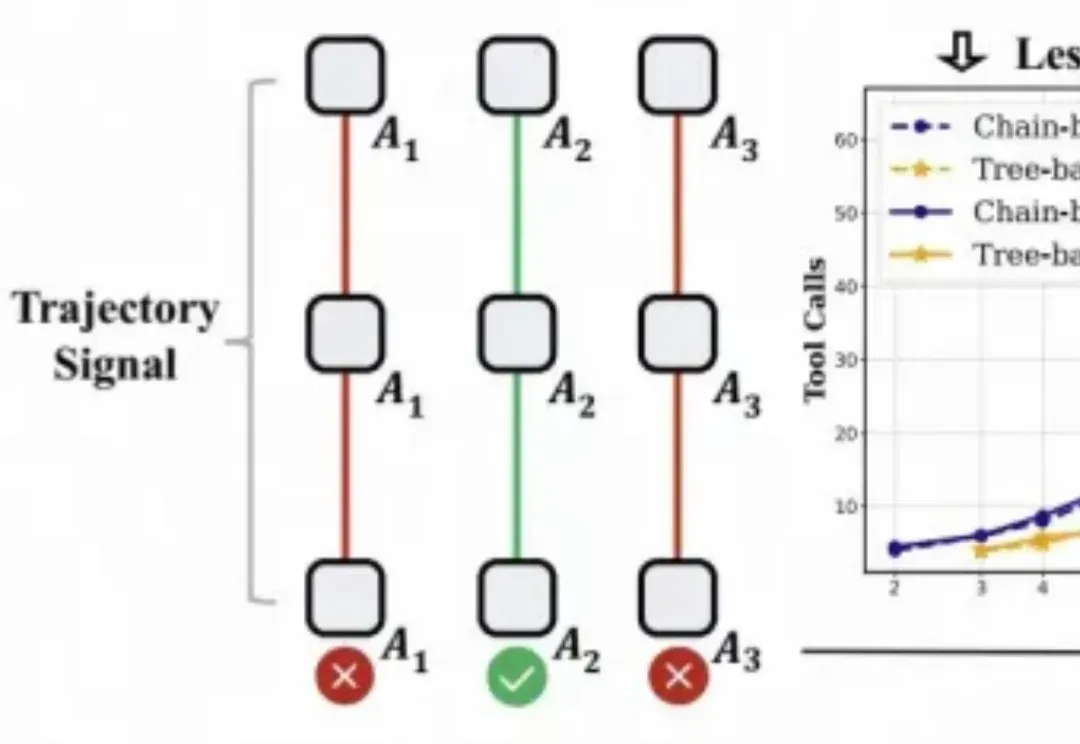
对于大模型的强化学习已在数学推理、代码生成等静态任务中展现出不俗实力,而在需要与开放世界交互的智能体任务中,仍面临「两朵乌云」:高昂的 Rollout 预算(成千上万的 Token 与高成本的工具调用)和极其稀疏的「只看结果」的奖励信号。