快手解密「AI印钞机」,首提生成式强化学习出价技术,为平台实现超过3%的广告收入提升(在新窗口打开)
CBD 算法则是快手商业化算法团队在本月初公布的新方法,全名 Causal auto-Bidding method based on Diffusion completer-aligner,即基于扩散式补全器-对齐器的因果自动出价方法。
共 57 篇
CBD 算法则是快手商业化算法团队在本月初公布的新方法,全名 Causal auto-Bidding method based on Diffusion completer-aligner,即基于扩散式补全器-对齐器的因果自动出价方法。
2022年10月,Comfyanonymous 偶然接触到 Stable Diffusion 并深深着迷。当时这并非因为什么“让 AI 更易用” 的宏大使命,而是出于对图像生成的纯粹热爱。他最初的尝试,仅仅是想生成一位耳廓狐形象的动画角色的图片。。出于对这个想法的执着,ComfyUI 由此诞生。
Sora,可能要回来了。 The Information报道称,OpenAI正在与一家新公司谈判,商讨让后者深度使用已经停用的Sora。 而参与这场谈判的人中,正有Sora前研究负责人、DiT(Diffusion Transformer)论文第一作者Bill Peebles。 (DiT为Sora背后的核心技术,Bill Peebles在FAIR实习期间与谢赛宁共同完成) 据悉,Bill Peebles此次携新公司,希望从OpenAI获得对Sora更深入的使用权限,从而进一步开发、定制面向电影制作人的软件和服务。 为此,Bill还拉来了两位重量级合作伙伴:一位是梦工厂动画联合创始人、前迪士尼影业
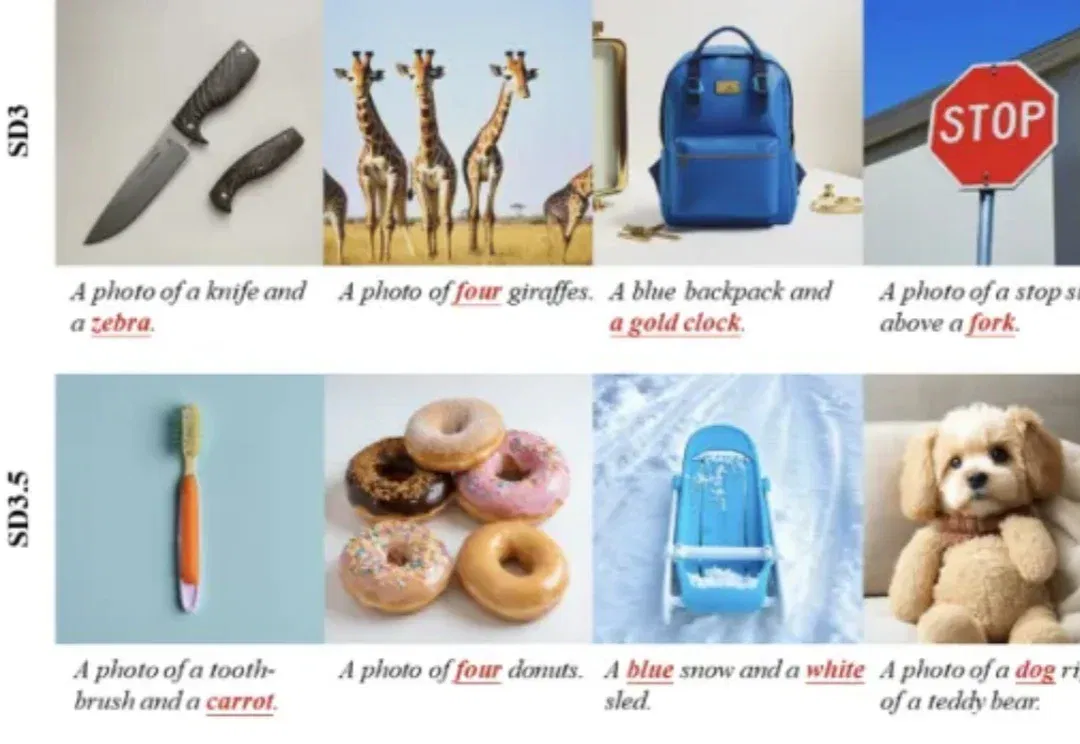
近年来,文生图模型的能力快速提升。从 Stable Diffusion 到 FLUX、Qwen-Image,扩散模型已经能够生成高质量图像,也能处理越来越复杂的文本提示。
何恺明,也下场做语言模型了。 只不过,这次他带队做的不是大家熟悉的、像ChatGPT背后那套“预测下一个词元”(next token prediction)的自回归范式。 而是另一条过去几年在图像领域大火、如今正被越来越多人搬进文本生成的新路线:扩散语言模型(Diffusion Language Model,DLM)。 在最新的论文中,何恺明团队放出全新连续扩散语言模型:ELF:Embedded Language Flows。 与不少还停留在token层面做扩散的语言模型不同,ELF把整个生成过程都留在了连续的embedding空间里,直到最后一步,才重新离散化,将表示变回token。 靠着这
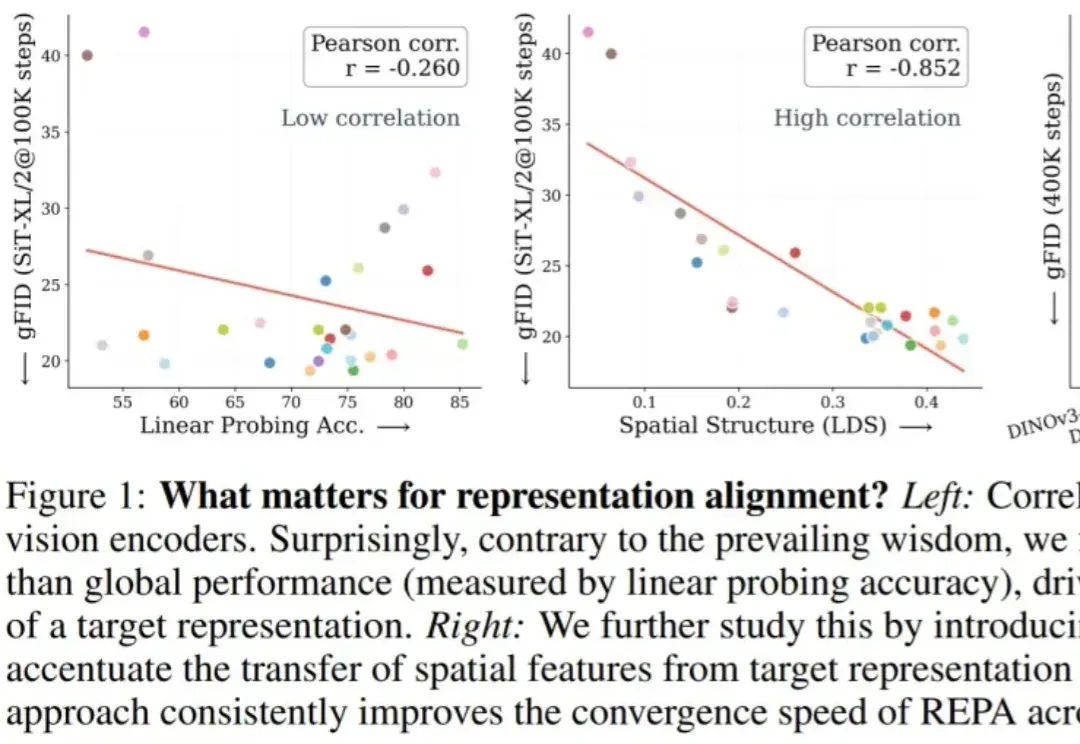
邹忌曾经有一个问题:吾与徐公孰美? 而对于 REPA,也有一个类似的问题:全局信息与空间结构,哪个对表征对齐更重要? 表征对齐(REPA)可通过将强大的预训练视觉编码器的表征蒸馏为中间扩散特征,来指导生成式训练。该方法于去年十月份问世,一直以来都备受关注,已成为加速扩散 Transformer(Diffusion Transformers)训练的一项有力技术。参阅报道《扩散模型训练方法一直错了!谢赛宁:Representation matters》。 但是,其还有一个很基本的问题悬而未决:对生成而言,目标表征的哪个方面更重要?是其「全局」语义信息(例如,以 ImageNet-1K 准确率衡量)
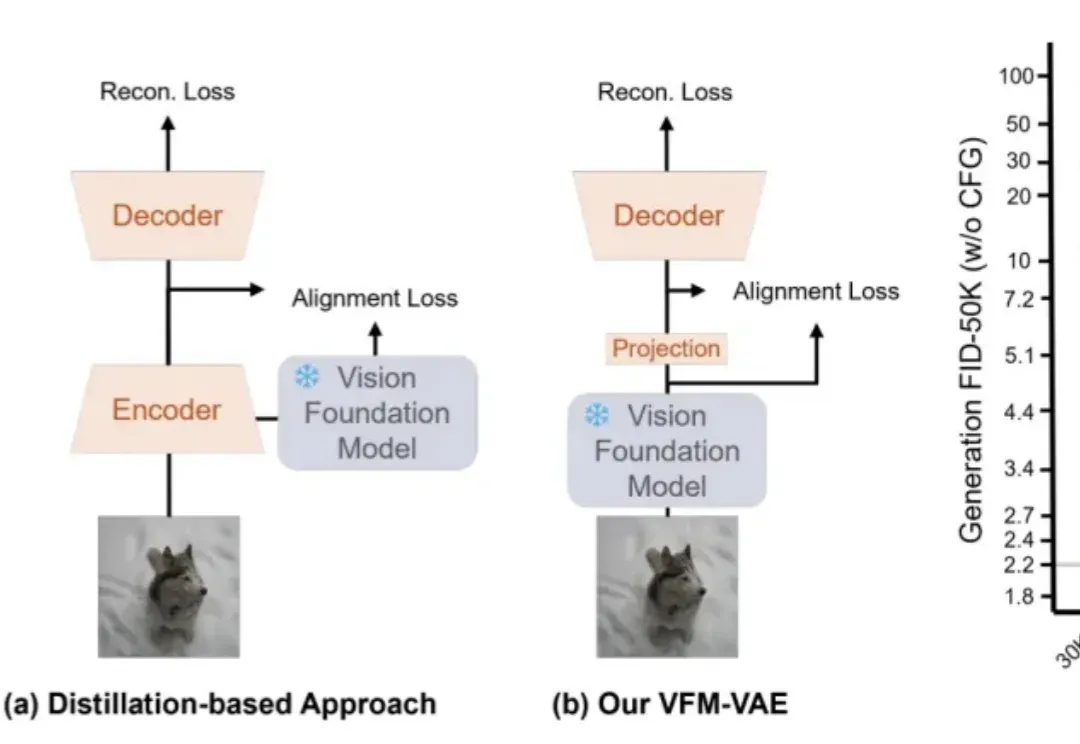
近期,RAE(Diffusion Transformers with Representation Autoencoders)提出以「 冻结的预训练视觉表征」直接作为潜空间,以显著提升扩散模型的生成性能。
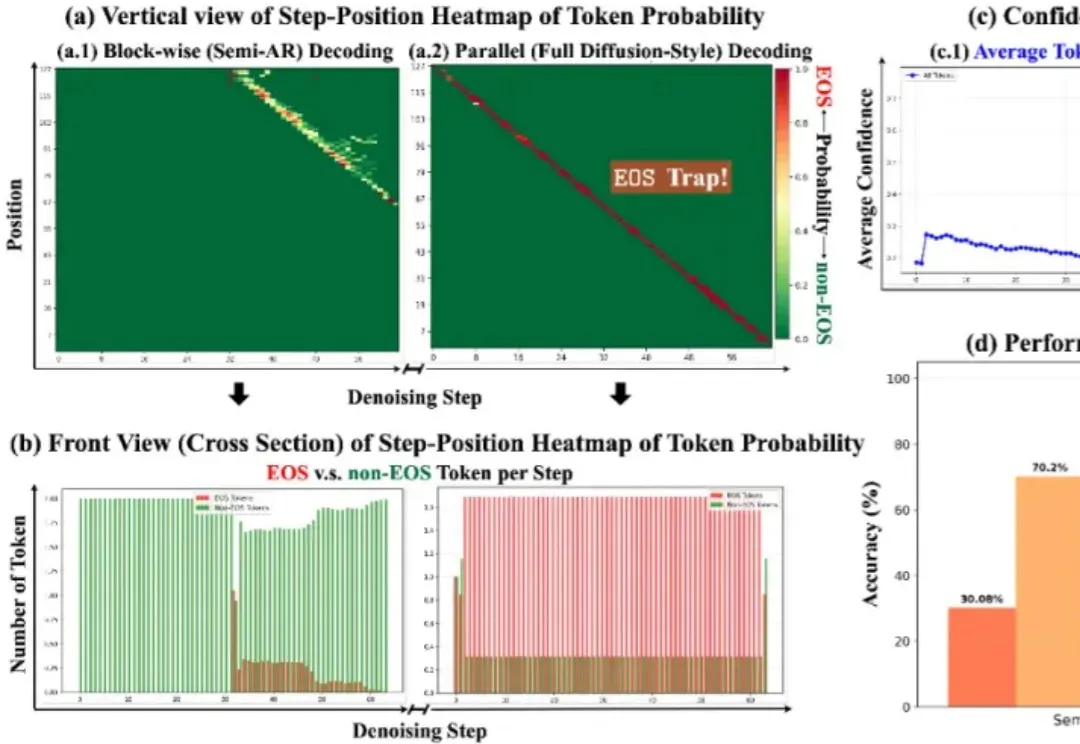
扩散大语言模型得到了突飞猛进的发展,早在 25 年 2 月 Inception Labs 推出 Mercury—— 第一个商业级扩散大型语言模型,同期人民大学发布第一个开源 8B 扩散大语言模型 LLaDA,5 月份 Gemini Diffusion 也接踵而至。
高通提前剧透下一代骁龙旗舰移动平台的核心升级:Oryon CPU首次实现5GHz主频并引入动态缓存架构FlexCache,Hexagon NPU推出Element Accelerator与更大共享内存,Adreno GPU首次加入Matrix Cores并集成AI图形渲染技术Adreno Neural Fusion,全面强化端侧智能体AI性能与体验。
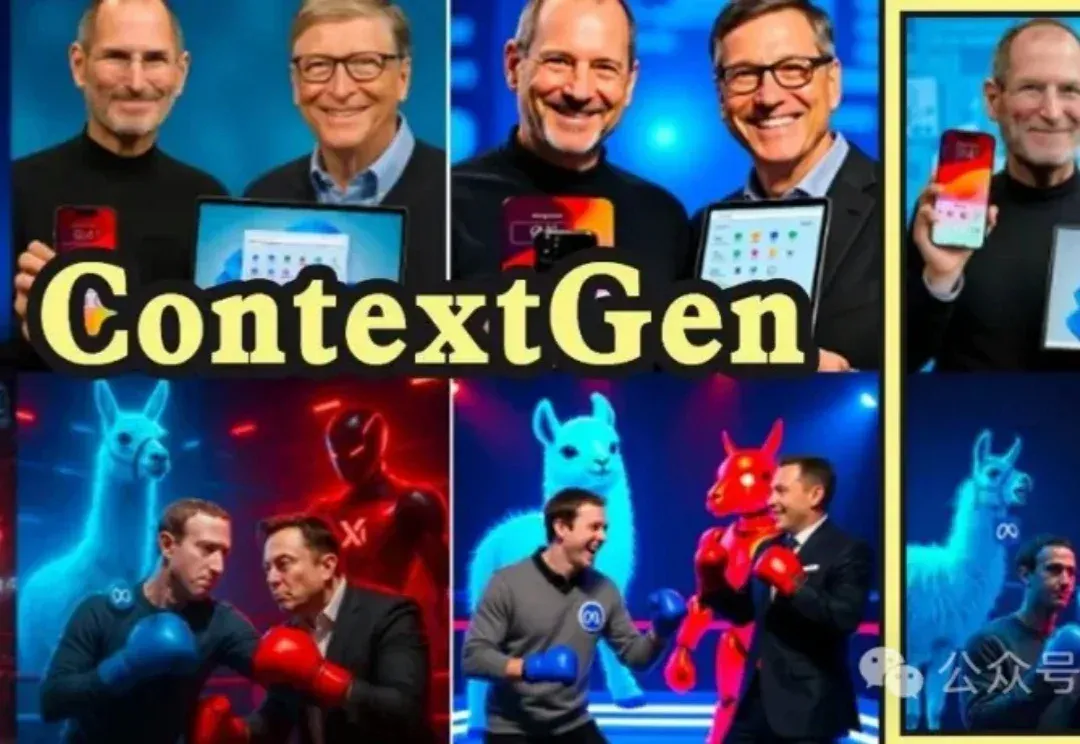
浙江大学ReLER团队开源ContextGen框架,攻克多实例图像生成中布局与身份协同控制难题。基于Diffusion Transformer架构,通过双重注意力机制,实现布局精准锚定与身份高保真隔离,在基准测试中超越开源SOTA模型,对标GPT-4o等闭源系统,为定制化AI图像生成带来新突破。