这年头学不会数理化,只能怪自己懒,谷歌NotebookLM上新,秒出科普视频(在新窗口打开)
最近,谷歌 NotebookLM 又出了个好玩好用的小功能:Cinematic Video Overviews(电影级视频概览)。与普通模板不同,这项功能可以根据我们上传的资料,自动生成定制化、沉浸式的视频讲解。
共 27 篇
最近,谷歌 NotebookLM 又出了个好玩好用的小功能:Cinematic Video Overviews(电影级视频概览)。与普通模板不同,这项功能可以根据我们上传的资料,自动生成定制化、沉浸式的视频讲解。
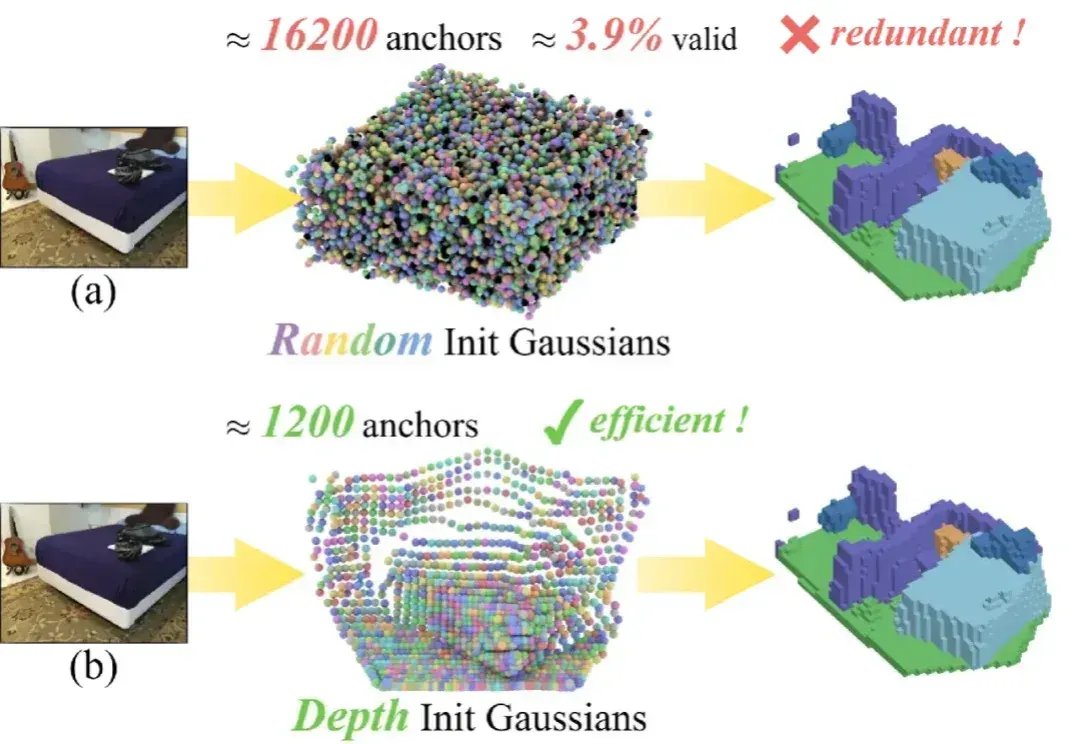
单目 3D 语义场景补全 (Semantic Scene Completion, SSC) 是具身智能与自动驾驶领域的一项核心技术,其目标是仅通过单幅图像预测出场景的密集几何结构与语义标签。
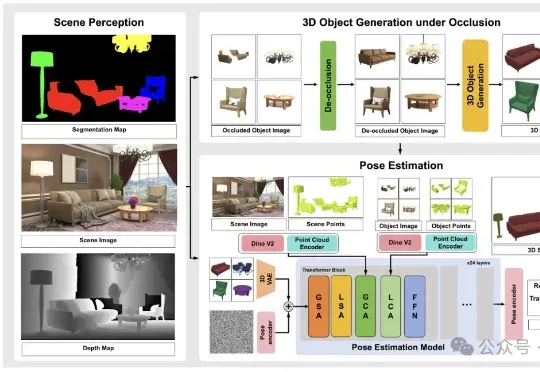
IDEA研究院张磊团队与香港科技大学谭平团队联合推出SceneMaker框架,有望攻克这一问题。 它以视启未来的万物检测模型DINO-X与光影焕像的万物3D生成模型Triverse为基础,实现了从任意开放世界图像(室内/室外/合成图等)到带Mesh的3D场景的完整重建。
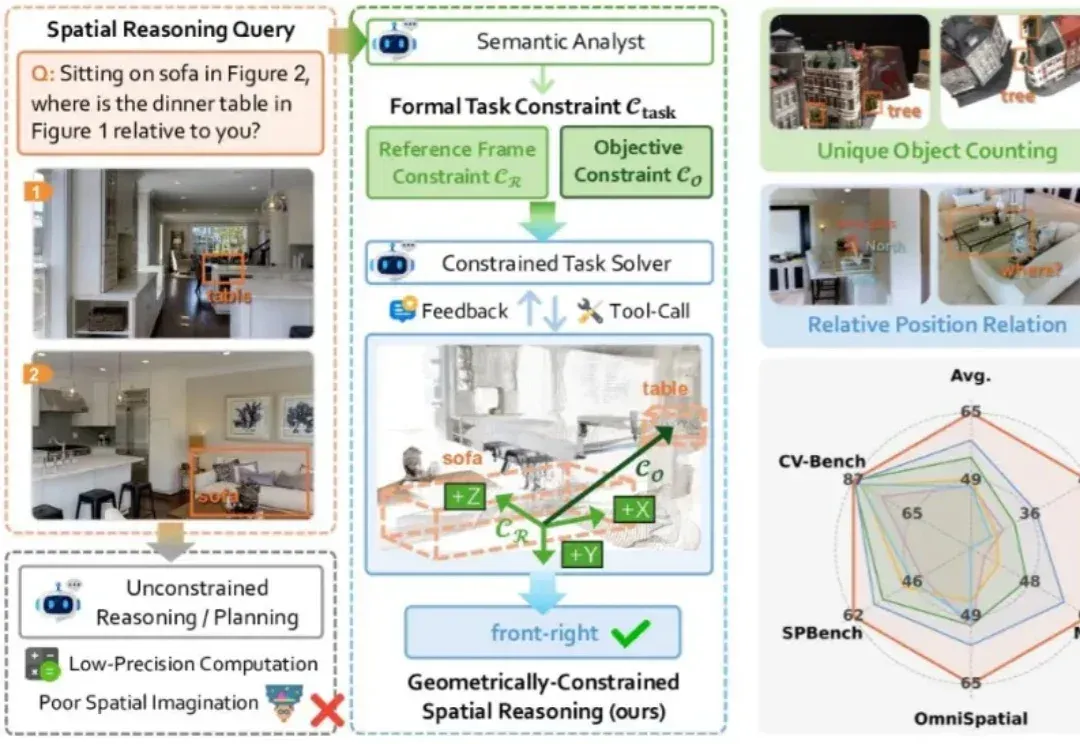
现有的视觉大模型普遍存在「语义-几何鸿沟」(Semantic-to-Geometric Gap),不仅分不清东南西北,更难以处理精确的空间量化任务。例如问「你坐在沙发上时,餐桌在你的哪一侧?」,VLM 常常答错。
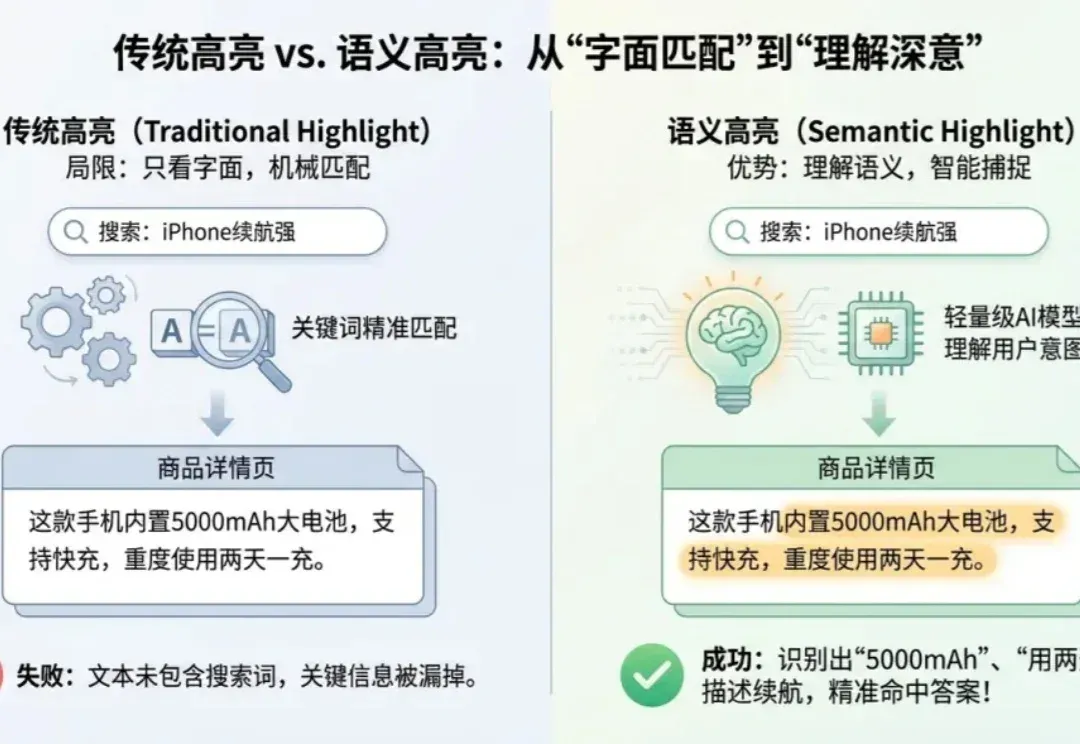
今天聊一聊怎么在RAG、agent场景中实现语义高亮(Semantic Highlight)。
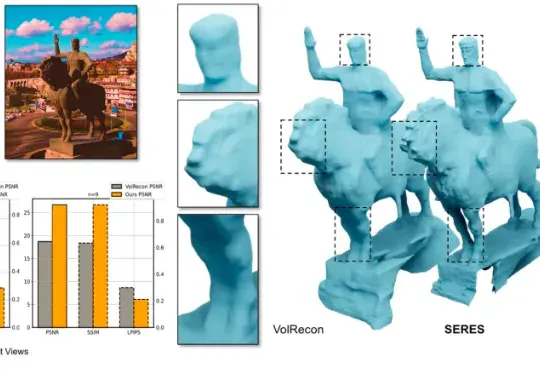
直观经验却告诉我们,只要把同一物体的 “对应部分” 对齐,形状就会变得清晰。基于这一朴素而有效的直觉,作者提出SERES(Semantic-Aware Reconstruction from Sparse Views),在不改动主干框架的前提下,把跨视角的语义一致性变成一种训练期先验注入到模型里,用低成本的方法去解决高价值的歧义问题,让少量视角也能得到清晰而完整的几何。
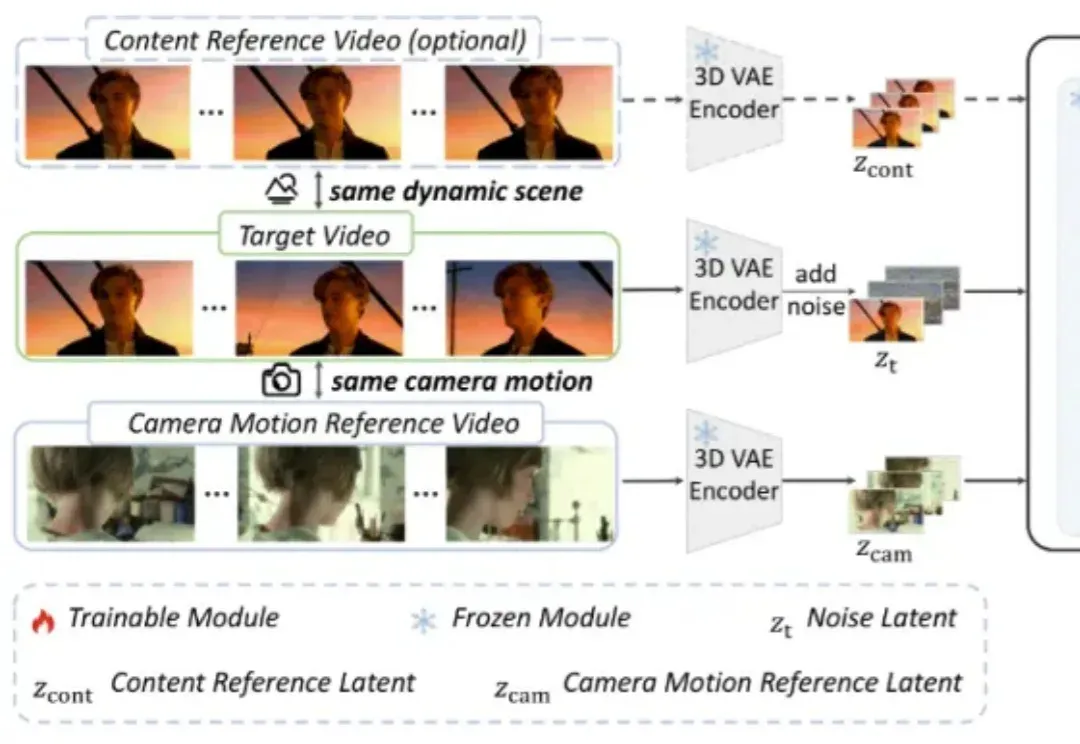
作为视频创作者,你是否曾梦想复刻《盗梦空间》里颠覆物理的旋转镜头,或是重现《泰坦尼克号》船头经典的追踪运镜?