特斯拉OpenAI数据路线遇挫!8千平具身「兵工厂」+ego众包狂飙(在新窗口打开)
质量和成本只能二选一?通过大脑+小脑分层、场内+场外双轮驱动,数据堂给出了具身智能数据难题的解。
共 29 篇
质量和成本只能二选一?通过大脑+小脑分层、场内+场外双轮驱动,数据堂给出了具身智能数据难题的解。
Reducto 在去年 6 个月内接连完成分别由 Benchmark 与 a16z 领投的两轮融资,估值翻了 3 倍,达到 6 亿美元。我们认为,Reducto 切中了 AI 应用走向生产环境过程中的“精确数据摄取”瓶颈。
Meta联合多所高校发布首个可规模化自动生成第一视角音视频理解数据的引擎EgoAVU ,让多模态大模型首次真正「听懂世界」。
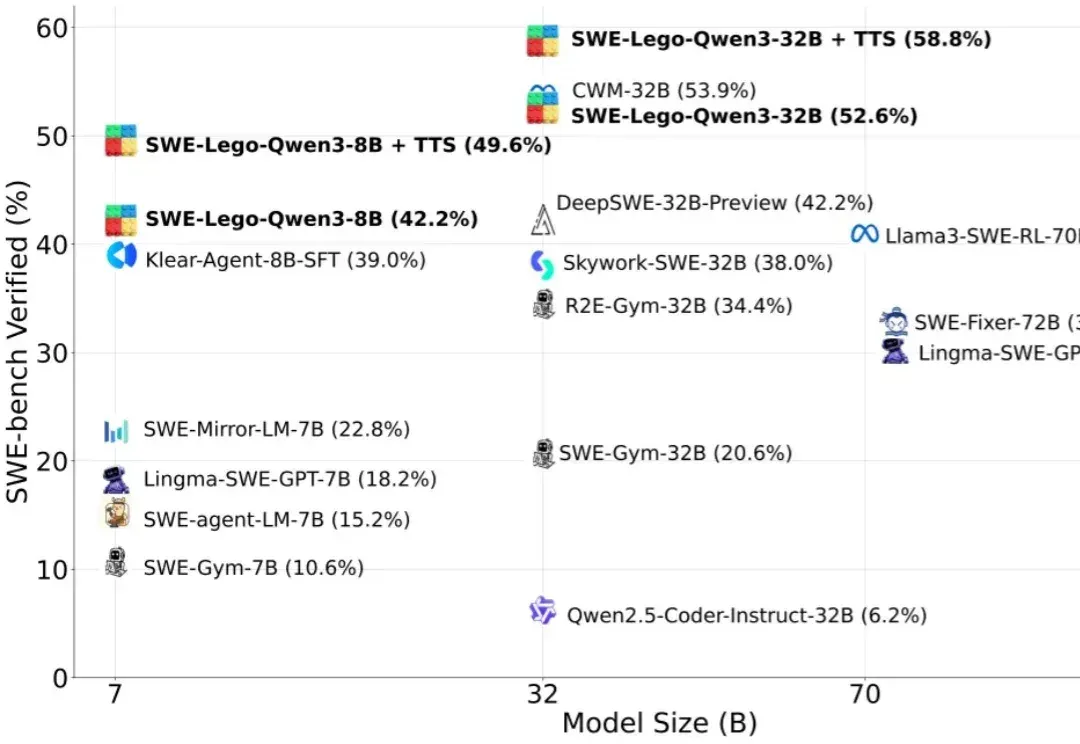
“软工任务要改多文件、多轮工具调用,模型怎么学透?高质量训练数据稀缺,又怕轨迹含噪声作弊?复杂 RL 训练成本高,中小团队望而却步?”
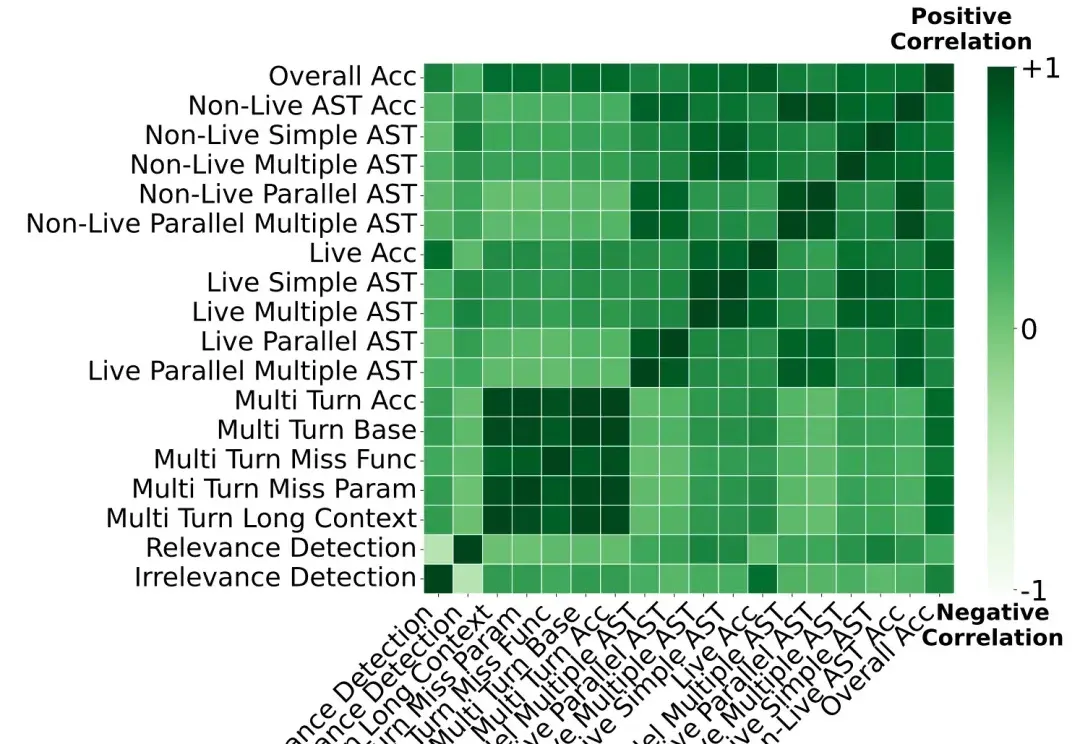
模型也要学会取长补短。 大语言模型(LLM)在众多领域展现出卓越的能力,但它们的训练依然高度依赖算力和时间,需要庞大的计算资源以及精细的训练流程设计。 模型 Souping(Model Souping) ,即对同一架构的多个模型进行权重平均,形成一个新的、更强的模型。相比训练一个庞大的统一模型,souping 更轻量、成本更低,同时能够融合模型的互补能力。 然而,传统的模型 souping 方式通常采用简单的均匀平均,即把所有候选模型的参数直接做等权融合。 本文中,来自 Meta、伦敦大学学院机构的研究者提出类专家 Soup(Soup Of Category Experts, SoCE),这是
大型语言模型(LLMs)正迅速成为从金融到交通等各个专业领域不可或缺的辅助决策工具。但目前LLM的“通用智能”在面对高度专业化、高风险的任务时,往往显得力不从心。
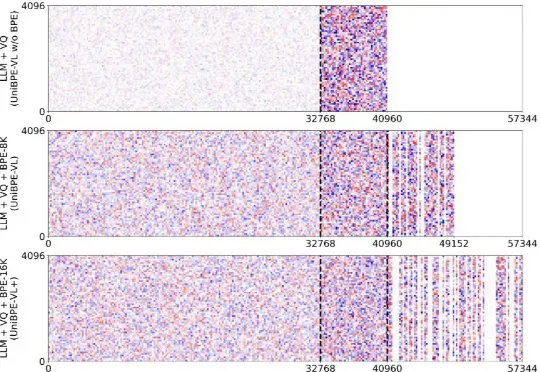
为此,北大、UC San Diego 和 BeingBeyond 联合提出一种新的方法——Being-VL 的视觉 BPE 路线。Being-VL 的出发点是把这一步后置:先在纯自监督、无 language condition 的设定下,把图像离散化并「分词」,再与文本在同一词表、同一序列中由同一 Transformer 统一建模,从源头缩短跨模态链路并保留视觉结构先验。
AI生成第三视角视频已经驾轻就熟,但第一视角生成却仍然“不熟”。为此,新加坡国立大学、南洋理工大学、香港科技大学与上海人工智能实验室联合发布EgoTwin ,首次实现了第一视角视频与人体动作的联合生成。
本周,我们关注 Agent 与工业结合正在发生的变化,我们邀请研发时序大模型 Geegobyte-g1 以及工业智能体平台「河谷」的初创企业极峰科技的创始人王筱圃,和我们聊一聊什么是时序大模型,和大语言模型的区别和具体的案例,他们如何训练一个 Agent 并把它卖给企业投入到生产流程中。希望能对大家了解 AI Agent 如何应用于工业生产有所帮助。