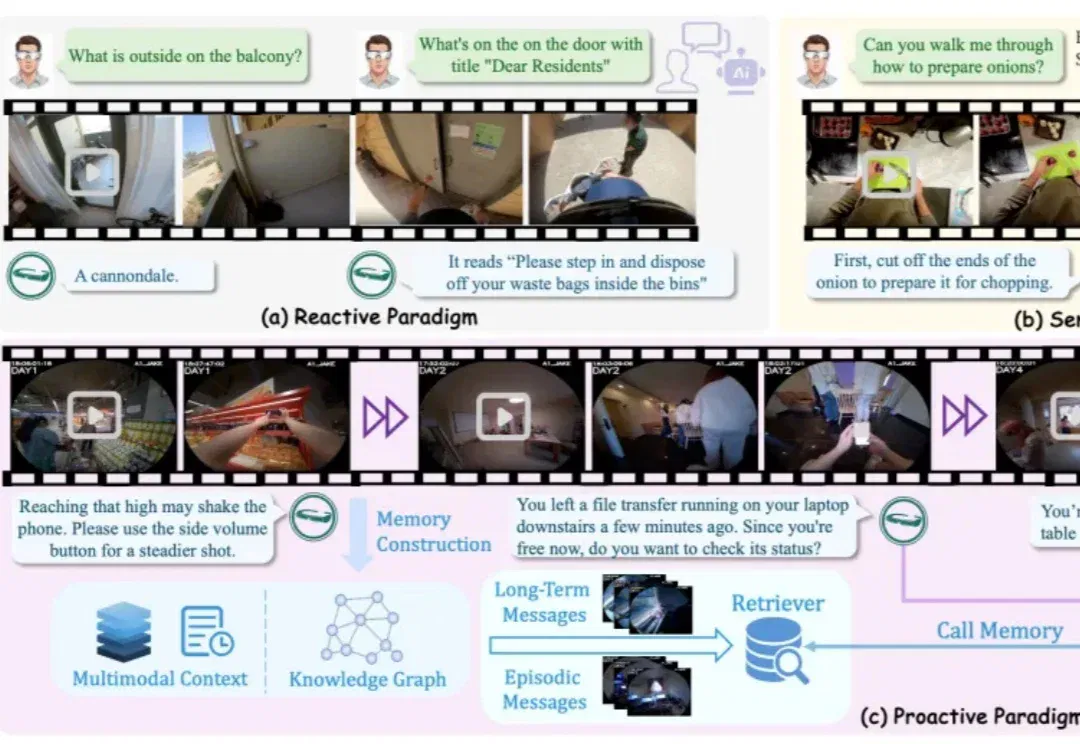
ECCV 2026 | 智能助手何时该主动开口?Vinci2让第一视角AI助手从「有问必答」走向「主动服务」(在新窗口打开)
请想象这样一种居家场景:当你戴着 AI 眼镜在厨房准备晚饭,用刀切菜时,它会立刻提醒你注意安全;当你连续几天形成举着手机长时间录像的习惯时,它会主动建议你换一种更省力的记录方式。
共 34 篇
请想象这样一种居家场景:当你戴着 AI 眼镜在厨房准备晚饭,用刀切菜时,它会立刻提醒你注意安全;当你连续几天形成举着手机长时间录像的习惯时,它会主动建议你换一种更省力的记录方式。
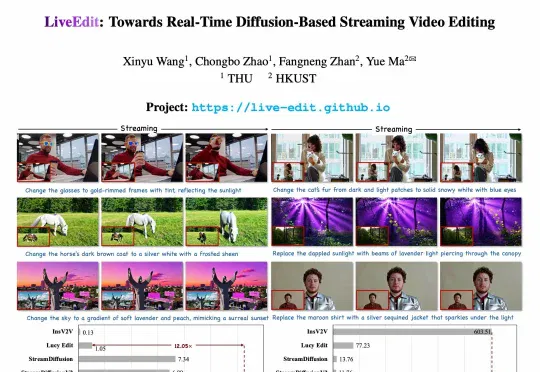
近日,清华大学与香港科技大学的研究团队提出 LiveEdit,一种面向通用文本指令的实时流式视频编辑框架。该方法以因果、分块的方式处理持续到来的视频,在 4 步 / 视频块的推理条件下实现 12.66 FPS 的流式编辑,并能保持被编辑区域的准确性以及未编辑区域的一致性。
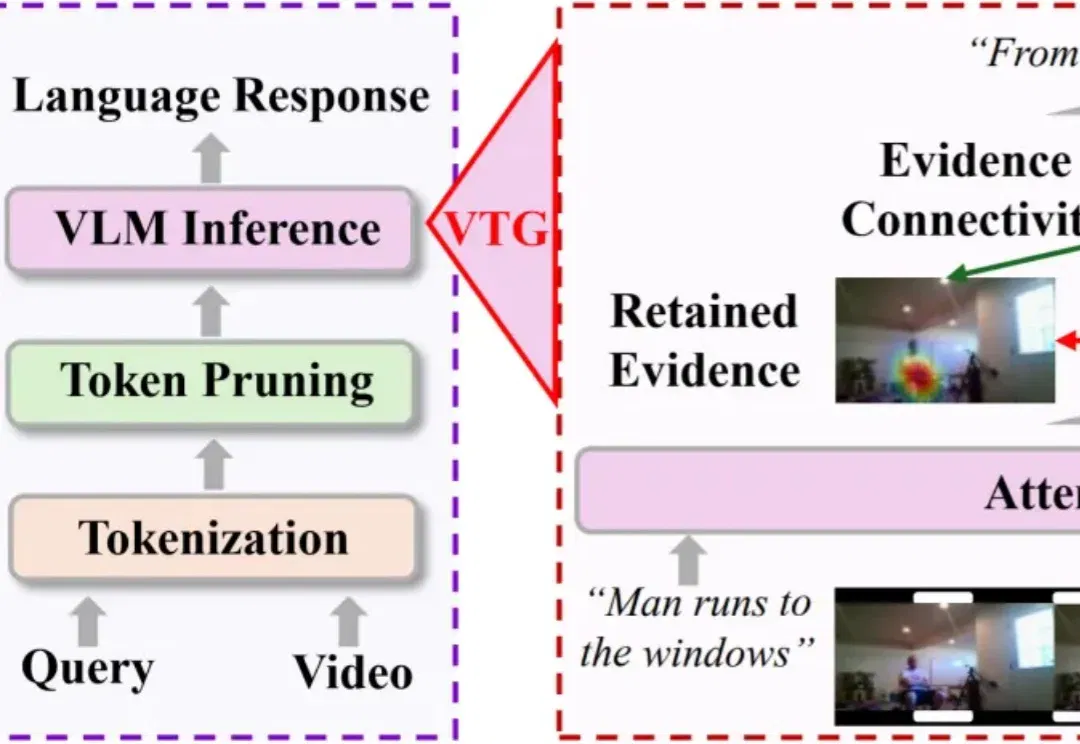
长视频理解,正在成为多模态大模型的重要能力。
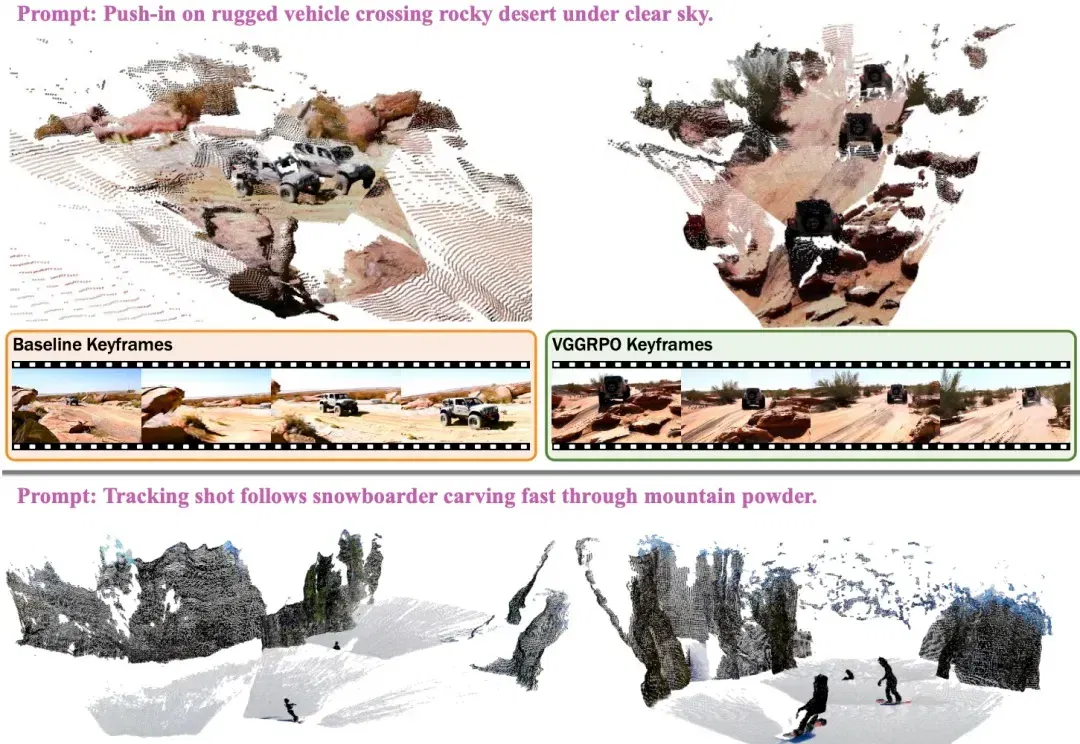
大规模视频扩散模型,画面越来越真,却总在“物理定律”上栽跟头。
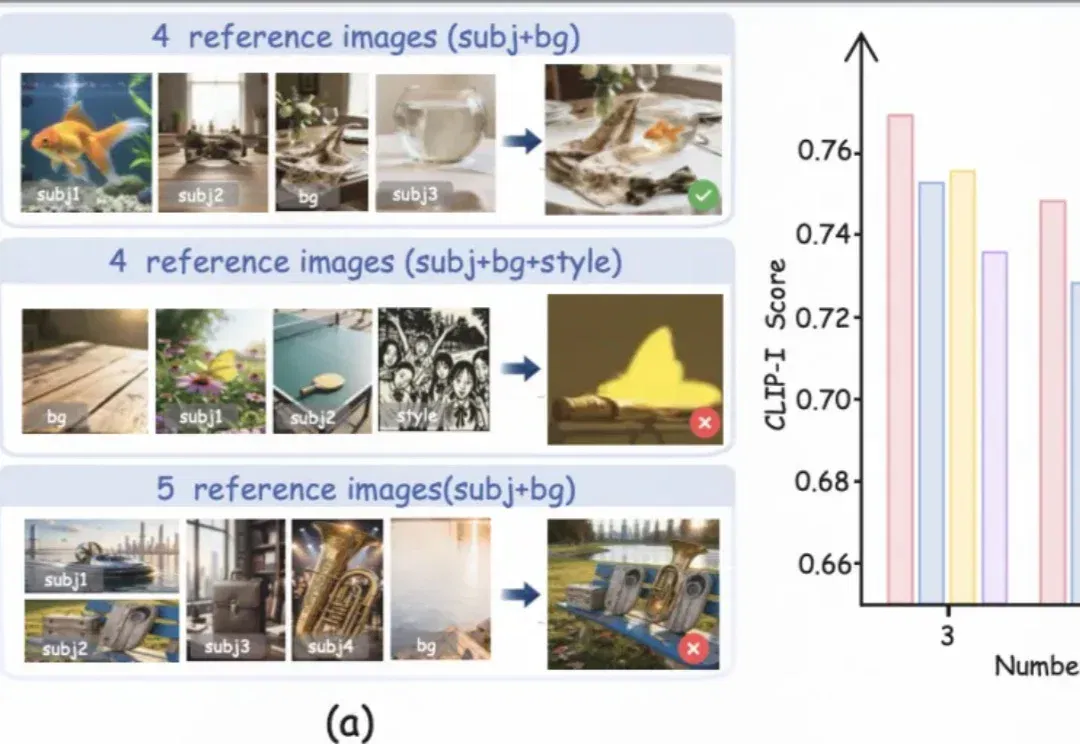
给图像生成模型一张人物参考图,它大概率能抓住身份特征。
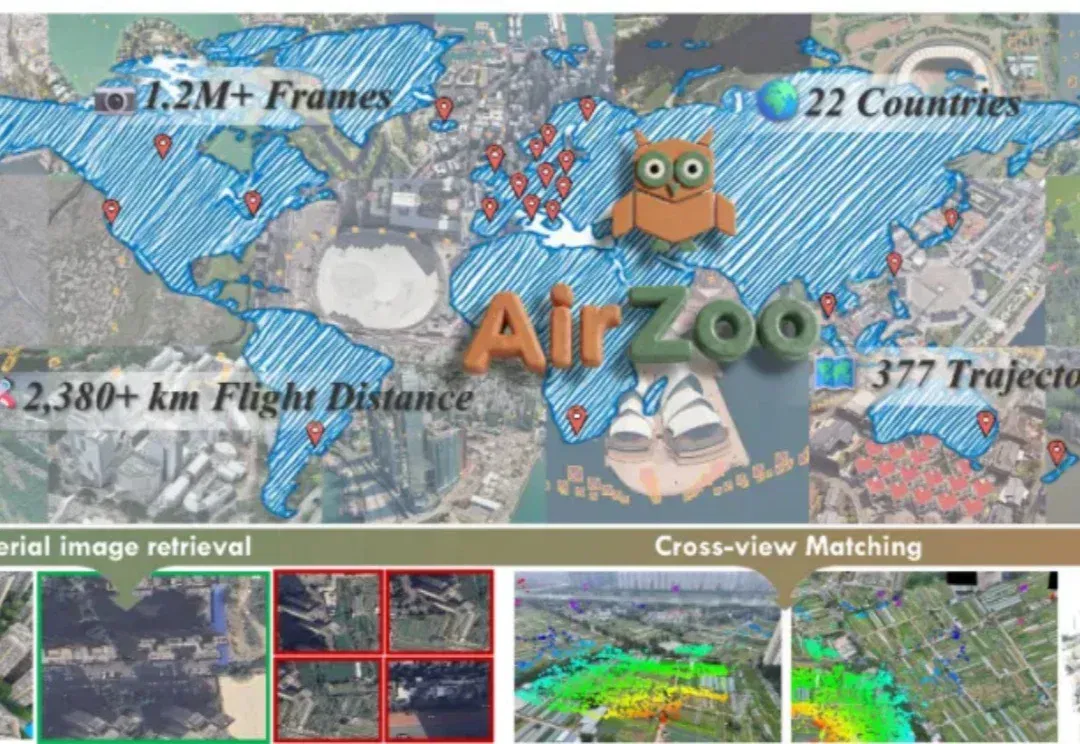
国防科技大学虚拟现实与视觉计算团队(SAW Lab)联合先进制导与控制技术国家级重点实验室等推出面向航拍几何 3D 视觉的统一大规模数据集与评测基准 「AirZoo」。
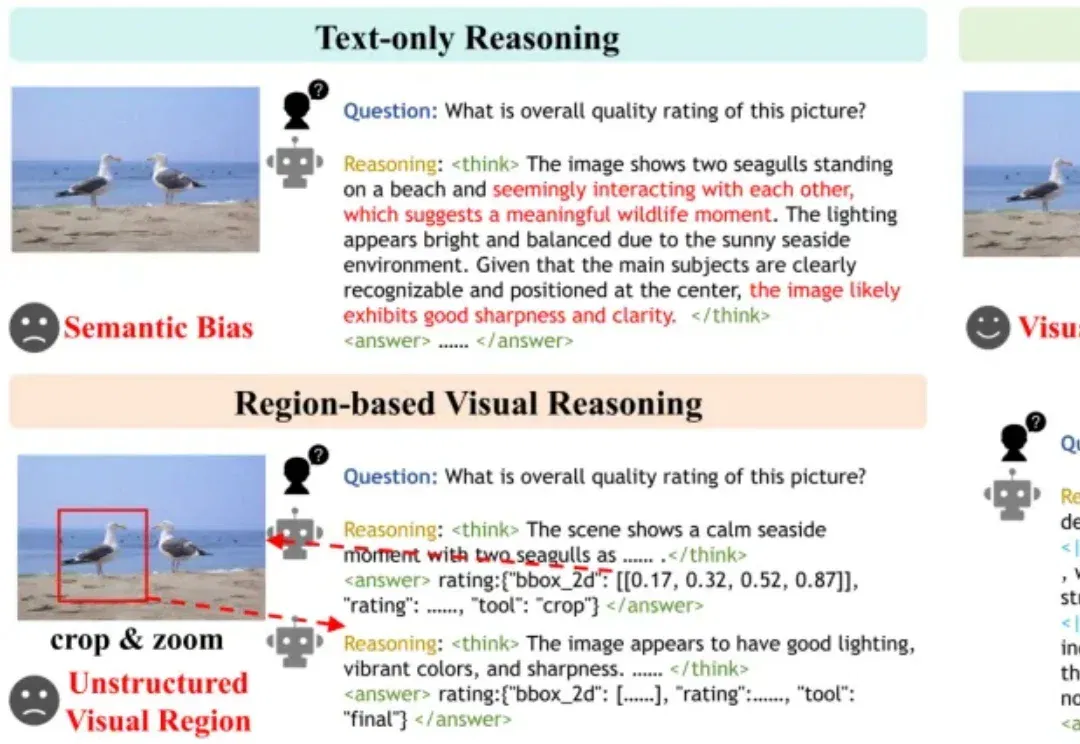
让大模型给一张图片打“质量分”,它其实经常看走眼。
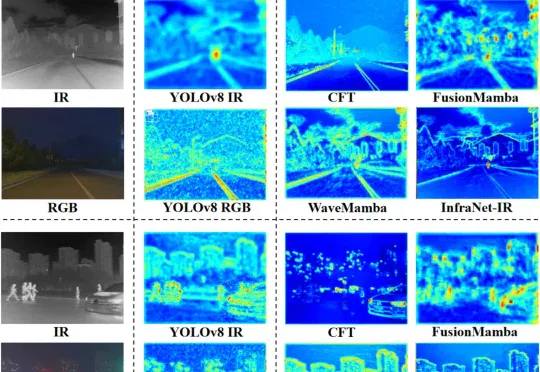
在讨论 RGB-IR 目标检测时,「两种模态互补」几乎是默认前提。RGB 擅长保留纹理和颜色,红外图像在弱光条件下更稳定,于是最直接的路线是搭建双分支网络,让它们在中间层不断交换信息。InfraNet 的出发点却来自一个不太符合这一直觉的现象。
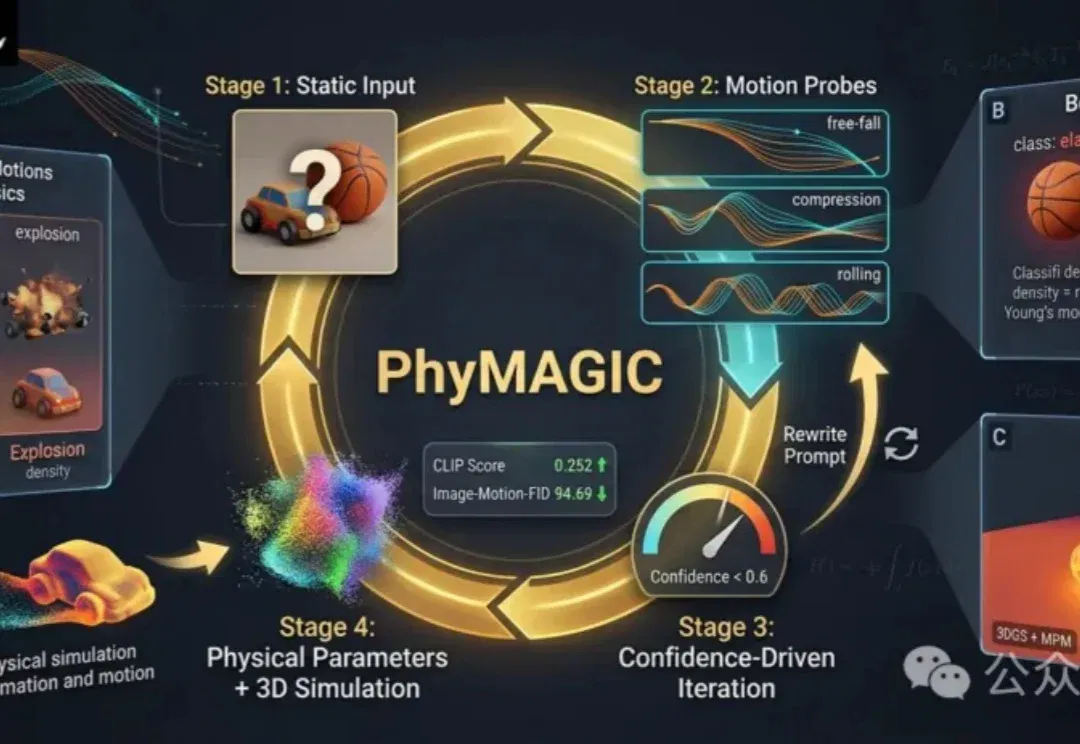
PhyMAGIC通过让物体动起来,从视频中提取物理证据,帮助准确推断材料属性。它结合图生视频与视觉语言模型,生成针对性运动探针,并不断修正物理参数,最终构建出可微分的3D动态模型,实现更符合现实的视频生成。
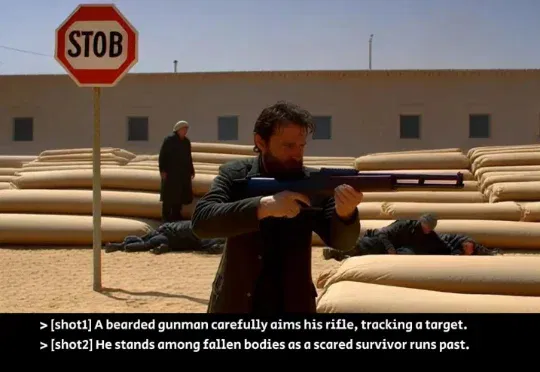
为了打破多镜头长视频面临的高延迟、零交互困境,香港中文大学与快手可灵团队联合提出了首个实时流式多镜头长视频生成框架 ——ShotStream。该研究打破了传统双向架构的限制,将多镜头合成定义为基于历史上下文的下一镜头生成任务,用户可以通过动态流式提示词在运行时动态指导叙事走向!更令人振奋的是