Agent科研「Taste」距离顶会作者有多远?斯坦福提出ScholarCatalyst,直指自主科研短板(在新窗口打开)
ScholarCatalyst 汇集184位作者对207项研究的灵感标注,评测系统能否找回真正有启发的论文。主实验最佳检索器的前20篇召回率约48%,多轮 Agent 搜索未超过它;候选覆盖和排序是重要瓶颈,这一指标也不能等同整体科研能力。
共 76 篇
ScholarCatalyst 汇集184位作者对207项研究的灵感标注,评测系统能否找回真正有启发的论文。主实验最佳检索器的前20篇召回率约48%,多轮 Agent 搜索未超过它;候选覆盖和排序是重要瓶颈,这一指标也不能等同整体科研能力。
量子位援引报道介绍 Cathedral 通过第三方办公软件开展的外部安全测试。Anthropic 称受影响的是部分销售、人事和 IT 系统,并表示用户聊天、核心代码及模型权重未被触及;双方对测试规则和报告表述存在分歧。
8月18日,一篇系统梳理单细胞基础模型的综述预印本挂上 Preprints.org(doi:10.20944/preprints202608.1166.v1),标题是《The Landscape of Single-Cell Foundation Models: Design Principles, Applications, and Open Challenges》,尚未经过同行评审。
「抓紧转型世界模型」 「同志们朋友们,版本回调了! 搞AI应用的家人们没活了。胜利女神的天平又一次倾向了大模型公司一边。有鉴于此,我们将复刻致敬葬AI一年前的系列——把模型公司挨个写一遍。 之前已经写过了Kimi、智谱、豆包、千问和百度,发现一个问题是二线模型写少了,于是紧急加入美团、小米、腾讯等一众转型中的公司,更多模型公司敬请期待😘」 理论上不该写美团的,因为如果美团是大模型公司,那显然股价不会被一直按在地上摩擦。 不过既然美团LongCat 2.0发布,且大炒特炒了一番,甚至都有人说美团LongCat 2.0是「国芯国模的张雪时刻」。典型的拼词组拼麻了,那我就去认真复盘下美团都搞了哪些
7月27日,美团正式上线了CatPaw,一个全场景AI Agent平台。准确说,是「内部练了三年,现在放出来给所有人用」。
有知情人士透露,美团LongCat团队基础模型负责人裴鹏即将离职。公开资料显示,裴鹏毕业于北京大学,长期深耕信息检索与自然语言处理方向,职业履历覆盖多家全球顶尖科技企业。
美团今日宣布开源万亿参数大模型LongCat-2.0,同步开放针对国产算力芯片深度优化的推理代码。该模型总参数达1.6万亿,平均激活约480亿参数,是业界首个在五万卡国产算力集群上完成全流程训练与推理的万亿参数模型。
上个月也就是昨天,我写了一篇LongCat 2.0的实测,用四个任务测了一下它的编程能力,当时我的评价是「有些地方惊艳,有些地方还差点意思」。
相似度超越Seed-TTS、MiniMax-Speech等知名模型。昨晚,美团LongCat团队发布了文本转语音模型LongCat-AudioDiT,并开源1B、3.5B参数量的版本。这一模型的最大特点,是彻底抛弃了梅尔谱等中间表示,直接在波形潜空间进行基于扩散模型的文本转语音。通俗地说,这一模型直接根据声音本身的规律进行生成,“雕刻”出最原始的声音波形,从根源阻断数据转换的级联误差。
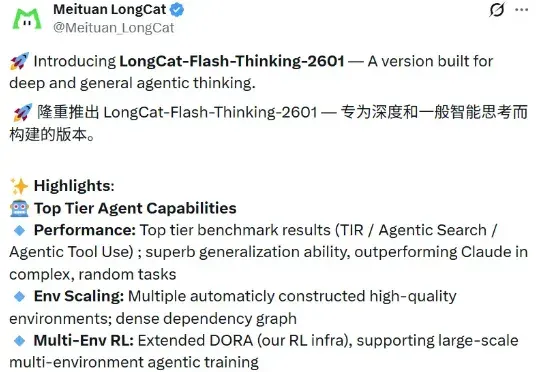
美团也重磅更新自家模型 ——LongCat-Flash-Thinking-2601。这是一款强大高效的大规模推理模型,拥有 5600 亿个参数,基于创新的 MoE 架构构建。该模型引入了强大的重思考模式(Heavy Thinking Mode),能够同时启动 8 路思考并最终总结出一个更全面、更可靠的结论。目前重思考模式已在 LongCat AI 平台正式上线,人人均可体验。