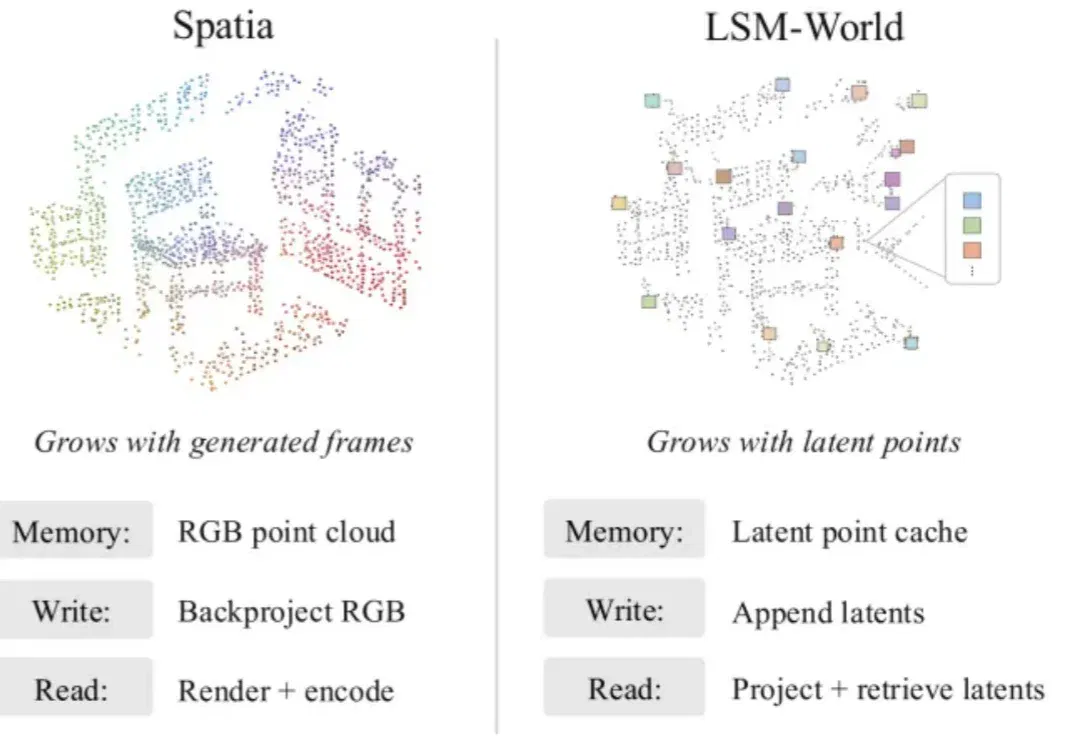
当视频模型回到原点,它还认得这里吗?Honeycomb用恒定大小记忆守住长视频的一致性(在新窗口打开)
让视频生成模型沿着相机轨迹不断探索一个场景,并不算最难。真正困难的是:当镜头绕了一圈再次回到原点,房间的布局、家具的位置和墙面的纹理,是否还与最初一样?
共 37 篇
让视频生成模型沿着相机轨迹不断探索一个场景,并不算最难。真正困难的是:当镜头绕了一圈再次回到原点,房间的布局、家具的位置和墙面的纹理,是否还与最初一样?
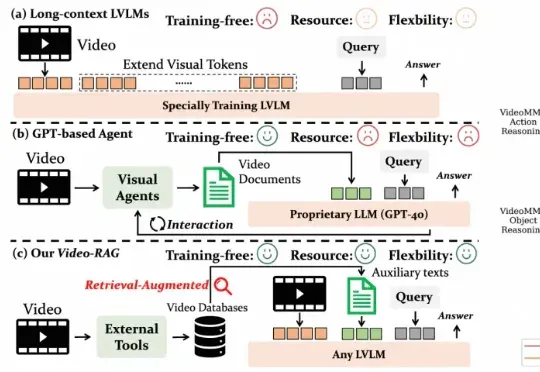
尽管视觉语言模型(LVLMs)在图像与短视频理解中已取得显著进展,但在处理长时序、复杂语义的视频内容时仍面临巨大挑战 —— 上下文长度限制、跨模态对齐困难、计算成本高昂等问题制约着其实际应用。针对这一难题,厦门大学、罗切斯特大学与南京大学联合提出了一种轻量高效、无需微调的创新框架 ——Video-RAG。
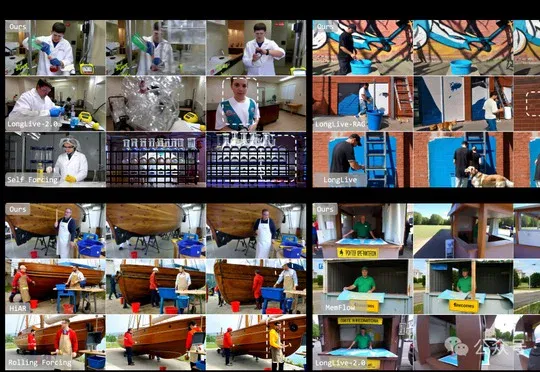
浙大与港大团队开源轻量化记忆路由器LayerRecall,通过选择性检索历史记忆并仅注入对长程信息敏感的特定DiT层,解决长视频生成中角色离场再返回时身份与属性丢失的问题,在MemoBench和MovieBench评测中取得Overall第一,且约6.6MB的路由权重可零再训练迁移至其他视频生成骨干。
过去三年,AI 内容生成行业经历了几轮密集的技术迭代。从文生图到文生视频,从几秒的短片到分钟级的长视频,每一轮升级都让生成内容的质量和时长向前推进一步。
OpusClip 是一款把长视频、长内容自动剪成可发布的短视频片段的 AI 工具,服务内容创作者和企业内容团队。
视频生成模型总是「记性不好」?生成几秒钟后物体就变形、背景就穿帮?北大、中大等机构联合发布EgoLCD,借鉴人类「长短时记忆」机制,首创稀疏KV缓存+LoRA动态适应架构,彻底解决长视频「内容漂移」难题,在EgoVid-5M基准上刷新SOTA!让AI像人一样拥有连贯的第一人称视角记忆。
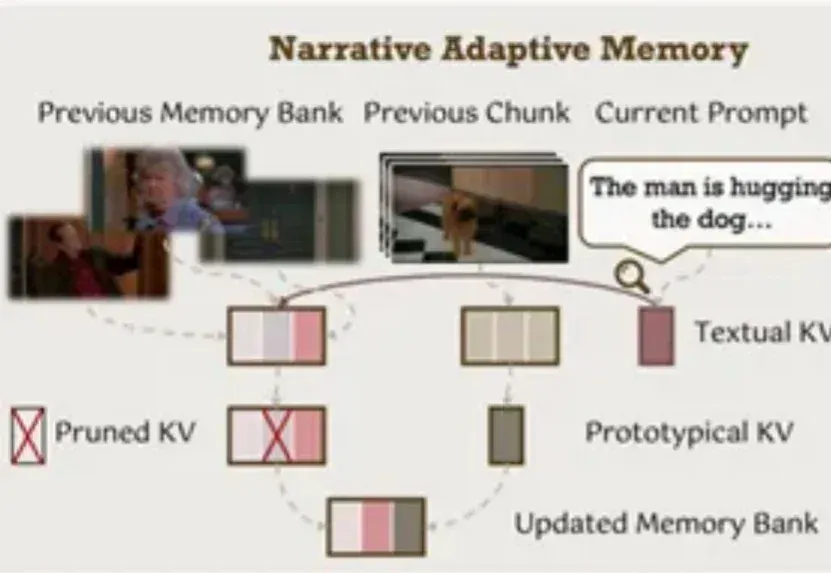
你是否曾被AI视频生成的不连贯性所困扰?
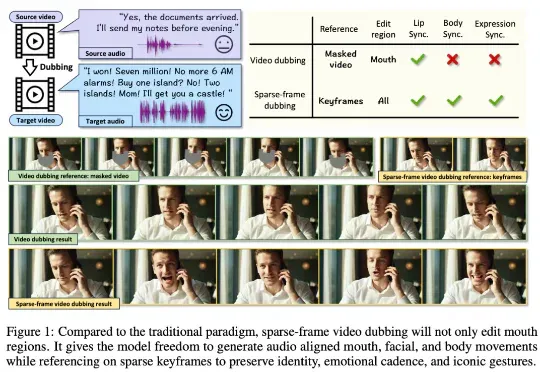
传统 video dubbing 技术长期受限于其固有的 “口型僵局”,即仅能编辑嘴部区域,导致配音所传递的情感与人物的面部、肢体表达严重脱节,削弱了观众的沉浸感。现有新兴的音频驱动视频生成模型,在应对长视频序列时也暴露出身份漂移和片段过渡生硬等问题。
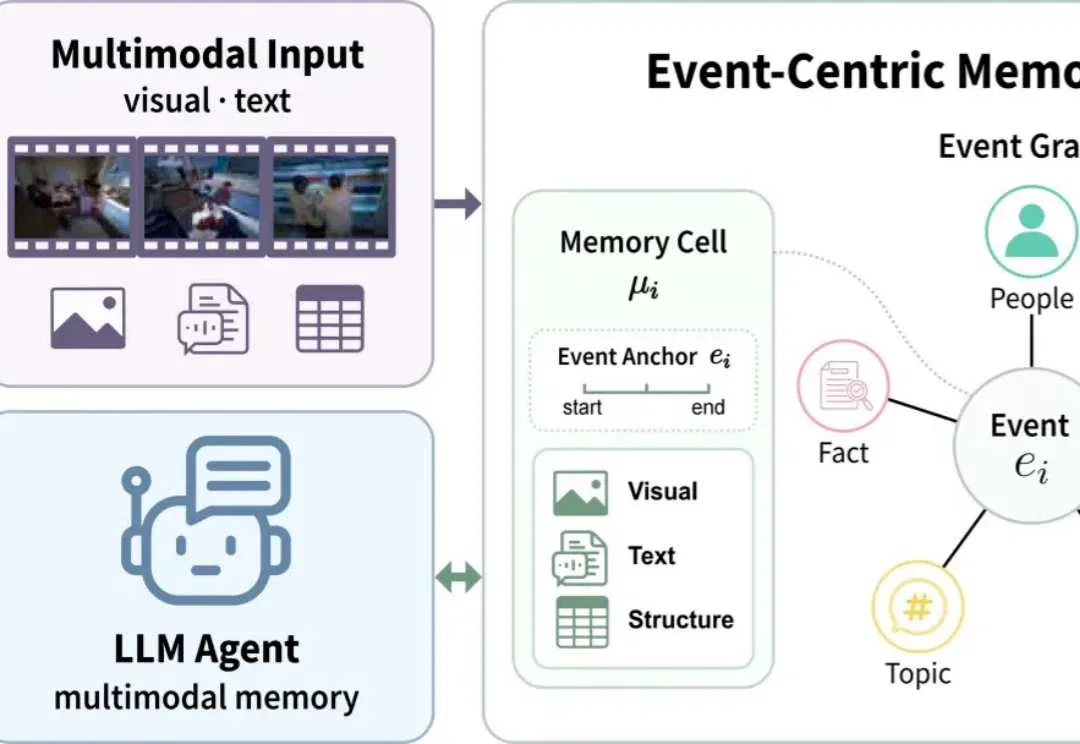
浙大与联想团队把跨模态对齐提前到记忆构建,测试长视频问答和证据定位;查询更轻,但需计入前期构建开销。
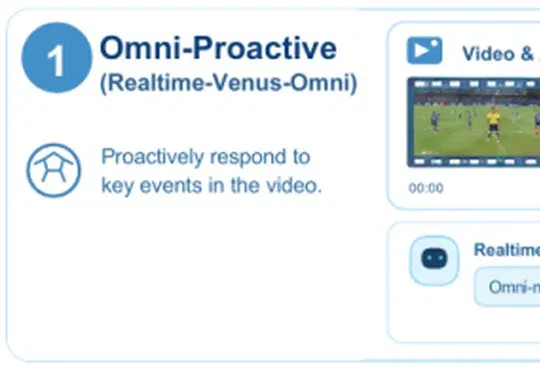
蚂蚁AI安全实验室与清华大学人机交互实验室联合开源9B模型Realtime-Venus,通过配套的Harness打通前后台,使AI助手在执行后台任务的同时能继续与用户对话,并在长视频问答等多项评测中取得领先成绩。