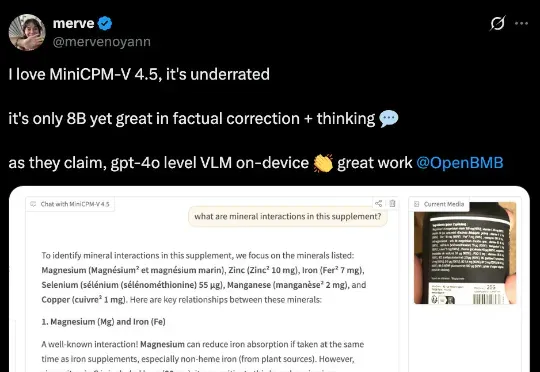
8B硬刚72B!MiniCPM-V 4.5技术报告正式出炉(在新窗口打开)
行业首个具备“高刷”视频理解能力的多模态模型MiniCPM-V 4.5的技术报告正式发布!报告提出统一的3D-Resampler架构实现高密度视频压缩、面向文档的统一OCR和知识学习范式、可控混合快速/深度思考的多模态强化学习三大技术。
共 28 篇
行业首个具备“高刷”视频理解能力的多模态模型MiniCPM-V 4.5的技术报告正式发布!报告提出统一的3D-Resampler架构实现高密度视频压缩、面向文档的统一OCR和知识学习范式、可控混合快速/深度思考的多模态强化学习三大技术。
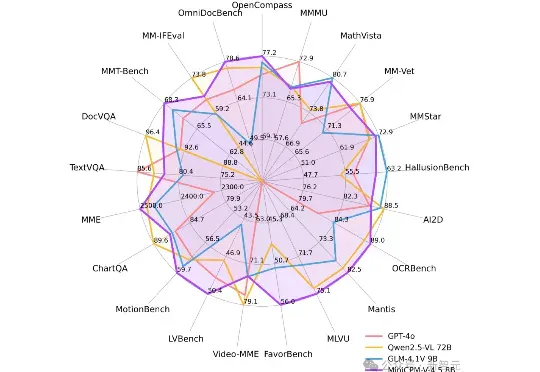
刚刚,面壁智能再放大招——MiniCPM-V 4.5多模态端侧模型横空出世:8B参数,越级反超72B巨无霸,图片、视频、OCR同级全线SOTA!不仅跑得快、看得清,还能真正落地到车机、机器人等。这一次,它不只是升级,而是刷新了端侧AI的高度。
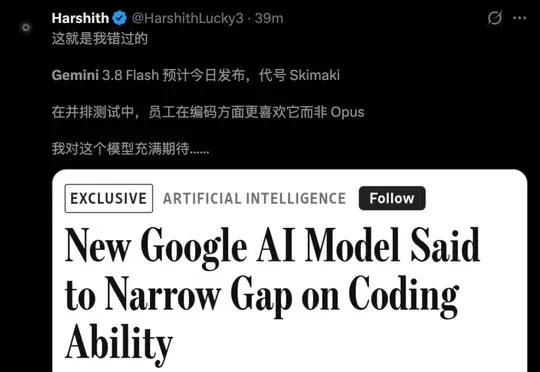
谷歌预告Gemini 3.8 Flash将于明日发布,并披露Gemini 3.7 Flash等模型已支持智能体视频理解,使Token消耗最多下降88%、成本最多下降66%、准确率最多提升7%。
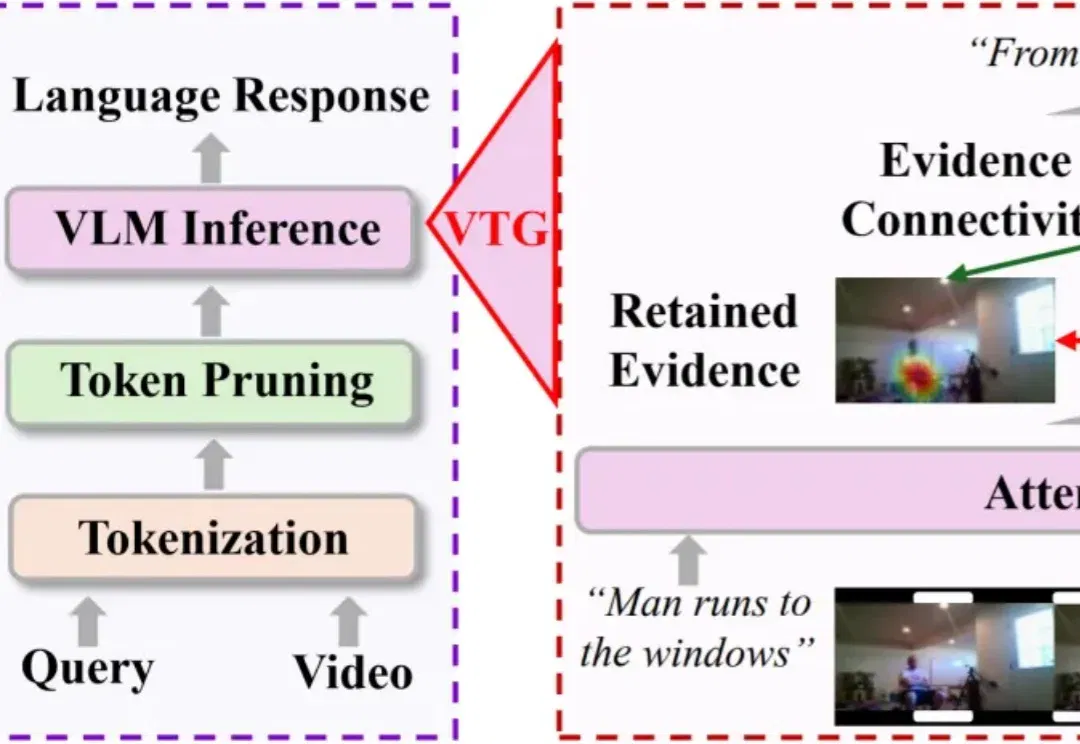
长视频理解,正在成为多模态大模型的重要能力。
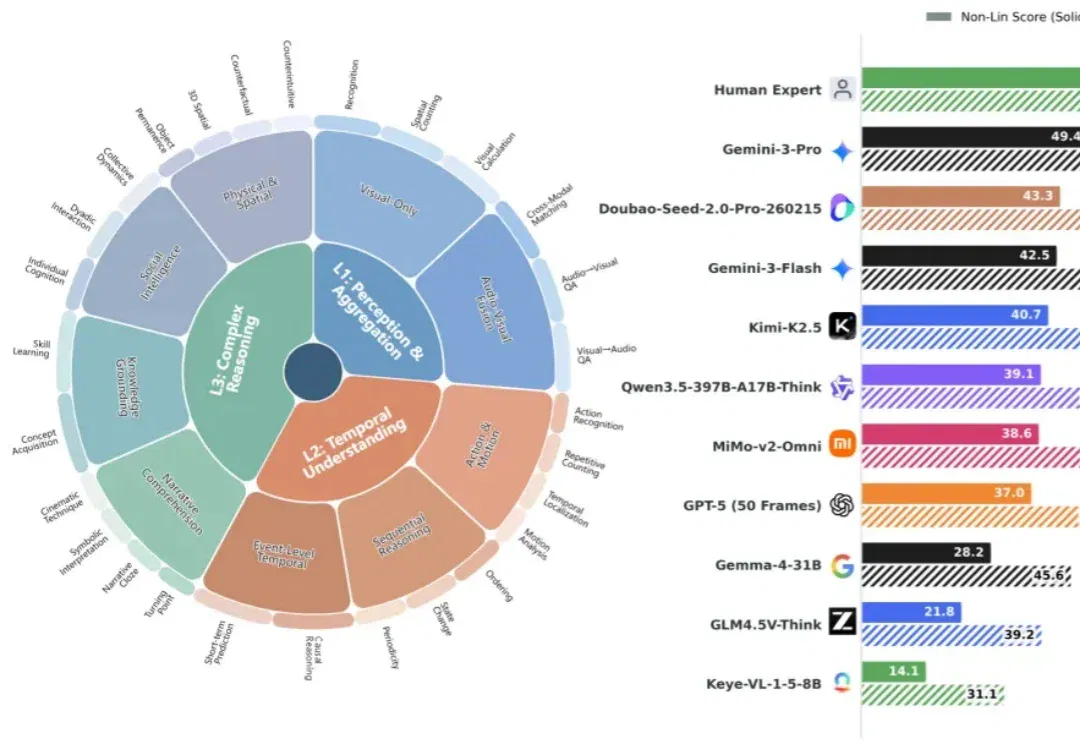
现有大模型评测分数日趋饱和,但与真实体验差距显著。南京大学傅朝友团队牵头,在 Google Gemini 评测团队邀约下推出视频理解新基准 Video-MME-v2。凭借创新的分层能力体系与组级非线性评分,以及 3300 + 人工时高质量标注,揭示模型与人类的巨大鸿沟(49 vs 90)、传统 Acc 指标虚高、以及 “Thinking” 并非总是增益等现象。
现有大模型评测分数日趋饱和,但与真实体验差距显著。南京大学傅朝友团队牵头,在Google Gemini评测团队邀约下推出视频理解新基准Video-MME-v2。凭借创新的分层能力体系与组级非线性评分,以及3300+人工时高质量标注,揭示模型与人类的巨大鸿沟(49vs90)、传统Acc指标虚高、以及「Thinking」并非总是增益等现象。
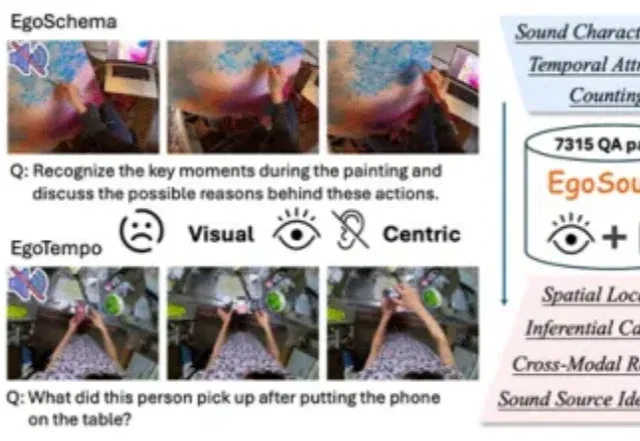
多模态大模型掉进真实世界,会“失聪”。 你把它放在厨房:背后有人说话、金属碰撞、蒸汽嘶嘶——画面里啥也没有,但声音已经把关键信息全透露了。此时最强模型也开始“失灵”:看得懂动作,听不懂发生了什么;能描述现象,推不出原因。 问题不是模型不会“看”,而是还不会真正“听”。 声音,从来不是配角 而在人类的日常认知里,声音从来不是配角: 它提供空间线索(声源左/右、远/近、是否移动)它揭示画面外事件(镜头外的对话、敲门、摔落、报警)它承载因果与意图(某个动作触发了某个声音;某个声音提示下一步行为) 但长期以来,第一人称视频理解基准高度“视觉中心化”:音频存在,但缺乏系统评测;听觉重要,却很少被认真考察
Meta联合多所高校发布首个可规模化自动生成第一视角音视频理解数据的引擎EgoAVU ,让多模态大模型首次真正「听懂世界」。