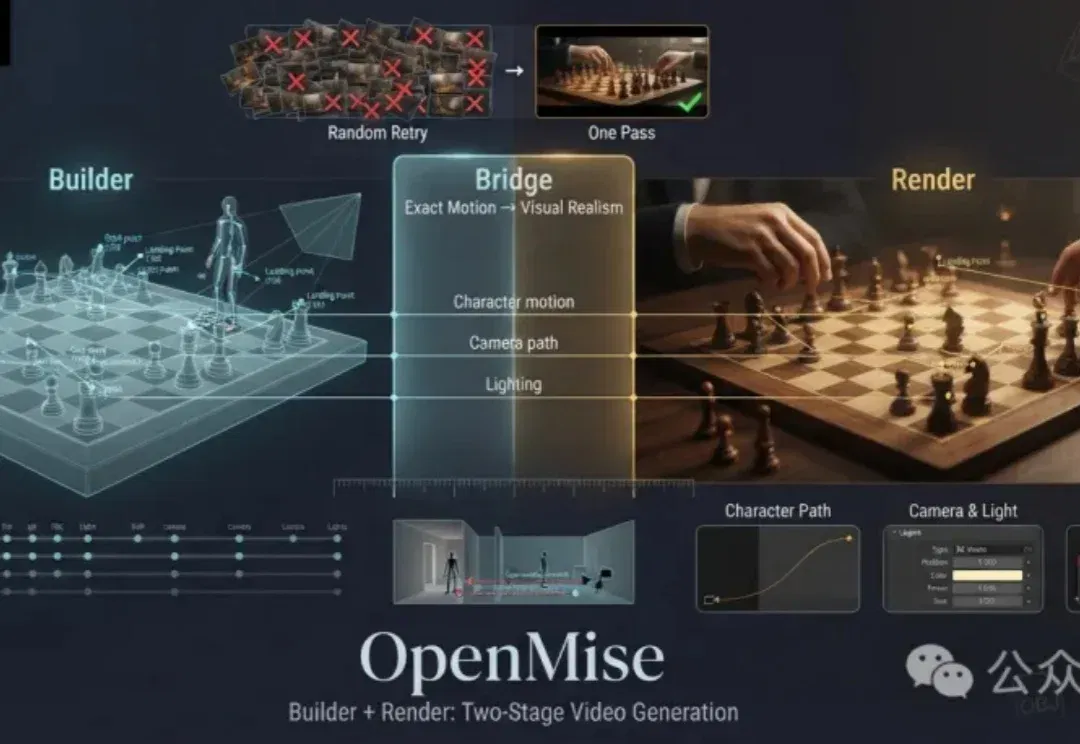
OpenMise 先用 Blender 编排三维草稿,再交给视频模型渲染(在新窗口打开)
项目把场景、角色路径、摄影机和灯光放进同一时间轴,用可编辑的白模检查动作,再将草稿交给视频模型生成写实画面。
共 109 篇
项目把场景、角色路径、摄影机和灯光放进同一时间轴,用可编辑的白模检查动作,再将草稿交给视频模型生成写实画面。
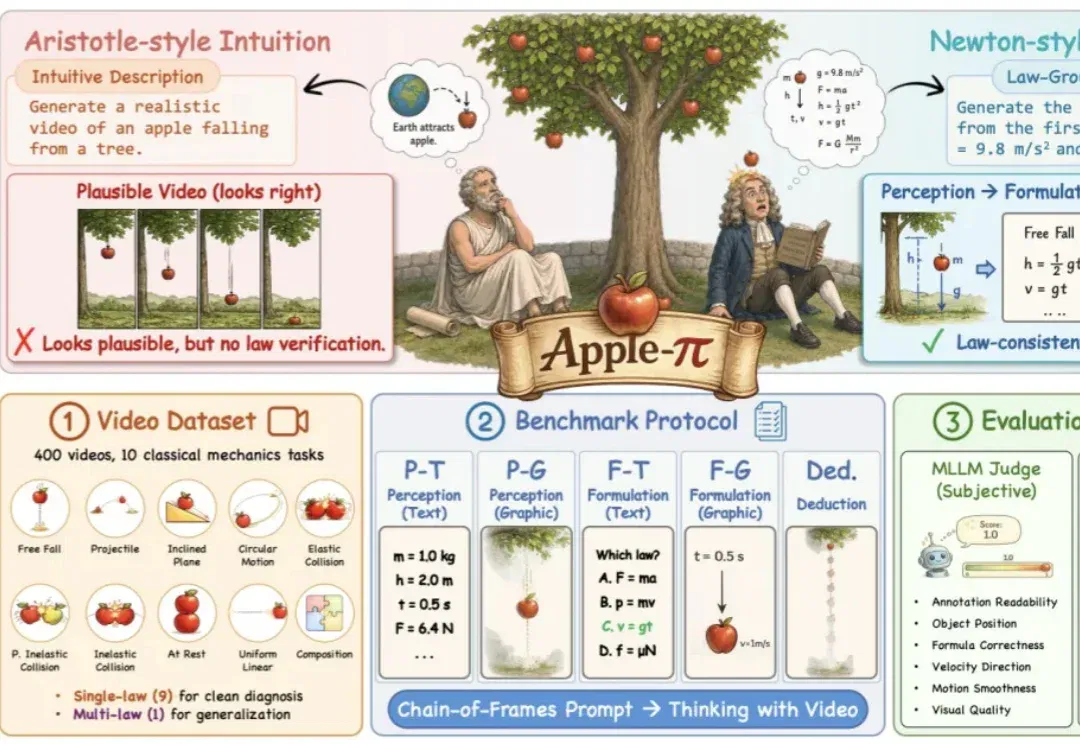
一个苹果从树上落下,今天的视频模型大多能生成一段「看起来正确」的运动:苹果向下、速度加快,最终落地。
Jim Fan 在红杉资本 AI Ascent 最新观点,信息量极大,机器人物理AI很快就会迎来突破,答案就在视频模型,路径就是LLM的突破路径,Jim Fan把机器人的未来路线图比作文明游戏里的科技树,还剩三个成就要解锁,2040年就是终局
初创公司 Xmax AI 推出的首个虚实融合的实时交互视频模型 X1,没有复杂的 Prompt,不需要漫长的渲染等待,只需要手势进行交互,就可以让虚拟世界与现实相连,在镜头中令「幻想」成真,让用户体验到实时交互的心流体验。
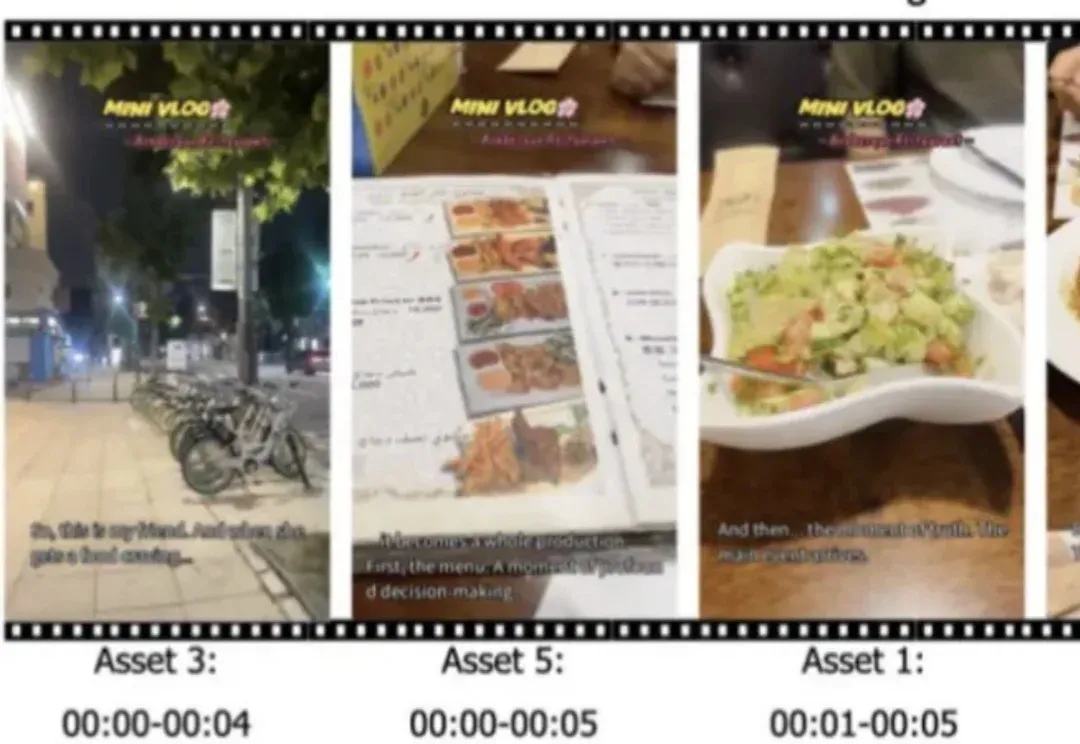
字节新视频模型Vidi2,理解能力超过了Gemini 3 Pro。
可灵正式发布了他们的 2.5 Turbo (app.klingai.com)版本视频模型,作为超创提前试了一下,这次的进步真的很大。
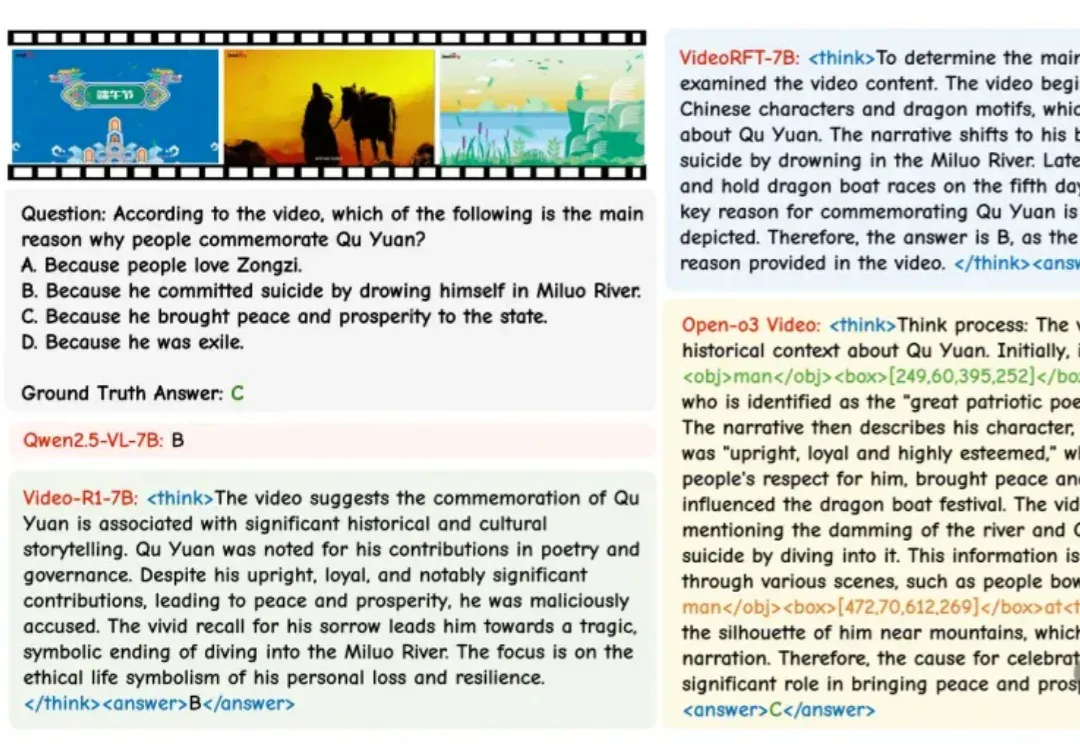
AI看视频也能划重点了! 不仅能回答“是什么”、“发生了什么”,还能指出是在“何时何地”发生。 来自北大和字节的联合团队,推出了首个将显式时空证据嵌入视频推理全过程的开源模型——Open-o3 Video,让AI不仅能答对问题,也能在思维过程中同步直观标出具体位置,真正实现有迹可循的视频推理。 △Open-o3 Video的能力 同时,模型采用non-agent架构,避免了复杂的工具调用和多轮推理,一次回复中直接完成“看—想—证—答”的闭环。 在多个视频推理测试中,关键指标可提升至24.2%,性能表现超越GPT-4o和Gemini-2-Flash等一众闭源模型。 下面是更多详细内容。 研究背景
蚂蚁灵波选择了后一条路:开源 LingBot-Video。这是一个面向具身智能的视频生成基座模型,也是一套专为机器人场景设计的 DiT 视频预训练范式。通用视频模型更多学习画面变化、镜头运动和视觉风格;LingBot-Video 则把重点放在动作、任务、交互和物理环境变化上,面向世界预测、动作理解和机器人训练构建视频生成基座。
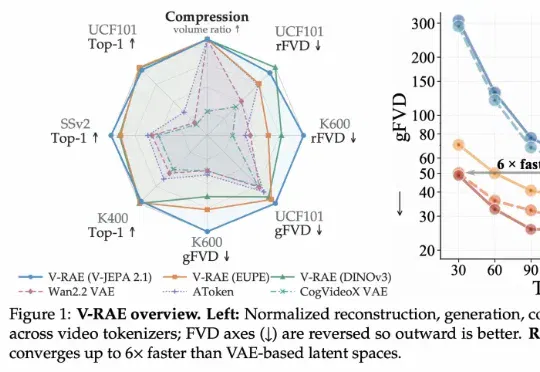
近日,新加坡国立大学 Minghui Guo 与牛津大学 Shengqiong Wu、Hao Fei 在论文《V-RAE: Rethinking Video Latent Spaces for Generation》中提出视频表征自编码器 V-RAE。该方法以冻结的视觉基础模型为编码器,通过轻量级时间池化压缩视频特征,并将具有丰富语义和时间连续性的表征直接用于视频重建、生成与未来预测。
把你的想象拍成影片。 这两年,AI视频模型的进步已经很直观。几秒钟的画面可以做得很好,人物动作和镜头运动也越来越自然。 可一条作品只要达到几分钟,创作者面对的事情就会明显变多,有时候一个镜头生成得不错,并不代表接下来的几十个镜头都能顺利衔接。 十分钟左右的视频,往往要处理很多彼此关联的素材,已经确定的人物设定需要贯穿整条视频,中途改了剧情,相关片段也得重新处理。 腾讯混元最近公开的HyCreator,做的就是让Agent接手这些长时间的工作。 官方把它定义为一套面向长视频生成的Agent Harness。 用户先给出故事设定,HyCreator会继续处理脚本和分镜,再调用视频生成能力完成整套制