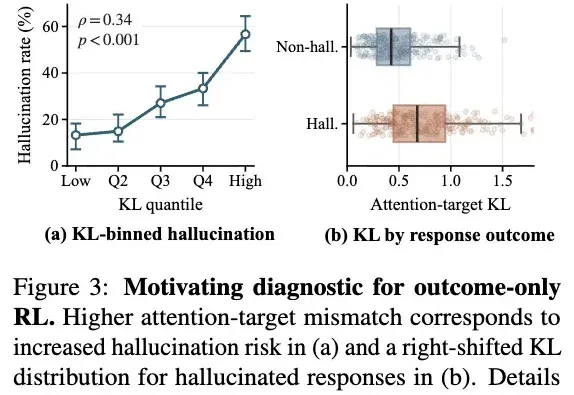
答对了却没看图?EASE给多模态RLVR装上「视线校正器」(在新窗口打开)
强化学习与可验证奖励(RLVR)已成为提升视觉语言模型(VLM)推理能力的标配手段。但一个隐蔽的问题始终存在:最终答案的奖励信号,只告诉模型「答对了没有」,却从不告诉它「答案应该从图像的哪个区域得出」。答对,可能是因为真的看懂了图,也可能只是语言先验的捷径、数据集的偏差,甚至是一次幸运的瞎猜。
共 38 篇
强化学习与可验证奖励(RLVR)已成为提升视觉语言模型(VLM)推理能力的标配手段。但一个隐蔽的问题始终存在:最终答案的奖励信号,只告诉模型「答对了没有」,却从不告诉它「答案应该从图像的哪个区域得出」。答对,可能是因为真的看懂了图,也可能只是语言先验的捷径、数据集的偏差,甚至是一次幸运的瞎猜。
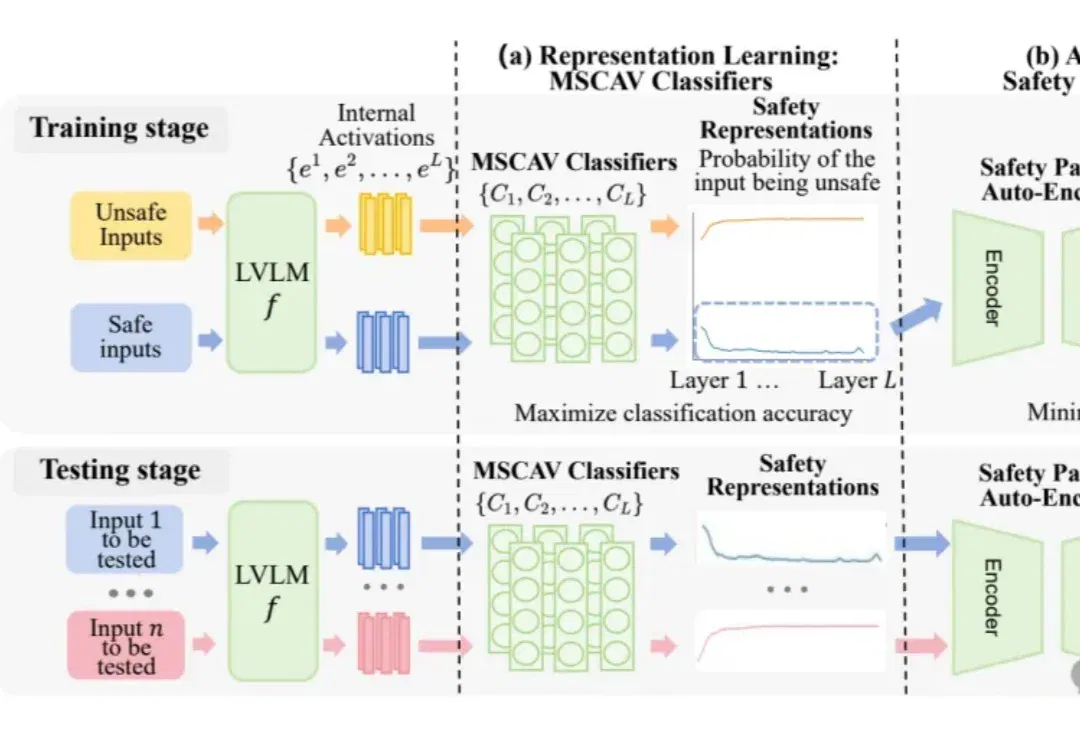
大视觉语言模型(LVLM)把语言理解扩展到了图像等多模态输入,同时,也带来了更隐蔽的攻击面。
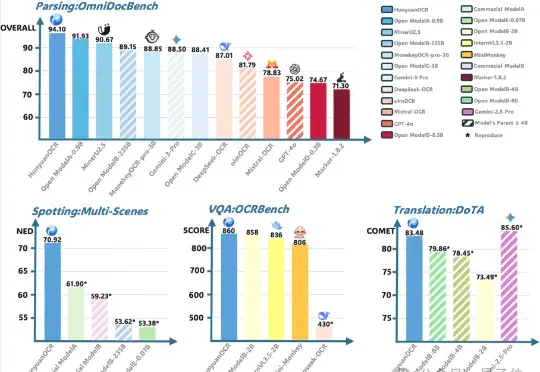
腾讯混元大模型团队正式发布并开源HunyuanOCR模型!这是一款商业级、开源且轻量(1B参数)的OCR专用视觉语言模型,模型采用原生ViT和轻量LLM结合的架构。目前,该模型在抱抱脸(Hugging Face)趋势榜排名前四,GitHub标星超过700,并在Day 0被vllm官方团队接入。
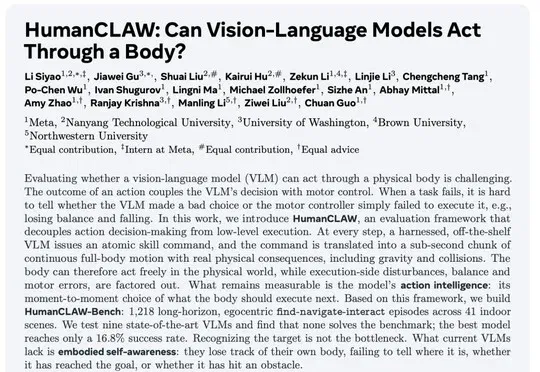
Meta联合南洋理工大学等多所高校全开源HumanCLAW基准,将高层行动决策与低层运动控制分离以单独测量视觉语言模型的行动智能,九个前沿模型完整交互成功率仅16.8%,揭示出当前基础模型缺乏持续维护自身身体状态估计的具身自我感知缺口。
豆包大模型2.1 Pro正式发布。但字节这次没有像某些厂商那样疯狂堆参数、刷榜单,而是把刀锋对准了一个更硬核的方向:让AI真正能“干活” 。作为本次大会发布的主力模型,豆包2.1 Pro 在 Coding(编程)、Agent(智能体)、VLM(视觉语言模型)三大核心方向实现能力跃升,多项评测表现优于Claude Opus 4.6
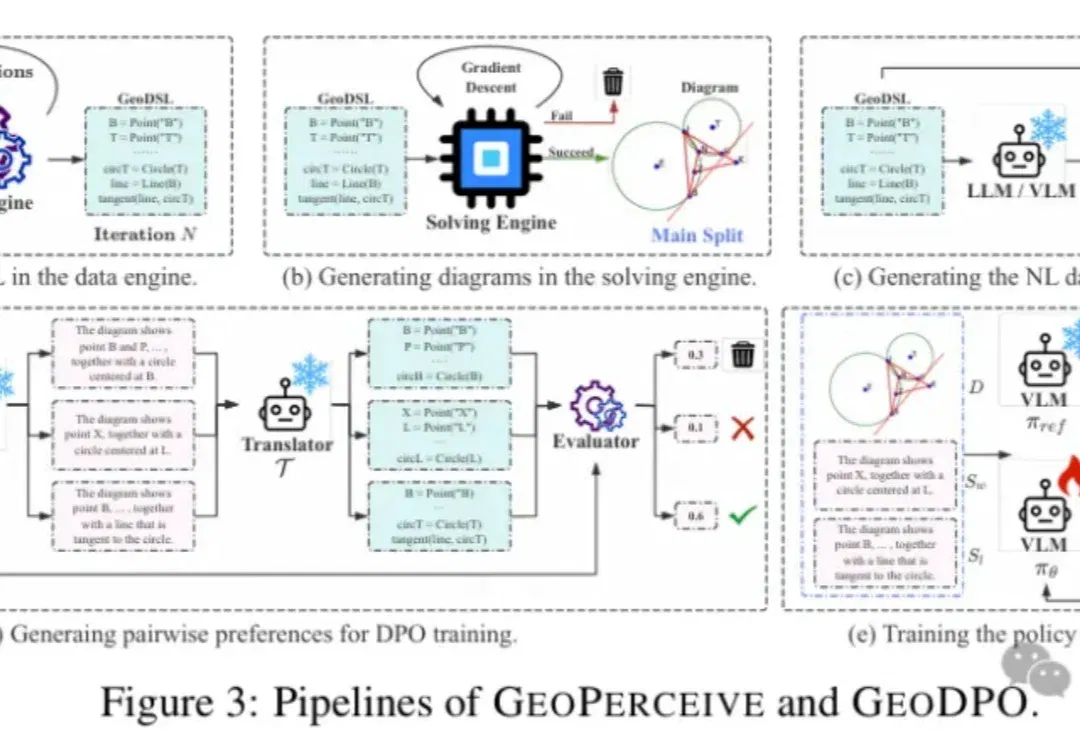
几何问题,真的只是“推理难”吗? 近年来,视觉语言模型(VLMs)在图文问答、表格理解、数学应用题等多模态任务上取得了显著进展。 但当问题变成几何图形时,它们的表现却往往明显下降。 为什么? 近日,来自光明实验室与清华大学的研究团队深入剖析了多个主流模型的错误案例,观察到一个值得关注的现象: 当前VLM在几何问题上的失败,很大程度上暴露出其几何感知错误(perceptual errors)的短板,而这一核心因素在现有研究中往往未被单独系统分析。 换句话说,在不少情况下,模型并不是不会推理,而是在更早阶段——对图形结构的识别已经出现偏差。 常见问题包括: 错误识别几何基本元素(点、线、圆)漏检关
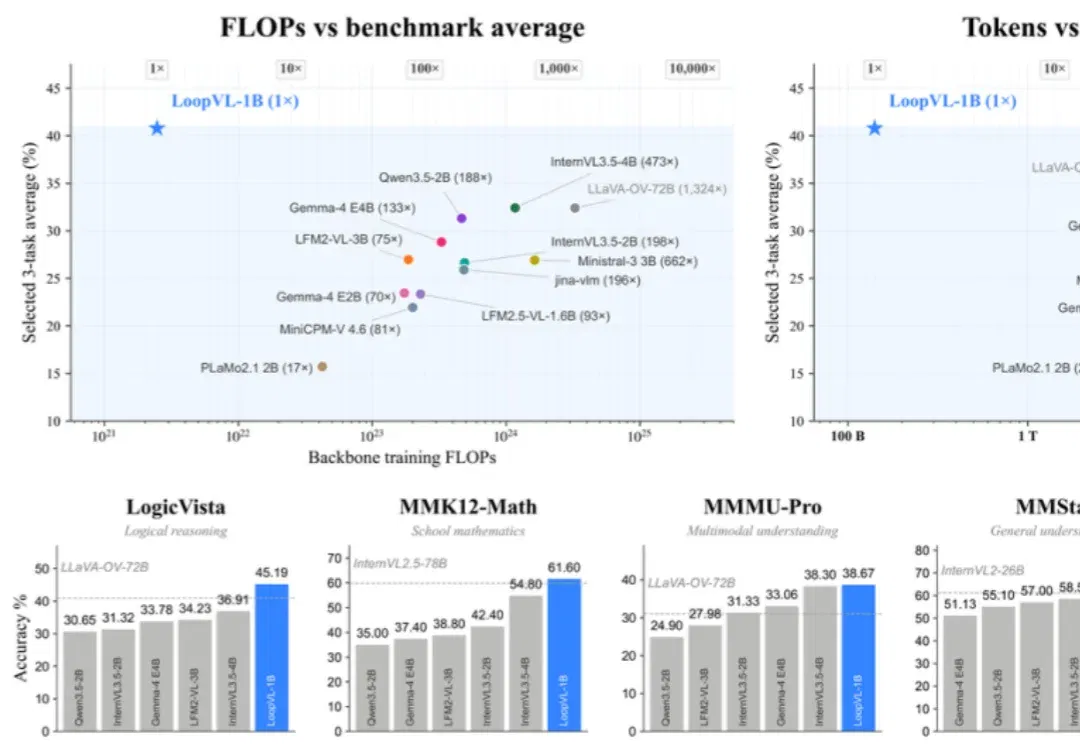
近年来,Loop Transformer 逐渐从简单的模块复用走向更复杂的分层循环计算,探索如何通过共享参数持续更新模型状态。一个自然的问题是:当模型开始看图,这套机制还成立吗?
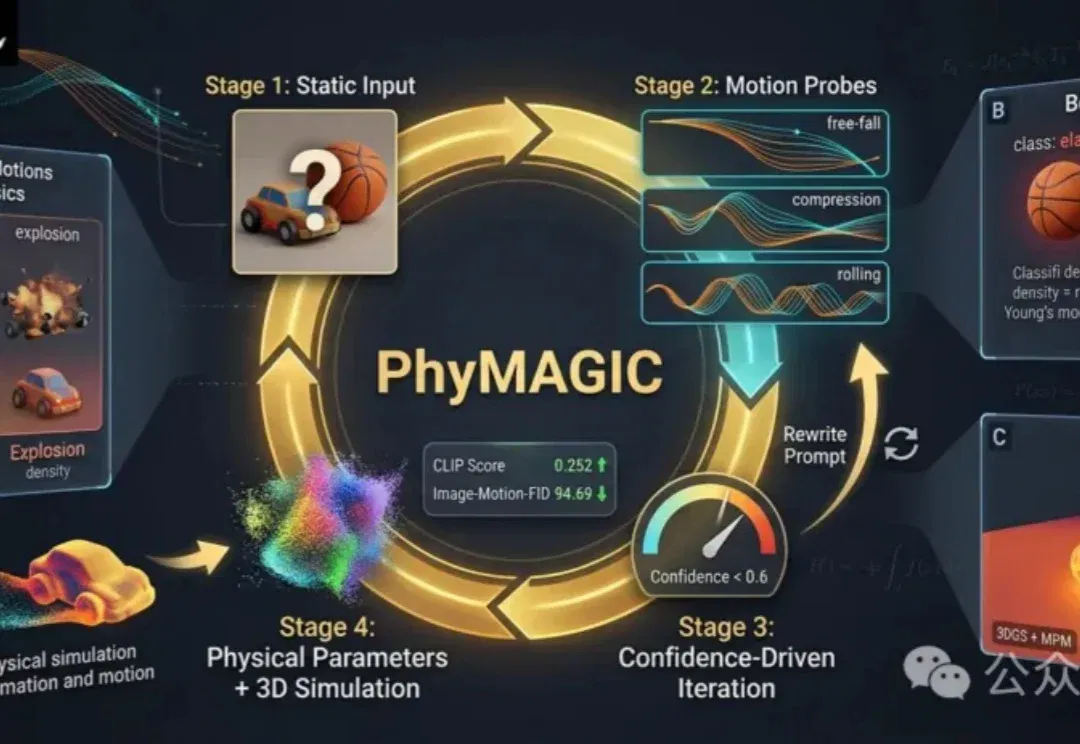
PhyMAGIC通过让物体动起来,从视频中提取物理证据,帮助准确推断材料属性。它结合图生视频与视觉语言模型,生成针对性运动探针,并不断修正物理参数,最终构建出可微分的3D动态模型,实现更符合现实的视频生成。
研究团队将 Mac mini、视觉语言模型与 Unitree G1 组合,在 360 次测试中报告 91% 成功率,多步骤组合任务约为七成。
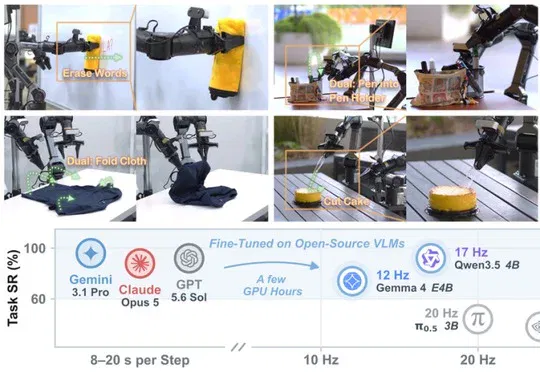
新加坡国立大学 Show Lab 发布的 Show-Harness 通过一套可被 VLM 理解的语义动作接口,使前沿视觉语言模型和轻量微调的 Qwen3.5-2B 能够跨模型、跨机器人本体直接操控真实机器人,并在跨任务、跨环境、跨本体实验中取得显著高于基线的成功率。